Le 28 septembre, j’ai publié ai-running-coach, neuf jours après. J’y couvrais tout jusqu’à la PR #122 : le tableau de bord, les métriques trail, les garde-fous et le coach dans la poche grâce à Claude Code Remote Control.
Cinq jours plus tard, le dépôt compte 27 pull requests mergées de plus (de la #123 à la #162), 88 commits et environ 64 000 nouvelles lignes, en grande partie des tests et de la documentation. Cet article les passe en revue une par une : à quoi elles servent, et comment elles marchent sous le capot.
Un mot sur les captures. Je les ai toutes faites pour cet article, sur une vraie instance de l’appli qui tourne dans un bac à sable. Comme je ne voulais pas publier mes propres données de santé, l’instance utilise le workspace de démo du projet : « Camille », un profil d’athlète fictif qui prépare un trail de 42 km, généré par le même code que celui des tests. Le tableau de bord est donc dans sa langue par défaut, le français. Le bac à sable n’avait pas accès aux serveurs de tuiles cartographiques, donc la carte GPS plus bas est affichée dans le mode hors ligne de l’appli : la trace, sans fond de carte.
0. Commencer par la vidéo#
Le plus simple pour découvrir le projet, c’est la bande-annonce. Ce n’est pas un fichier vidéo : chaque image est dessinée en JavaScript sur un canvas, donc elle tourne directement dans la page :
Appuyez sur Lecture (avec le son). Vous pouvez passer la narration du français à l’anglais, activer les sous-titres, ou sauter à un chapitre depuis le profil altimétrique. L’ouvrir en pleine page ou voir tous les épisodes.
Ça s’est fait en trois étapes :
- PR #128 : une présentation de 80 secondes. Chaque image est une fonction pure
render(t)du temps écoulé, dessinée sur un canvas 16:9. Pas de fichier vidéo, pas d’étape de build. Les polices (Inter, Sora, JetBrains Mono) sont embarquées avec leurs licences OFL, donc la page ne fait aucune requête vers un service tiers. Besoin d’un MP4 ?scripts/render_video.pyle génère image par image avec Chrome headless et ffmpeg. - PR #157 : « Le Sentier », une série de 12 épisodes narrés plus une bande-annonce. Un épisode par fonctionnalité, à mi-chemin entre la démo et la documentation, et chacun est mis en scène comme un trail. Un dossard ouvre l’épisode, les chapitres sont des ravitos sur lesquels on clique dans un profil altimétrique, et une arche d’arrivée renvoie vers la page de documentation correspondante. Tous les épisodes partagent le même moteur (lecteur, chapitres, sous-titres, fonctions de dessin). La narration est générée hors ligne à partir d’un script, avec un lexique de prononciation (API) pour que la voix prononce correctement « HRV » et « /today », et les sous-titres WebVTT sont générés en même temps. Les captures dans les épisodes sont de vraies captures du tableau de bord sur le workspace de démo (31 en tout), et les scènes de chat rejouent une conversation scénarisée via un backend bouchon : aucun LLM n’est appelé.
- PR #161 : de meilleures voix. La première narration utilisait Kokoro, qui tourne entièrement hors ligne mais sonnait robotique.
video_narration.pyaccepte maintenant plusieurs moteurs (kokoro,azure,edge,kyutai,chatterbox), et la série a été renarrée avec les voix neuronales multilingues de Microsoft (Remy en français, Andrew en anglais).
Pour répondre à la question évidente : oui, comme c’est du HTML et du JavaScript et pas un fichier vidéo, je peux intégrer le lecteur directement dans l’article avec une iframe qui pointe vers le site de documentation du projet. Il reste synchronisé avec la doc : quand un épisode y est mis à jour, cette page affiche la nouvelle version.
1. Parler au coach depuis le tableau de bord#
Dans le dernier article, j’expliquais pourquoi mon téléphone parle au coach via Remote Control : un front maison ne peut pas utiliser un abonnement Claude Pro/Max. C’est toujours vrai. Mais parfois, j’ai juste envie de taper une question dans le tableau de bord que j’ai déjà ouvert. Il y a donc maintenant une page Coach dans le tableau de bord (PR #130, la plus grosse de la série avec environ 15 000 lignes).
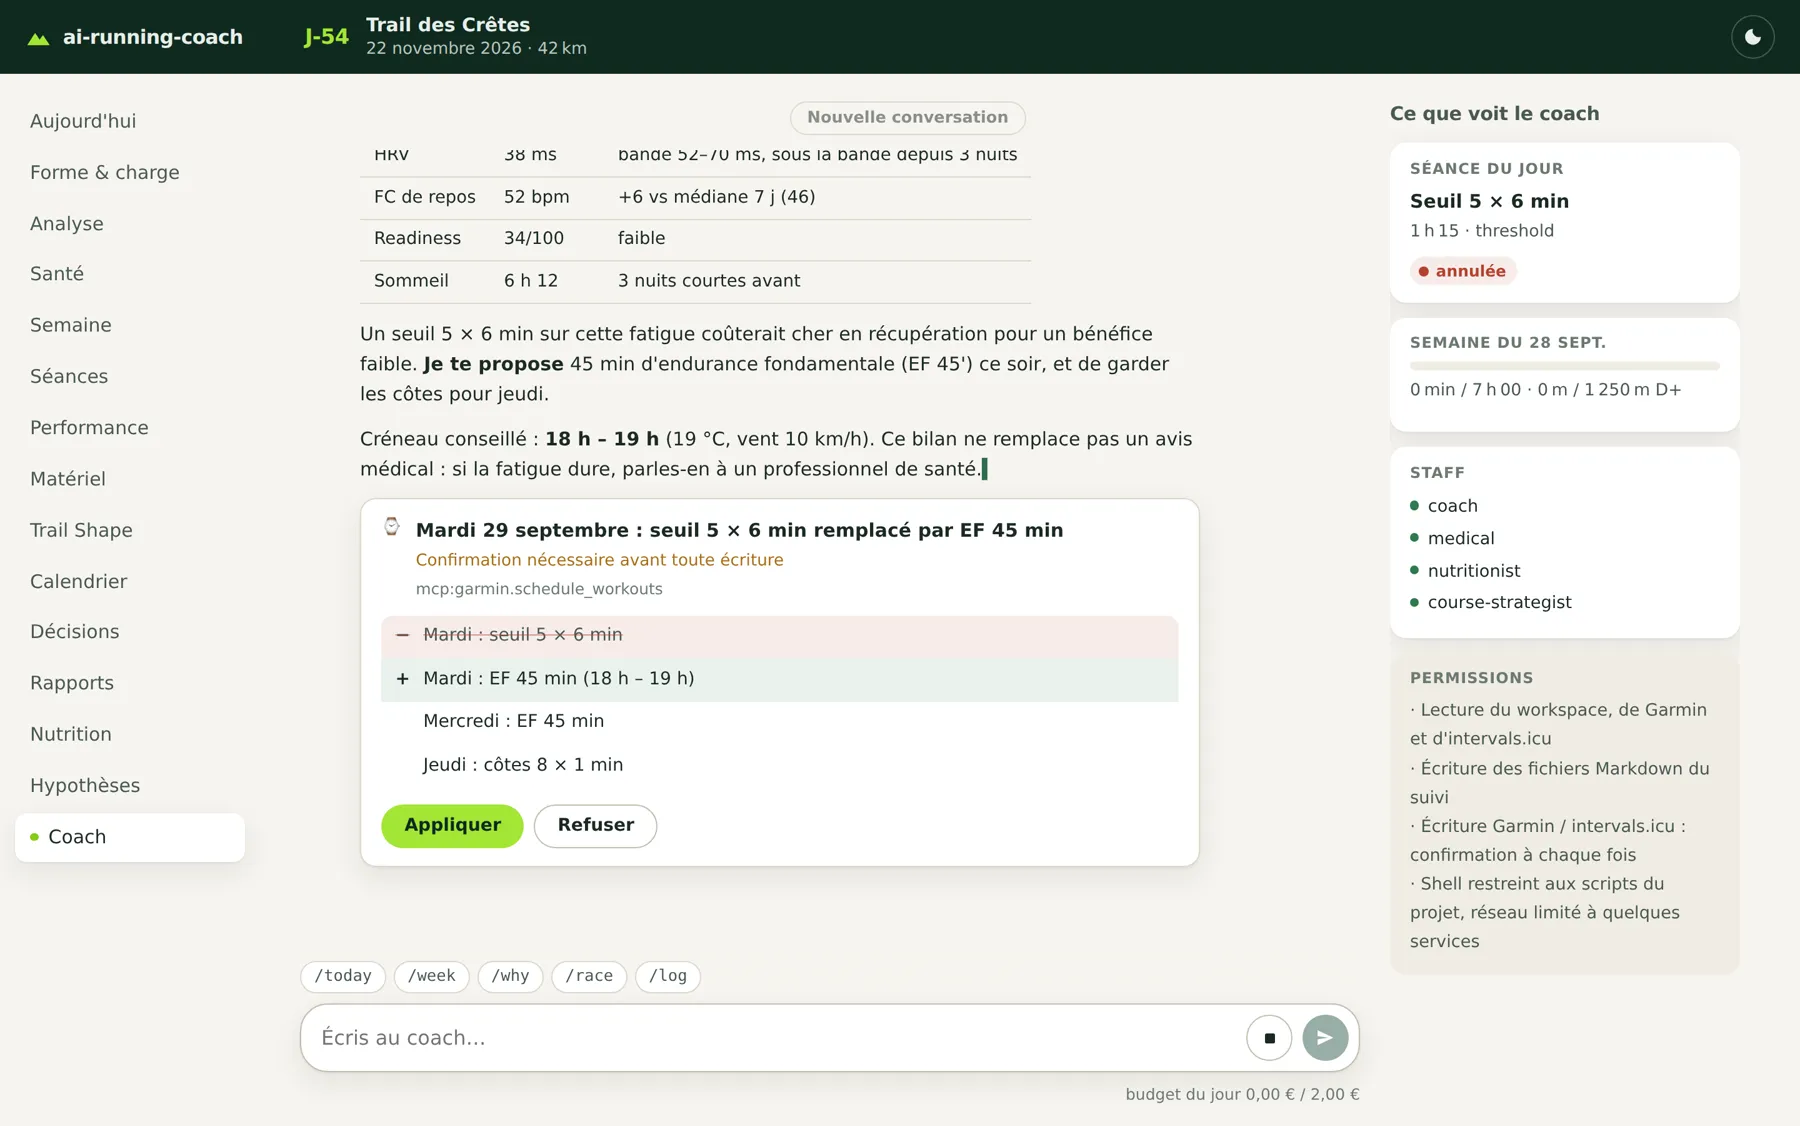
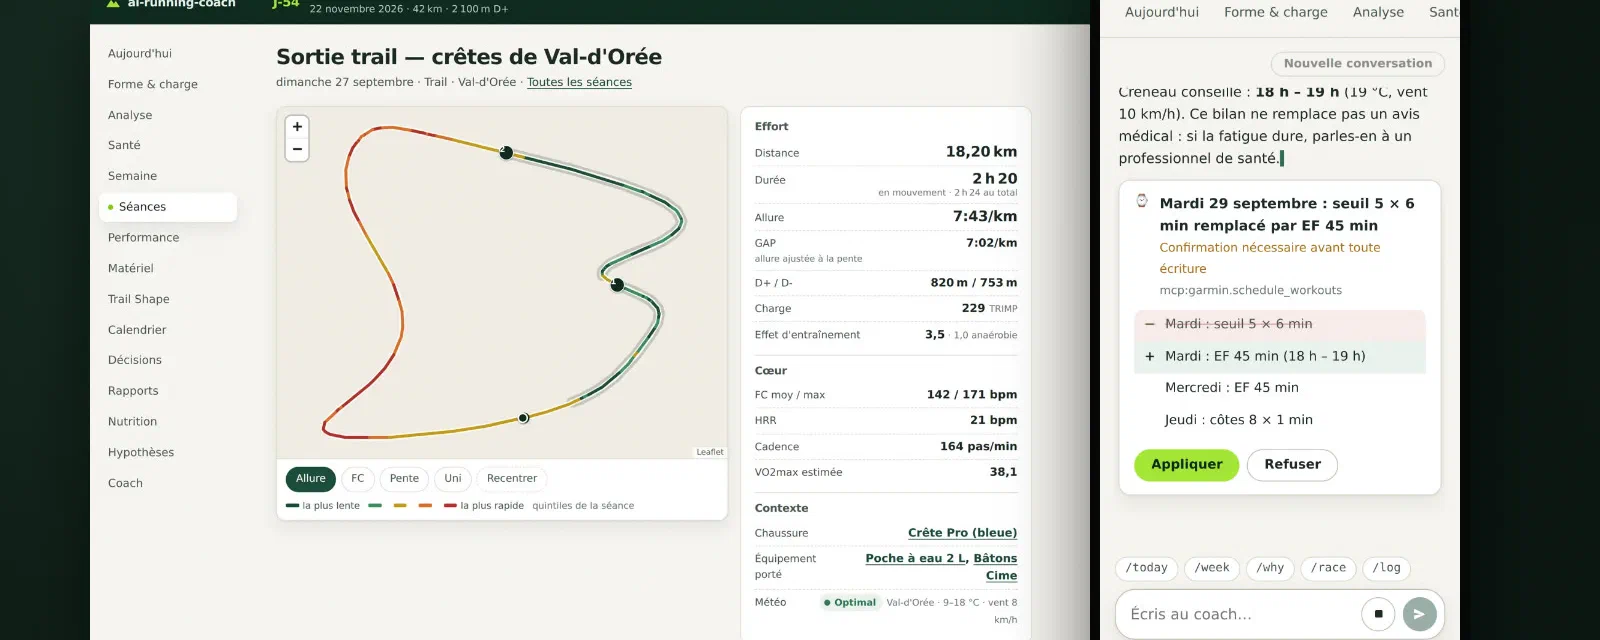
L’athlète dit manquer d’énergie avant une séance au seuil. Le coach vérifie la HRV, la FC de repos, la readiness et la météo, propose de remplacer la séance, et attend. Rien n’est écrit dans Garmin tant qu’on n’a pas appuyé sur « Appliquer ».
Comment ça marche :
- C’est un service à part. Le tableau de bord reste en lecture seule et ne voit jamais de clé API. Un processus dédié,
scripts/arc_chat.py, tourne sur la machine coach et c’est la seule brique qui écrit dans le workspace. - Les mêmes agents, les mêmes fichiers. Il utilise les mêmes agents, skills, serveur MCP Garmin et fichiers Markdown qu’une session dans l’IDE. Le chat n’ajoute pas de nouvelle source de vérité.
- Deux backends. On peut utiliser le Claude Agent SDK (le moteur de Claude Code, modèle par défaut
claude-sonnet-5-5) ou un serveur OpenCode avec n’importe quelle API compatible OpenAI, OpenRouter par exemple. - Toute écriture dans Garmin ou Intervals.icu passe par votre accord. Une carte affiche l’avant/après et vous acceptez ou refusez, sur la page ou depuis la notification push. Une validation ne sert qu’une fois : un second appel identique affiche une nouvelle carte.
- Une politique de permissions stricte. Le shell est limité aux scripts du projet, et leurs options sont vérifiées par rapport à l’
argparsede chaque script. Un test de lint échoue si un skill appelle un script que la politique ne connaît pas, donc la politique ne peut pas s’écarter des skills. - Budget. Un compteur affiche le coût de la conversation, il y a un plafond quotidien, et chaque tour réserve son propre budget (1 € par défaut) pour qu’une validation tardive puisse quand même aboutir.
- Tout est tracé. Chaque appel d’outil apparaît dans une trace numérotée et repliable, et seule la réponse finale reste visible.
J’ai testé huit modèles sur OpenRouter, sur un vrai workspace avec Garmin en lecture seule, avec trois vraies demandes et des vérifications automatiques (/log, un bilan du matin, /week). DeepSeek v4.1 Flash est arrivé en tête : le meilleur score et le moins cher, à environ 0,80 € pour un mois typique d’utilisation. Claude Sonnet reste le plus adapté aux décisions délicates, mais il coûte plus cher (environ 30 € par mois, en estimation). La comparaison complète est dans la documentation du chat.

Sur téléphone, la page se réduit à la conversation, et la carte de validation reste à portée de pouce.
Deux suites l’ont rendu déployable en pratique : la PR #156 fait tourner le chat dans son propre conteneur à côté du tableau de bord, derrière le même Traefik avec SSO (/api/chat derrière l’authentification unique, /api/chat/approve avec un jeton, en POST uniquement et avec limitation de débit), et le /coach-doctor du projet vérifie maintenant que le service de chat est joignable et en bonne santé.
2. La page séance gagne une carte GPS#
L’ingestion des FIT stocke les coordonnées GPS depuis le début, mais rien ne les affichait. La PR #160 a reconstruit la page séance autour d’une carte :

La séance de démo : 18,2 km et 820 m de D+. La trace est colorée par quintile d’allure (on peut aussi la colorer selon la FC ou la pente), et les repères numérotés sont les montées détectées. C’est le mode hors ligne, sans fond de carte.
- La carte utilise Leaflet (embarqué dans le dépôt, pas chargé depuis un CDN) avec les tuiles OpenTopoMap. Le serveur de tuiles se configure dans
[dashboard].map_tiles. On le laisse vide pour le mode hors ligne, et seul cet hôte est ajouté à la Content-Security-Policy. - La trace peut être colorée selon l’allure, la FC ou la pente, et les montées sont mises en évidence.
- Un profil altitude / FC / allure / cadence se trouve sous la carte, relié à elle par un curseur commun : on se déplace sur le profil et le marqueur bouge sur la carte.
- Une nouvelle route,
/api/activity/<id>/track, est la seule API qui expose des coordonnées. Tout le reste reste sans localisation. - La page montre aussi le ressenti de la séance (RPE, glucides, boisson, les douleurs signalées ce jour-là), la dynamique de course, le matériel utilisé, et le bloc énergie décrit dans la section suivante.

3. Un second avis sur les calories#
Garmin donne un chiffre de calories pour chaque séance. C’est une estimation, et quand le capteur cardio optique déraille, elle peut être très loin du compte. La PR #123 ajoute un modèle énergétique indépendant, construit en cinq étapes :
- Le moteur (
scripts/arc_energy.py, des fonctions pures). En course, il utilise l’équation RE3 (Looney, Hoogkamer & Kram, 2025), qui donne la puissance métabolique à partir de la vitesse et de la pente. En marche, il utilise le polynôme de marche de Minetti (2002). À l’arrêt, il ne compte que le métabolisme debout. Il intègre échantillon par échantillon sur les données FIT normalisées et ne comble jamais un trou. Validé sur 7 vraies séances : à ±0,6 % du calcul de référence, et 3 à 6 % au-dessus de Garmin. - L’indexation. Une table dérivée
activity_energy, construite pour la course, le trail, la randonnée et la marche. Le poids est déterminé à la date de la séance (fichier santé, puis nutrition, puis profil), et chaque échec est signalé avec une raison explicite (no_weight,no_samples…). - Les plans de course. Le stratège de course estime maintenant l’énergie par tronçon du parcours (kcal, kcal/h, cumul), avec votre poids le jour J plus le poids du sac, et la met en regard du ravitaillement prévu.
- Le tableau de bord. Chaque séance affiche Garmin face au modèle, l’écart et une ventilation (plat / montée / descente / marche / arrêt). La vue Analyse suit l’écart dans le temps :

- L’étalonnage personnel. Dès qu’il y a au moins 15 séances dans une catégorie route ou trail (sur 26 semaines), le projet calcule le ratio médian Garmin/modèle. Le facteur est borné entre 0,8 et 1,2, et il ne s’applique qu’aux prévisions, jamais aux séances passées.
La règle à laquelle je tiens le plus : Garmin reste la référence partout (nutrition, rapports). Le modèle ne sert que de contrôle (un écart de plus de 15 % signale en général un capteur cardio défaillant ou une séance étiquetée avec le mauvais sport) et d’outil de prévision pour une course qui n’a pas encore eu lieu. Après chaque séance, le coach ajoute une ligne du genre « Énergie : Garmin 1 420 · modèle 1 167 (−17,8 %) » et propose des causes plausibles quand l’écart est grand.

4. Un casier à matériel : chaussures, équipement, synchro Garmin et inspections sur photos#
C’est la plus grosse nouveauté de la semaine. Elle est arrivée en sept PR, une par issue GitHub.
Des chaussures avec un vrai historique (PR #136). Dans votre profil, une paire peut maintenant avoir un kilométrage de départ (départ 120 km, pour des chaussures achetées d’occasion ou déjà utilisées avant de démarrer le projet). Le coach prévoit quand la mettre à la retraite d’après l’usage des 28 derniers jours, signale les paires proches de leur seuil, n’envoie l’alerte de dépassement du seuil qu’une seule fois (identifiée par la séance qui l’a franchi, donc une re-synchro ne la répète pas), et suggère quelle paire chausser dès que vous en avez deux ou plus en rotation.
Synchro du matériel Garmin (PR #137). Garmin Connect sait déjà quelles chaussures vous portiez. Le coach le lit maintenant avec get_gear et get_activity_gear. Associer une paire à une séance sur Garmin (add_gear_to_activity) est une écriture, donc il demande toujours une confirmation avant. Quand vos notes et Garmin ne sont pas d’accord, c’est ce que vous avez écrit qui gagne.
Rattraper l’historique (PR #146). scripts/garmin_gear_backfill.py fait un appel get_gear_activities par paire pour attribuer tout votre historique aux bonnes chaussures. Il tourne à blanc par défaut : rien ne change sans --apply. Il est idempotent et ne compte jamais deux fois le kilométrage de départ.
Pas que des chaussures (PR #140). Une nouvelle section ### Matériel couvre les bâtons, gilets de course, flasques souples, frontales, ceintures cardio, vestes… Chaque élément peut avoir des déclencheurs typés : km, heures, séances, jours, semaines, mois. On peut regrouper des éléments en kits (kit « trail long »), et dire « kit trail long » après une sortie les attribue tous d’un coup. Avant une course, le stratège de course compare la liste du matériel obligatoire à votre inventaire : manquant, à vérifier (seule la catégorie correspond), jamais utilisé à l’entraînement (« rien de nouveau le jour J ») ou en alerte. Il n’invente jamais un élément.
Inspections sur photos (PR #141 et #150). Tous les ~200 km, le coach propose (il n’impose jamais) d’inspecter une paire. Vous prenez cinq photos : les deux semelles à plat, une vue de côté, une vue de derrière, la tige, et une pièce ou une règle pour l’échelle. Vous les déposez dans gear/photos/ ou vous donnez le chemin, et vous tapez /inspection. Le skill gear-inspection renvoie :
- un verdict 🟢🟡🟠🔴 expliqué visuellement (gomme et crampons, mousse, contrefort, tige) ;
- une comparaison explicite avec l’inspection précédente de la même paire, qui est le signal le plus fiable ;
- des indices sur la foulée tirés des zones d’usure (talon postéro-latéral → attaque talon, etc.), toujours formulés comme des indices et jamais comme un diagnostic ;
- une asymétrie gauche/droite mise en regard de votre historique de blessures, avec un passage de relais à l’agent médical s’il est activé ;
- un bilan de carrière quand une paire part à la retraite.
Les photos sont renommées, jamais écrasées ni supprimées. Les fichiers HEIC sont signalés comme non pris en charge au lieu d’être ignorés en silence.
Une vue dédiée (PR #148). Tout ça se retrouve dans une nouvelle vue Matériel, avec un résumé « à faire » en haut, et une page par élément (bilan de carrière, km par mois, séances, inspections).
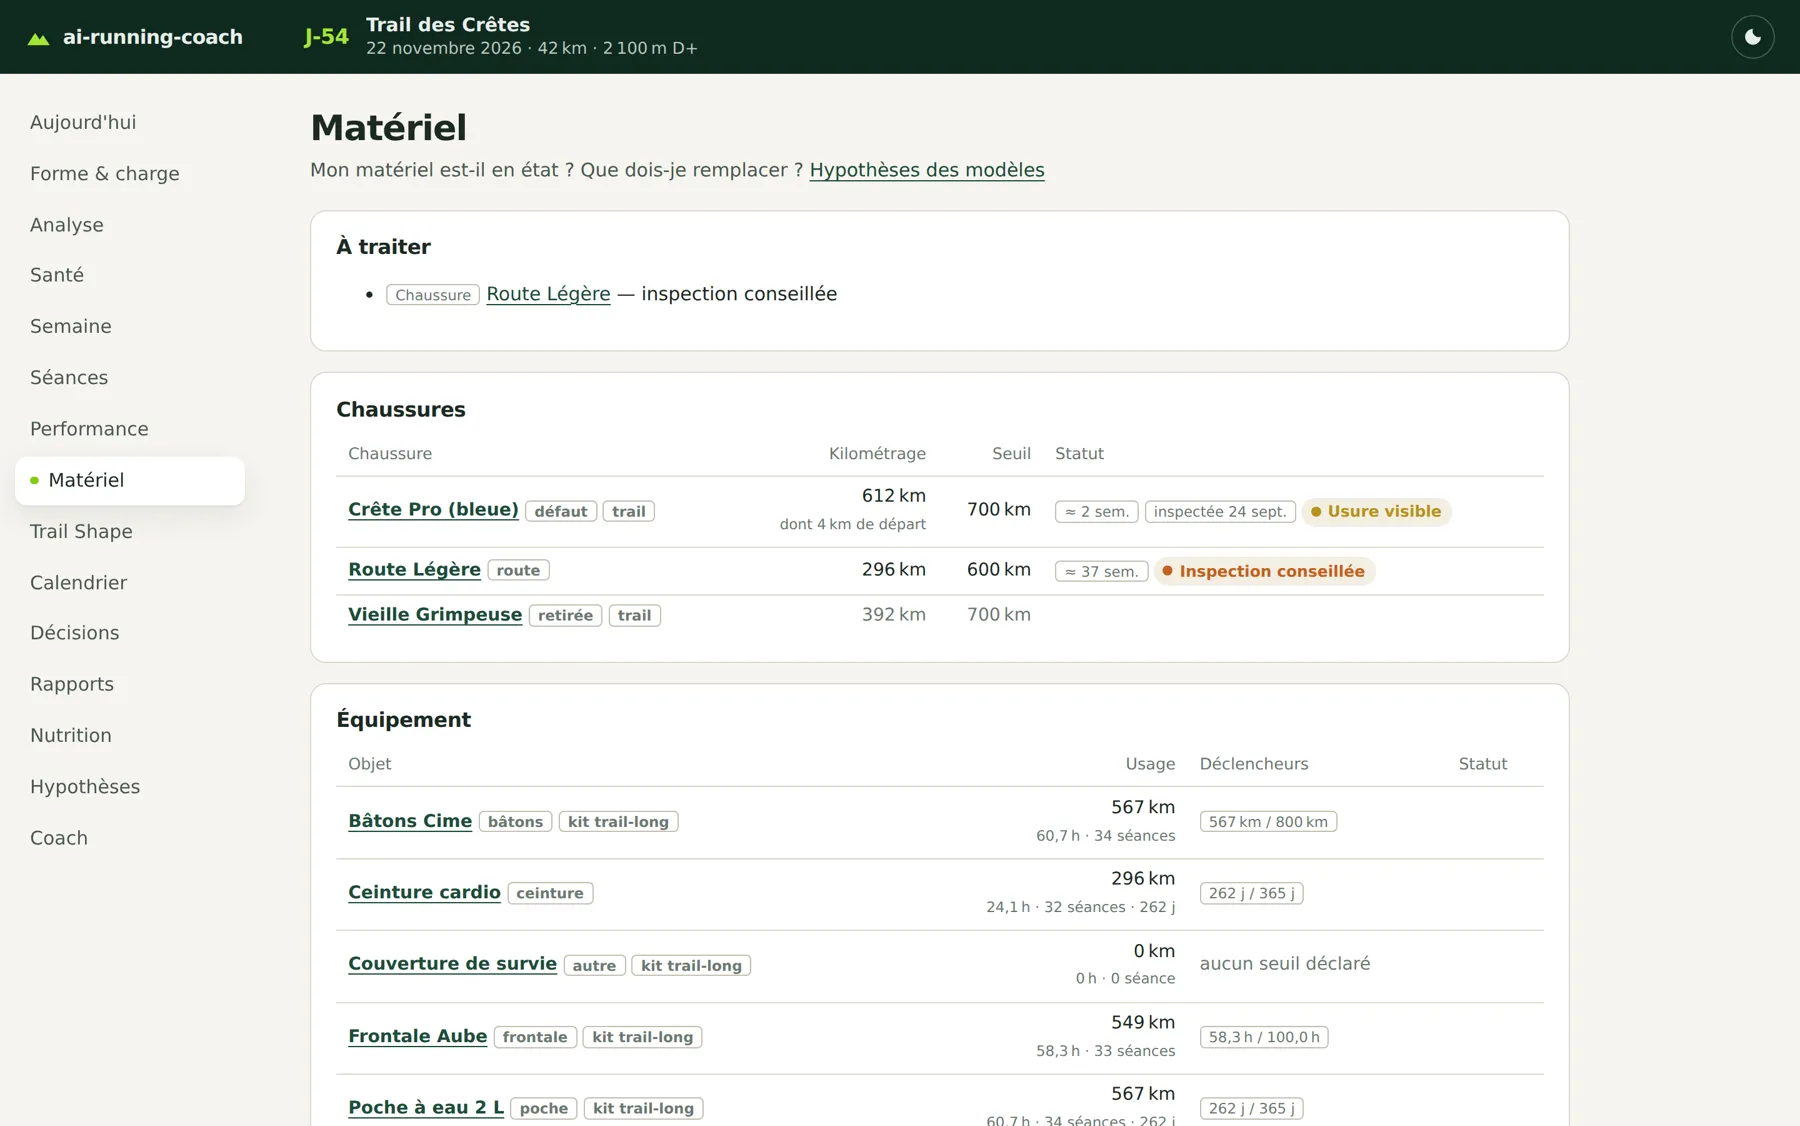
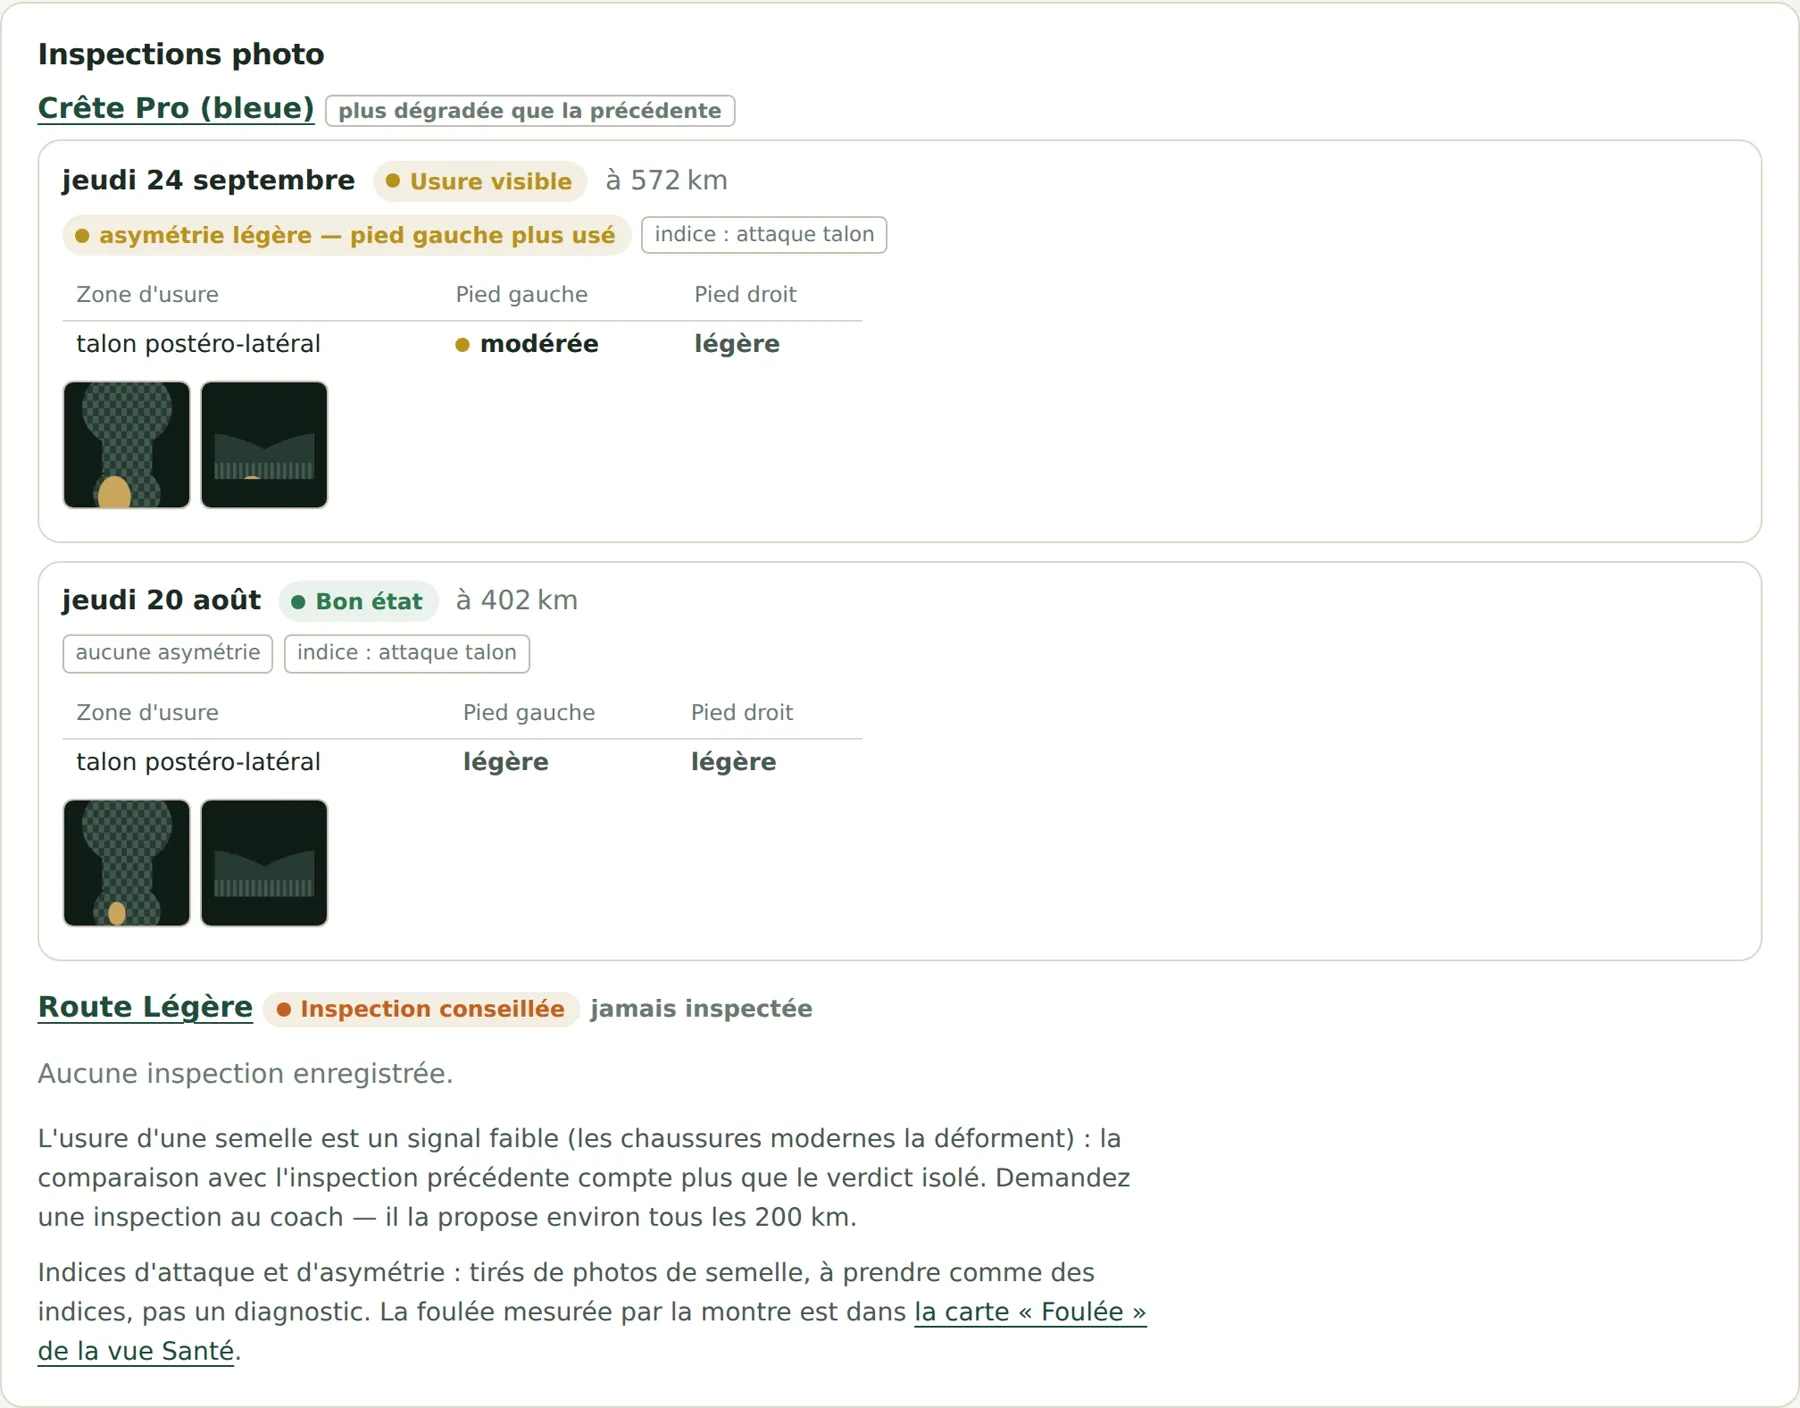
Le workspace de démo utilise des images générées, pas de vraies photos de chaussures.
5. Dynamique de course : ce que la montre mesure vs ce que les semelles suggèrent#
Si votre montre ou votre ceinture cardio enregistre la dynamique de course, les fichiers FIT contiennent le temps de contact au sol, l’équilibre du temps de contact, l’oscillation verticale, le ratio vertical et la longueur de foulée. La PR #152 les extrait (avec download_fit.py --refresh-dynamics pour relire hors ligne vos FIT existants) et ajoute une carte « Foulée » à la vue Santé :

La carte fait une chose que j’aime beaucoup : elle sépare ce qui est mesuré de ce qui est deviné. Les indices de l’inspection sur photos sont listés sous les mesures, et quand ils ne concordent pas (« usure asymétrique, mais l’équilibre mesuré est à moins de 0,6 point des 50 % »), la carte le dit et c’est la mesure qui l’emporte. Elle ne modifie jamais la charge d’entraînement ni le plan.
6. Vivre avec un long historique#
Après quelques mois, certaines pages devenaient trop longues ou trop lentes :
- Le tableau de bord était lent à la première requête (environ 5 s, et de nouveau après 30 s d’inactivité), parce que la réindexation tournait dans la requête et que chaque métrique FIT était recalculée même quand rien n’avait changé. La PR #126 a déplacé l’indexation dans un thread en arrière-plan, ajouté une empreinte pour sauter les passes sans changement et un cache par séance, plus gzip et les ETags. Sur de vraies données (694 fichiers, 118 FIT), une passe sans changement est passée de 5 s à 0,2 s, et une passe avec changements de 8,9 s à 0,44 s, avec des tables identiques à un recalcul complet.
- Séances (PR #154) : recherche par nom ou lieu (insensible aux accents), filtres par sport et par année, totaux pour le filtre en cours, regroupement par mois avec leurs propres totaux, 50 par page, et l’état conservé dans l’URL. Au passage, j’ai découvert que
/api/activitiesétait plafonné à 500 et tronquait en silence les longs historiques. Le plafond est maintenant de 10 000.

- Hypothèses : la liste des hypothèses des modèles, en bas de la page Performance, est devenue une vue à part entière, avec 94 hypothèses regroupées par modèle, un modèle à la fois, une recherche globale, et des liens contextuels depuis chaque graphique (« comment c’est calculé ? »).

7. Une deuxième personne contribue : @rdlh#
Après Giovanni la semaine dernière, une deuxième personne a envoyé des pull requests : @rdlh, qui utilise le projet avec Intervals.icu comme source de données. Ce n’est pas mon montage, et ça a fait remonter de vrais bugs :
- PR #142 : téléchargement des FIT depuis Intervals.icu. Avec
--source intervals, le coach peut maintenant télécharger et analyser les fichiers FIT aussi, donc toutes les métriques trail (GAP, découplage, VAM, durabilité) marchent sans Garmin. Un import Strava ou une saisie manuelle sans fichier FIT est signalé comme indisponible, pas comme un échec, pour que la synchro automatique ne lance pas de fausses alertes. - PR #138 : altitude bloquée à 0,0 m. Certaines montres écrivent exactement 0,0 m quand l’altimètre n’a pas de mesure, même en pleine sortie à 800 m (c’est apparu sur une Apple Watch synchronisée via Intervals.icu). Chaque bord de ces trous produisait une « montée » de plusieurs centaines de mètres en quelques secondes (plus de 100 000 m/h !), ce qui cassait le GAP et le découplage. Les séries de 0,0 m voisines d’une mesure valide à au moins 20 m sont désormais traitées comme manquantes. Un vrai 0 m au niveau de la mer est conservé.
- PR #139 : le temps en zone était surcompté. Chaque tranche de 5 secondes comptait pour 5 secondes pleines, même autour d’une pause ou en fin de sortie. Chaque tranche enregistre maintenant les secondes qu’elle couvre réellement.
- PR #124 :
/coach-setupaffichait des libellés de réponse tronqués et décalés sous Python < 3.11, parce que le parseur TOML de secours découpait les tableaux sur les virgules, y compris celles à l’intérieur des chaînes.
Les pull requests de @rdlh disent toutes la même chose : « code écrit par Claude (Claude Code), relu et validé par rdlh ». C’est exactement comme ça que je travaille sur ce projet, moi aussi. Merci ! 🙏
8. En coulisses#
- Revue de sécurité (PR #144). La synchro automatique est mieux verrouillée : Python ne peut lancer que les scripts du moteur (fini
python3 -c), l’écriture dansscripts/,skills/,.claude/et.mcp.jsonest interdite, et les outils Garmin qui écrivent (entraînements, parcours) sont retirés du run sans surveillance.garmin_mcpest épinglé sur un commit, et deux fuites de configuration sont colmatées (un fichier.bakqui contenait le topic ntfy, et la config utilisateur qui se retrouvait dans l’image Docker). - Claude dans la CI (PR #129 et #143). Chaque PR a droit à une revue par Claude Code, et on peut demander de l’aide à
@claudedans les commentaires. Les deux workflows sont ignorés pour les forks et les non-collaborateurs au lieu d’échouer. - Releases (PR #162). Un tag SemVer peut être créé à la demande (patch / minor / major), une release GitHub est publiée automatiquement avec des notes générées, et les PR sont étiquetées d’après le préfixe de leur titre (
feat,fix,docs,test). - La PR #125 a corrigé un bug discret : sur la machine coach, via SSH et cron, le téléchargement des FIT ne trouvait pas l’environnement Python de Garmin, donc la synchro quotidienne sautait les échantillons FIT sans rien dire.
Et maintenant ?#
Deux de ces nouveautés changent la place du projet dans une journée : le casier à matériel, qui transforme « ces chaussures sont-elles finies ? » en un chiffre et un historique de photos, et le chat, pour les moments où l’on est devant un bureau plutôt que dans le canapé avec son téléphone. Et les vidéos sont la meilleure réponse que j’aie à « bon, concrètement, ça fait quoi ? ».
Pour l’essayer :
git clone https://github.com/mmornati/ai-running-coach.git
cd ai-running-coach
./install.sh # ou --preset coach-server- 🎬 Vidéos : mmornati.github.io/ai-running-coach/videos
- 📖 Documentation : mmornati.github.io/ai-running-coach
- 💻 GitHub : github.com/mmornati/ai-running-coach
Issues, idées et pull requests sont les bienvenues, deux personnes ont déjà montré l’exemple ! Et comme toujours, c’est un outil pour vous aider à vous préparer : il ne remplace pas l’avis d’un médecin.