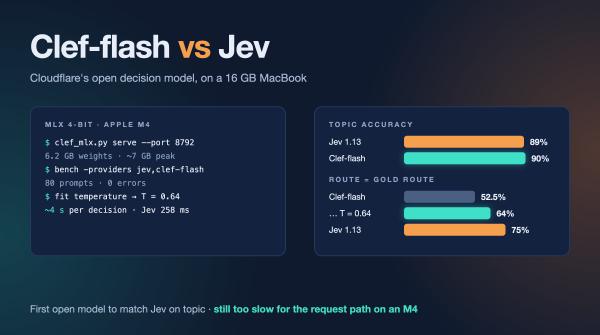
Trois jours après l’annonce de Cloudflare, Clef-flash est passé par le même benchmark de 80 prompts que Jev, Laya, Von et Kev. 90 % de précision sur le sujet, une température de confiance qui le met au niveau de Jev sur la calibration, et un problème qu’aucune température ne règle sur un portable.
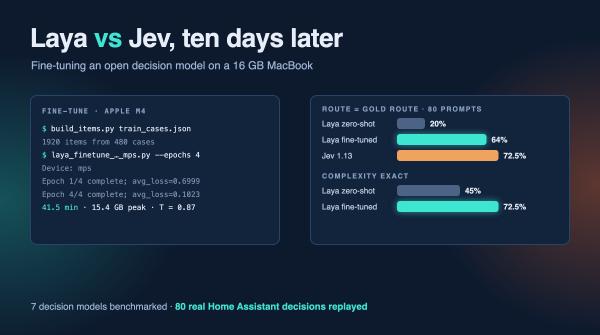
Laya dit « fine-tunez-moi », alors je l’ai fait, sur un MacBook de 16 Go. Voici la recette, le temps que ça prend, ce que ça change sur le benchmark de 80 prompts, et pourquoi ma maison tourne toujours sur Jev.
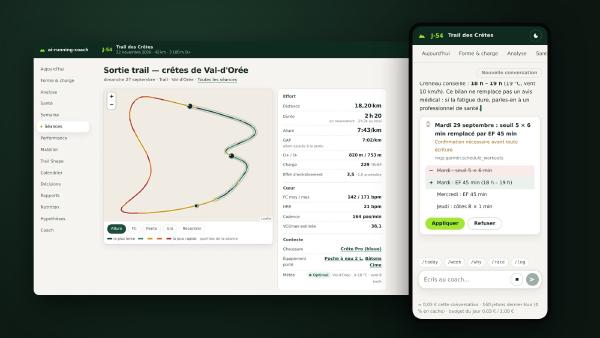
Un chat avec le coach dans le tableau de bord, une carte GPS sur chaque séance, un modèle de calories qui vérifie les chiffres de Garmin, un vrai casier à matériel avec inspections sur photos, la dynamique de course, une nouvelle contribution externe, et « Le Sentier », une série de vidéos dessinée en JavaScript à regarder directement ici.
Un tableau de bord, une pile de nouvelles métriques, des garde-fous capables de dire non, et un coach qui tourne sur une machine Linux à la maison et me répond depuis le téléphone. Voici ce qui a bougé dans ai-running-coach depuis l’ultra, et pourquoi la synchro automatique passe par cron plutôt que par une routine Claude.
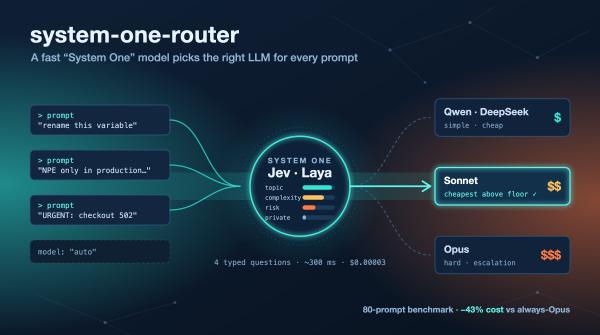
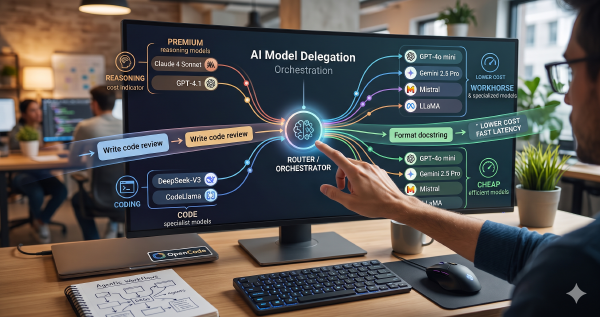
Mon premier routeur de modèles laissait un LLM lire un fichier de prompt pour choisir un agent. Celui-ci pose quatre questions typées à un modèle de décision « System One », calcule le score des modèles avec de la simple arithmétique, et publie un benchmark pour prouver que ça marche (et montrer où ça ne marche pas).