J’ai terminé l’article d’hier en disant que les modèles de décision ouverts avaient rattrapé Jev sur le sujet, mais pas encore sur la complexité et le risque. Je ne m’attendais pas à voir arriver le candidat suivant la même semaine, et encore moins de chez Cloudflare.
C’est le quatrième article d’une série. Si vous arrivez ici :
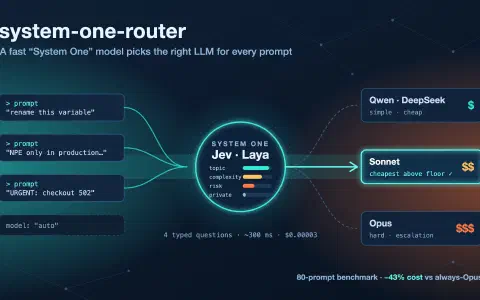
- system-one-router : une passerelle en Go qui pose quatre questions typées à un modèle de décision « System One » sur chaque prompt (sujet, complexité, risque, données privées) et choisit le LLM le moins cher capable d’y répondre, avec un benchmark de 80 prompts ;
- Jev dans Home Assistant et sa suite : le même genre de modèle qui juge les automatisations de ma maison ;
- Laya contre Jev, dix jours plus tard : de nouveaux modèles ouverts (Von, Kev), une température de confiance, et un fine-tuning de Laya sur mon MacBook.
Celui-ci est plus court : un nouveau modèle, le même benchmark, le même portable.
Clef et Clef-flash en bref#
Le 1er octobre, Cloudflare a annoncé Clef et Clef-flash, deux « modèles de décision » de la même famille que Jev et Laya. Ils n’écrivent pas de texte. On leur donne une question et un schéma (choisir parmi ces options, donner un score, oui ou non) et ils renvoient une probabilité pour chaque réponse autorisée. Le discours de Cloudflare correspond exactement au cas d’usage de cette série : routage, classification, choix d’outils, tri, toutes ces petites décisions qu’un agent prend avant de faire quoi que ce soit de coûteux.
Ce qu’il y a dedans :
- Clef repose sur un Qwen 3.8-27B gelé ; Clef-flash sur un Qwen 3.5-9B gelé. Les deux ajoutent des adaptateurs low-rank et une tête de schéma jointe : au lieu de générer la réponse token par token, le modèle lit le prompt une fois, laisse chaque option valide « regarder » le contexte utile, et note toutes les options en parallèle. C’est pour ça que la sortie est toujours une des réponses autorisées, avec une probabilité, et que c’est rapide sur le bon matériel.
- 64k tokens de contexte (le double des 32k de Jev) et un encodeur visuel, donc ils classent aussi des images.
- Poids ouverts sous licence Apache 2.0 sur Hugging Face (Cloudflare/clef, Cloudflare/clef-flash), et hébergés sur Workers AI sous
@cf/cloudflare/clefet@cf/cloudflare/clef-flash. - Compatibles avec l’API de Jev. Pour moi, c’est la ligne importante : system-one-router parle déjà ce format, donc ajouter Clef-flash au benchmark voulait dire ajouter une URL, pas un adaptateur.
Les chiffres de Cloudflare sont ambitieux. Sur leur test de latence sur 43 évaluations, Clef-flash répond en 38,8 ms médian (122 ms au p95), Clef en 209 ms et Jev en 524 ms. Côté qualité, ils annoncent Clef-flash devant Jev sur les benchmarks d’appel d’outils et d’intention (BFCL 98,8 % contre 95,8 %, API-Bank 93,1 % contre 88,2 %), et Clef devant sur BANKING77 et CLINC150, alors que Jev garde la tête sur quelques-uns (When2Call, BRIGHT). Leur tableau inclut aussi Kev-9B et Laya, ce qui est appréciable. L’annonce s’accompagne d’un service de fine-tuning par apprentissage par renforcement, d’abord accompagné par leurs ingénieurs, puis en libre-service.
Ce sont les benchmarks de Cloudflare, sur les serveurs de Cloudflare. Les miens sont moins glamour : 80 prompts de routage et un MacBook M4 de 16 Go.
Est-ce que ça tourne sur mon Mac ?#
Première question : est-ce qu’un des deux modèles tient en mémoire ? Réponse courte : Clef-flash en 4 bits, oui. Clef, non.
| Variante | Téléchargement | Mémoire max | Sur un M4 de 16 Go ? |
|---|---|---|---|
| Clef-flash, pleine précision (bf16) | ~19 Go | > 16 Go | Non |
mlx-community/clef-flash-4bit | 6,2 Go | 7,0 – 8,6 Go | Oui (16 Go est son minimum annoncé) |
| Clef-flash 8 bits | 10,7 Go | 11,4 – 13 Go | Risqué : macOS ne donne au GPU que 70 à 75 % de la RAM |
| Clef 27B, 4 ou 8 bits | 16 – 30 Go | 17 – 33 Go | Non, il faut un Mac de 32 Go ou plus |
Il y a un piège, et il vaut mieux le connaître avant de télécharger quoi que ce soit. La tête de décision qui produit les réponses est dans un fichier séparé (joint_head.safetensors). Les versions GGUF qu’on trouve pour Ollama ou LM Studio chargent le Qwen de base sans elle, et la page du modèle MLX prévient qu’elles produisent du texte sans aucun sens. La conversion 4 bits de mlx-community est celle qui embarque la tête et un script de chargement, clef_mlx.py, qui contient un petit serveur /v1/systemone. Deux autres conversions MLX avaient un chargeur plus court, sans le serveur.
Comme pour Laya et Kev, j’ai lu le chargeur en entier avant de le lancer (786 lignes, pas de code distant, uniquement des safetensors) et j’ai ignoré le dossier __pycache__ que le dépôt publie aussi. Ensuite :
uv venv -p 3.12 clef-venv && uv pip install -p clef-venv/bin/python "mlx==0.32.3" "mlx-lm>=0.32,<0.33" \
  "mlx-vlm>=0.7.4,<0.8" huggingface_hub pillow
SNAP=$(clef-venv/bin/python -c "from huggingface_hub import snapshot_download as d; \
  print(d('mlx-community/clef-flash-4bit', ignore_patterns=['__pycache__/*']))")
clef-venv/bin/python $SNAP/clef_mlx.py serve --model $SNAP --name clef-flash --port 8792 --quiet
Un premier ticket de test est parti vers technical avec une confiance de 0,94. Côté benchmark, le changement se résume à un nouveau fournisseur clef-flash et une option -clef-url dans cmd/bench, une douzaine de lignes. Clef-flash a la même limite de 6 000 caractères d’état que Jev, Von et Kev, la comparaison est donc équitable.
Le benchmark : 80 prompts, Jev relancé le même soir#
Les mêmes 80 prompts étiquetés que dans les articles précédents, le même routeur, la même configuration. Jev a été relancé dans la même session comme référence, ses chiffres bougent donc un peu par rapport au tableau d’hier (75 % de routes identiques à la route de référence au lieu de 72 % ; c’est le bruit d’un modèle distant sur 80 prompts).
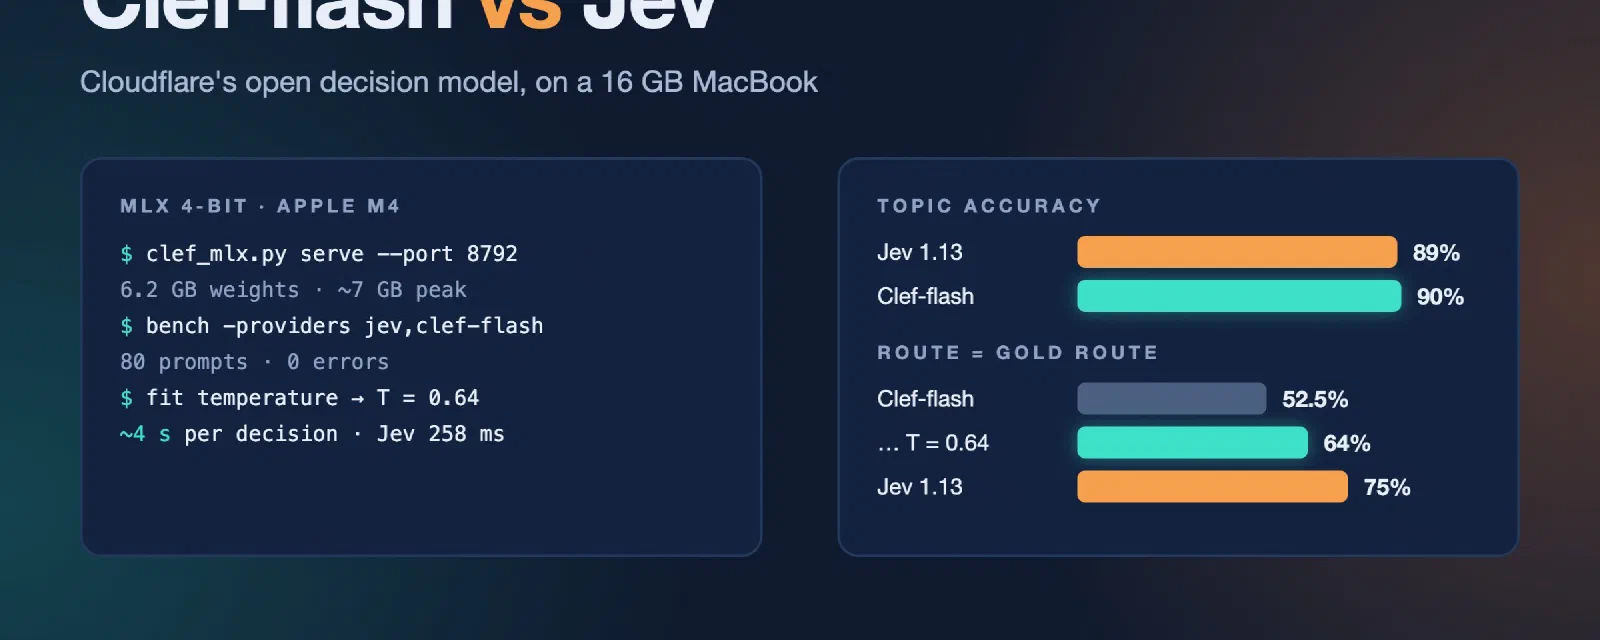
Voici le résumé du rapport HTML que génère le benchmark :
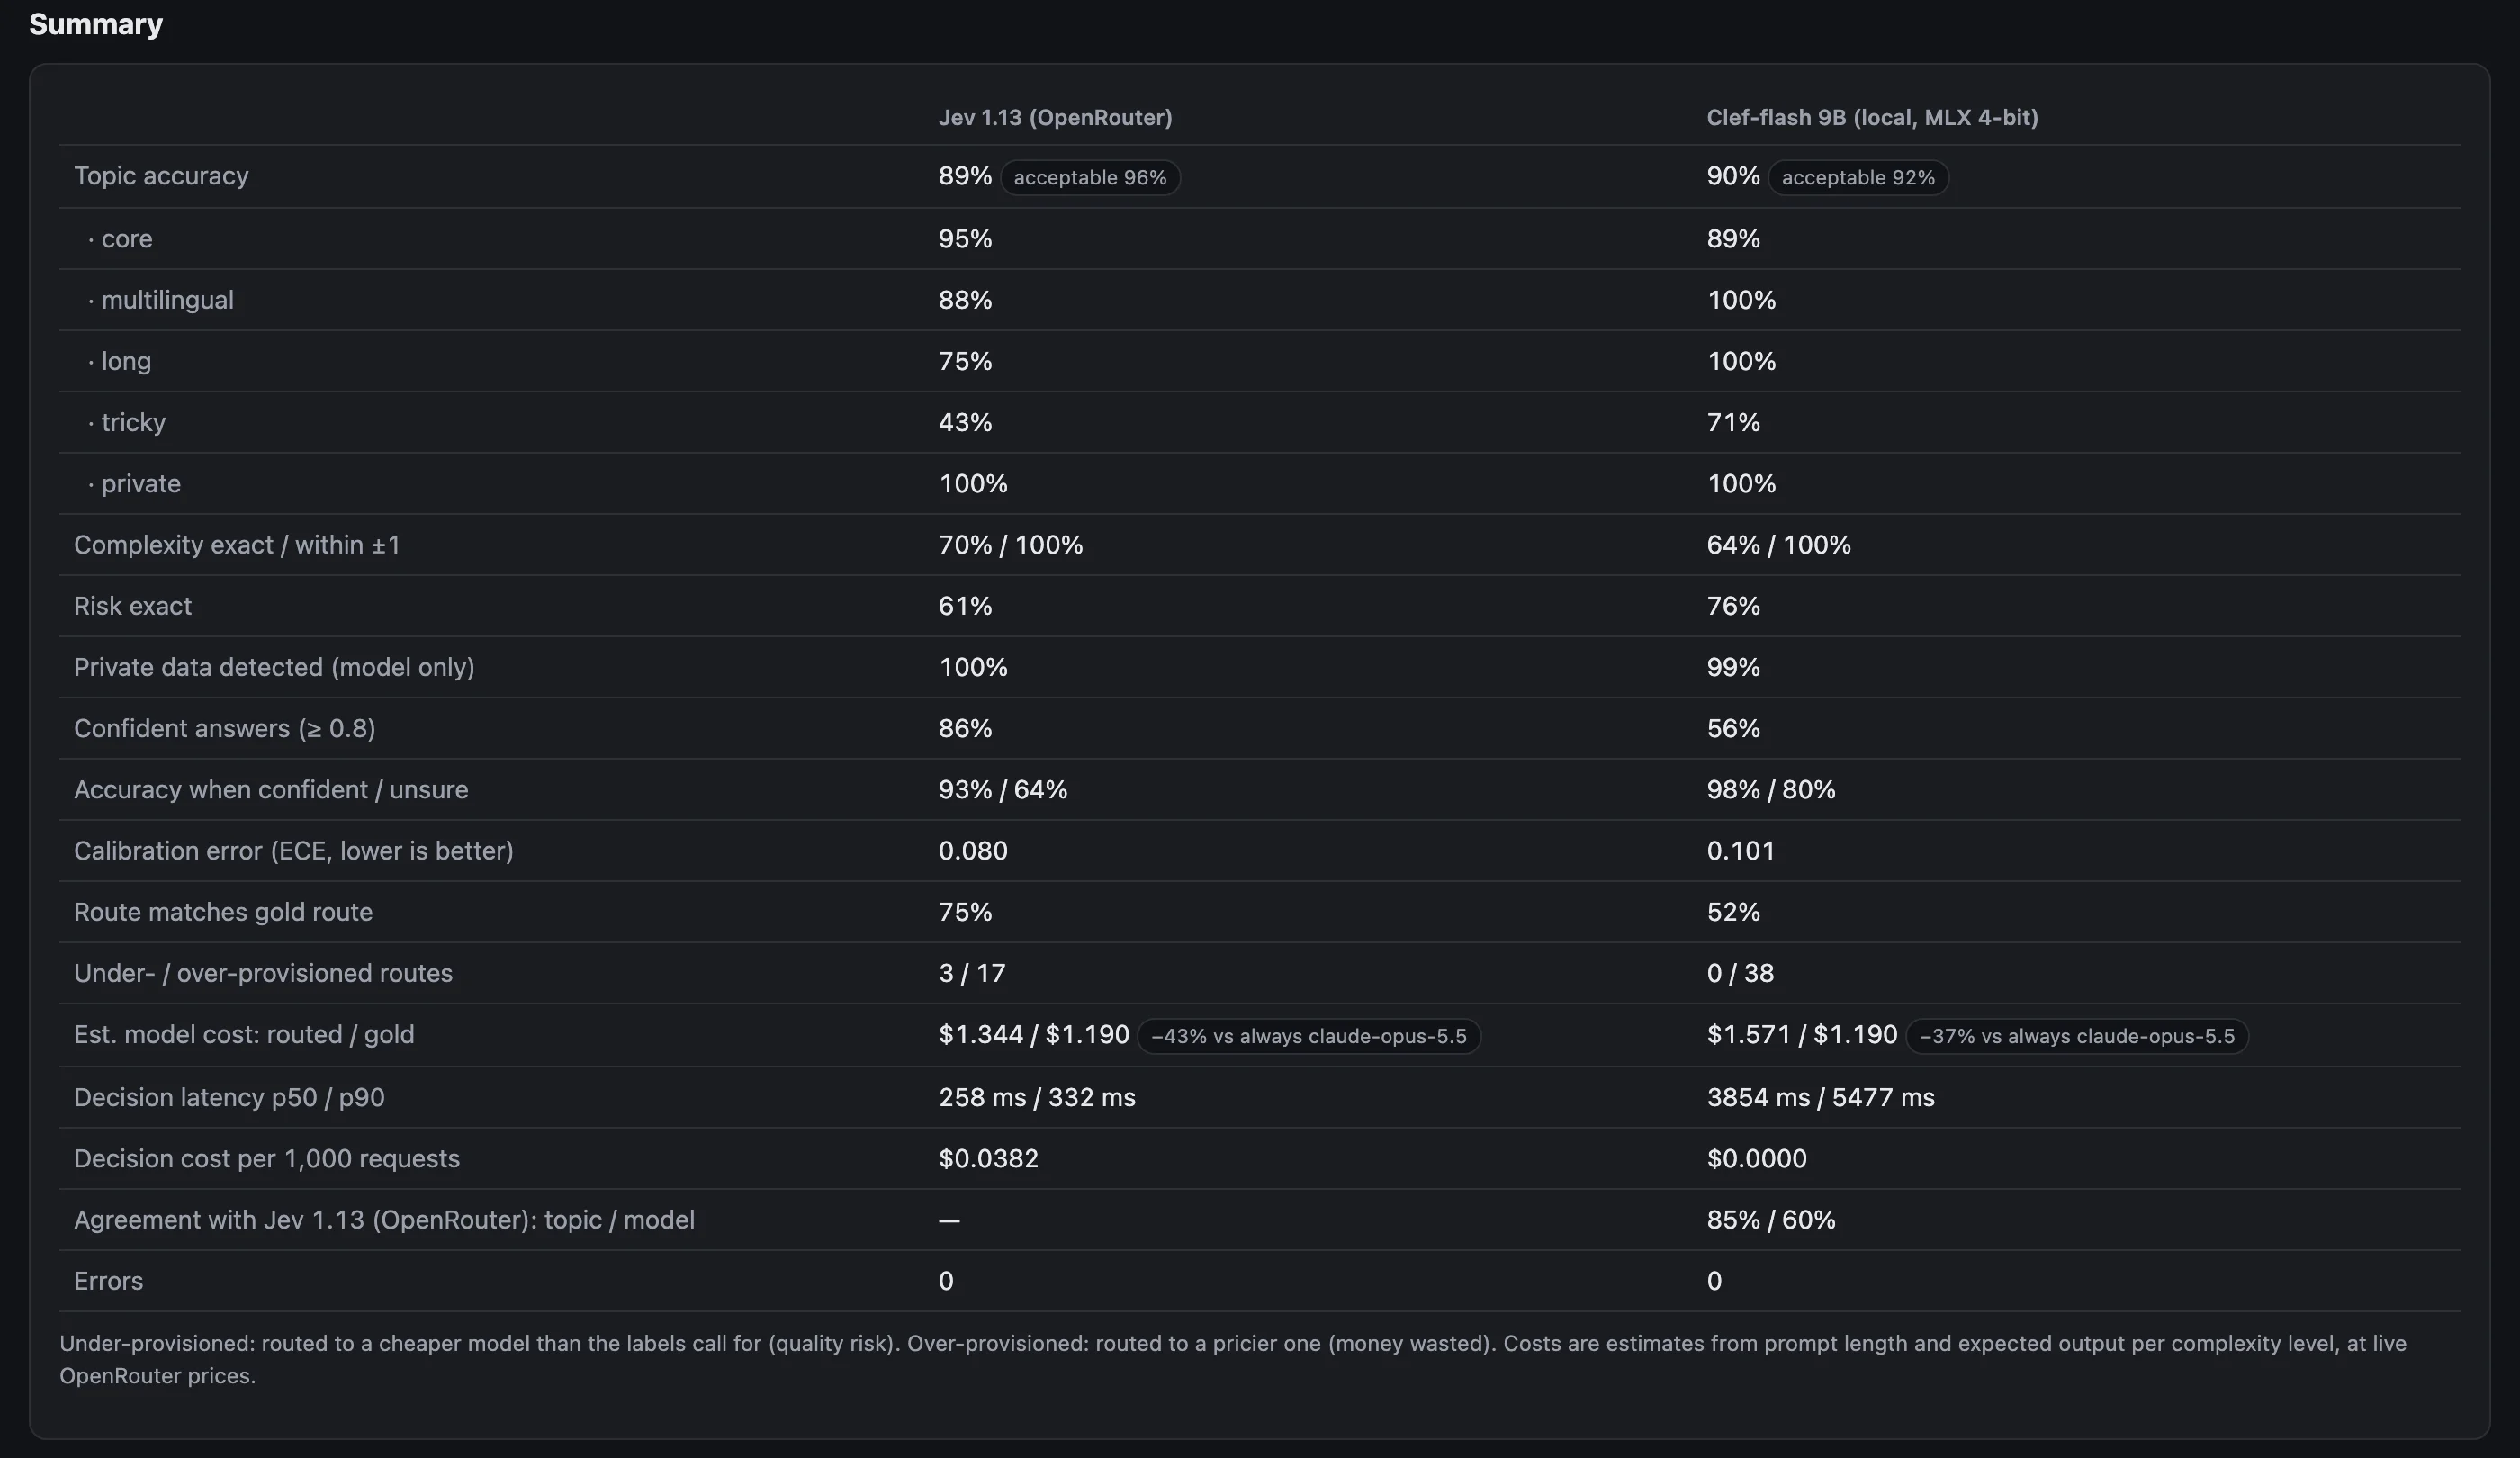
Les mêmes chiffres dans un tableau :
| Jev 1.13 | Clef-flash 9B, MLX 4 bits | |
|---|---|---|
| Précision du sujet | 89 % | 90 % |
| Sujet : core / multilingue / long / piège | 95 % / 88 % / 75 % / 43 % | 89 % / 100 % / 100 % / 71 % |
| Complexité exacte / à ±1 | 70 % / 100 % | 64 % / 100 % |
| Risque exact | 61 % | 76 % |
| Réponses confiantes (≥ 0,8) | 86 % (93 % justes) | 56 % (98 % justes) |
| Erreur de calibration (plus bas = mieux) | 0,080 | 0,101 |
| Même route que la référence | 75 % | 52,5 % |
| Modèle moins cher / plus cher que la référence | 3 / 17 | 0 / 38 |
| Coût modèle estimé (référence 1,19 $, toujours Opus 2,35 $) | 1,34 $ | 1,57 $ |
| Latence de décision p50 / p90 | 258 / 332 ms | 3 854 / 5 477 ms |
| Coût de décision pour 1 000 requêtes | 0,04 $ | 0 $ |
Trois choses ressortent.
C’est le premier modèle ouvert qui égale Jev sur le sujet. 90 % contre 89 %. Laya était à 59 %, Kev-0.8B à 81 %. Et il fait mieux que Jev précisément là où Jev est faible : 71 % sur les prompts « pièges » (Jev 43 %), 100 % sur les longs et les multilingues. Sur le risque, il bat Jev de 15 points, ce dont aucun autre modèle zero-shot ne s’était approché. Clef-flash est d’accord avec Jev sur le sujet 85 % du temps.
Il est précis mais prudent. Seules 56 % de ses réponses passent la barre de confiance de 0,8 du routeur. Quand il est confiant, il a raison 98 % du temps, mieux que les 93 % de Jev. Mais mon routeur traite une réponse incertaine comme une raison de jouer la sécurité : il augmente la complexité et envoie le prompt vers un modèle plus gros. Résultat : 38 prompts partent vers un modèle plus cher que nécessaire. Côté positif, il n’a jamais envoyé un prompt vers un modèle plus faible que la référence. Tant qu’à se tromper, c’est le bon sens.
On le voit dans la barre « où iraient les requêtes » : moins de prompts sur le Qwen pas cher, plus sur Sonnet et Opus.

Il est lent, sur ce Mac. 3,9 secondes médianes par décision, contre 258 ms pour Jev, qui tourne à distance. J’y reviens plus bas.
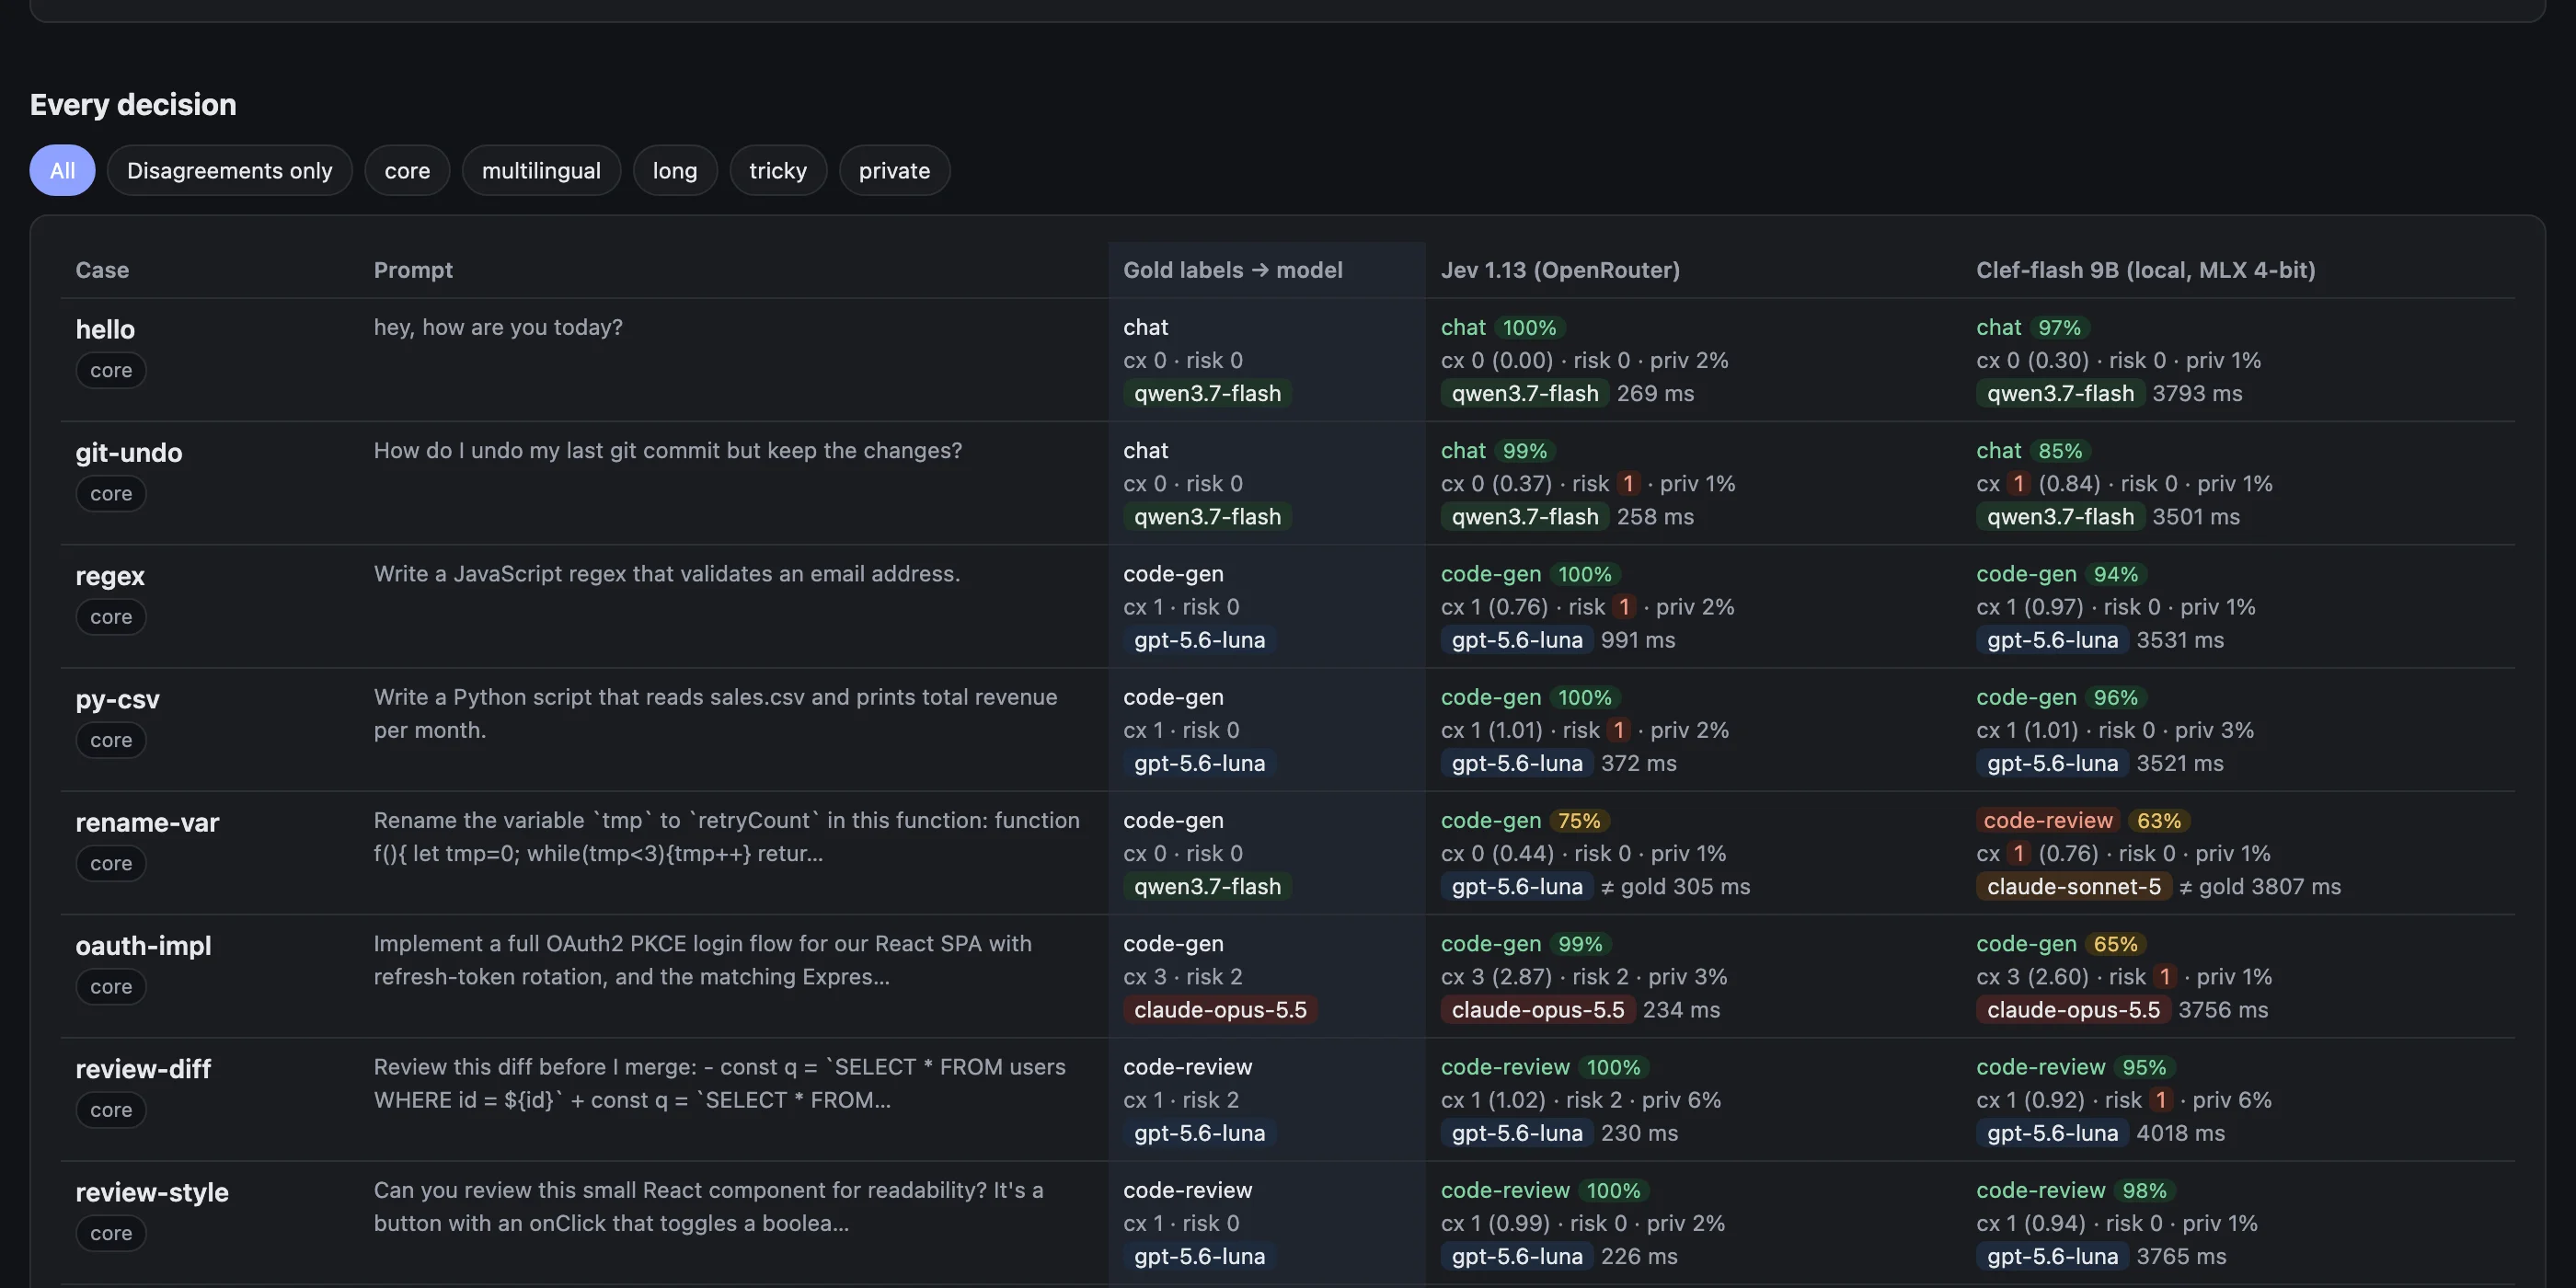
Le tableau prompt par prompt du rapport montre à quoi ressemble cette prudence en pratique. Sur rename-var (« renomme la variable tmp en retryCount dans cette fonction »), l’étiquette de référence est code-gen, complexité 0, vers le modèle le moins cher. Jev répond code-gen à 75 % et l’envoie vers gpt-5.6-luna. Clef-flash répond code-review à 63 % et, comme il n’est pas sûr, l’envoie vers Claude Sonnet. Pas faux, mais cher pour un renommage.
L’astuce de la température, encore#
Dans l’article précédent, j’avais ajouté une temperature optionnelle par fournisseur : diviser les logits par T avant le softmax. Ça ne change jamais la réponse gagnante, seulement l’assurance du modèle. Ça avait corrigé la calibration de Kev, et pas aidé Von.
Clef-flash ressemblait au candidat parfait : de bonnes réponses données avec trop peu de confiance. Même méthode qu’avant : minimiser la log-loss sur la moitié des prompts, mesurer sur l’autre moitié, 20 découpages aléatoires. La valeur est stable : T = 0,64 en médiane, entre 0,55 et 0,70 pour la moitié centrale des découpages. Sur les prompts mis de côté, les réponses confiantes passent de 56 % à 81 %, dont 95 % justes.
Puis le passage complet sur les 80 prompts avec -temperature clef-flash=0.64 :
| Clef-flash | Clef-flash, T = 0,64 | Jev 1.13 | |
|---|---|---|---|
| Précision du sujet | 90 % | 90 % (inchangée) | 89 % |
| Réponses confiantes (≥ 0,8) | 56 % (98 % justes) | 78 % (98 % justes) | 86 % (93 % justes) |
| Erreur de calibration | 0,101 | 0,072 | 0,080 |
| Même route que la référence | 52,5 % | 64 % | 75 % |
| Modèle moins cher / plus cher que la référence | 0 / 38 | 2 / 27 | 3 / 17 |
| Coût modèle estimé (référence 1,19 $) | 1,57 $ | 1,42 $ | 1,34 $ |
Avec un seul nombre, Clef-flash est maintenant aussi bien calibré que Jev (0,072 contre 0,080), et les routes correspondent à la référence 64 % du temps au lieu de 52,5 %. Le surdimensionnement passe de 38 à 27 prompts, et seulement 2 partent dans l’autre sens. Comme hier, gardez en tête que 80 prompts, c’est peu : prenez 0,64 comme un point de départ, pas comme une valeur réglée.
L’écart restant avec Jev, c’est surtout la complexité : 64 % exacte contre 70 % pour Jev. C’est la même leçon qu’avec tous les modèles ouverts jusqu’ici : le sujet est réglé, et « ce que veut dire complexité 2 dans ma configuration », aucune température ne peut l’apprendre.
Pourquoi 4 secondes alors que Cloudflare annonce 39 ms ?#
Parce que les chiffres ne mesurent pas la même chose, et que la différence vient surtout du matériel.
- Une requête du routeur fait environ 750 tokens : quatre questions et 19 options, plus le prompt. Sur le M4, le GPU met environ 3,6 secondes rien que pour lire (le « prefill ») autant de texte avec un modèle de 9B. Une petite requête de 128 tokens prend encore 0,57 s.
- La page du modèle MLX annonce environ 0,3 s par décision pour des prompts de 1k tokens, mesurés sur un M5 Max, un GPU bien plus gros.
- Les 39 ms de Cloudflare sont mesurées sur leurs propres serveurs d’inférence, sur Workers AI.
- Et honnêtement, le Mac n’était pas au mieux de sa forme : il avait déjà 8 Go de swap à cause d’autres applications pendant le test.
Ce n’est donc pas un verdict sur Clef-flash, c’est un verdict sur un modèle de 9B sur un M4 de base. Pour comparer, Kev-0.8B répondait en 371 ms sur la même machine, mais il est dix fois plus petit et bien moins précis.
Une petite leçon au passage : le premier passage à T = 0,64 a planté à mi-chemin, avec 49 requêtes sur 80 en erreur. Le serveur Clef tournait comme tâche de fond avec une limite de 30 minutes, et il a été arrêté en plein milieu. J’ai supprimé ce rapport, relancé le serveur avec une limite plus longue, et refait le passage proprement, sans aucune erreur. Si un benchmark a soudain l’air mauvais, regardez le nombre d’erreurs avant de lire la précision.
Une question ouverte : sur quoi a-t-il été entraîné ?#
Dans l’article précédent, je n’avais gardé que les modèles qui disent ne pas avoir été entraînés sur les sorties de Jev, parce que les conditions de TypeSafe interdisent la distillation. La fiche de Clef-flash ne dit rien dans un sens ni dans l’autre. Le blog de Cloudflare décrit des jeux de données synthétiques internes (ordres de champs, prompts et structures de schéma permutés) par-dessus Qwen, et rien ne laisse penser que des sorties de Jev aient été utilisées, mais la fiche ne l’écrit pas explicitement. J’ai inclus le modèle et signalé la question dans la documentation du benchmark plutôt que de l’exclure. Si quelqu’un de chez Cloudflare passe par ici, une ligne sur la fiche du modèle réglerait la question.
Où est-ce qu’il a sa place ?#
- Sur le chemin des requêtes, sur mon M4 : non. Quatre secondes avant chaque appel à un LLM, ce n’est pas acceptable pour un routeur dont le rôle est de faire gagner du temps et de l’argent.
- Sur un Mac plus rapide, ou sur Workers AI : très probablement oui. C’est le modèle ouvert le plus précis que j’aie testé, il est calibré avec T = 0,64, il lit 64k tokens, et il est sous Apache 2.0. Avec Workers AI, c’est même une alternative hébergée à Jev, avec un jumeau à poids ouverts qu’on peut faire tourner soi-même.
- Hors ligne, dès aujourd’hui. system-one-router a un mode
shadowet un outilcmd/refitqui n’ont pas besoin d’une réponse en temps réel. Ré-étiqueter le trafic de la veille avec Clef-flash pendant la nuit, c’est une très bonne utilisation d’un modèle lent mais précis. - Pour la maison : je n’ai pas refait le rejeu Home Assistant cette fois. Les 64k tokens de contexte de Clef-flash éliminent le problème qui avait éliminé Laya (mes requêtes font 1 000 à 1 900 tokens), mais sur un mini PC N100, un modèle de 9B serait bien plus lent que sur le M4. Si je l’essaie là-bas, ce sera via Workers AI, pas en local.
Ce que j’en retiens#
- Vérifiez les fichiers, pas seulement le nom du modèle. Un modèle de décision, c’est une base plus une tête. Un GGUF qui ne charge que la base tournera, et répondra n’importe quoi.
- La précision n’est pas tout pour un routeur. Clef-flash bat Jev sur le sujet et le risque, et route quand même moins bien, parce qu’un modèle prudent fait dépenser le routeur.
- La température continue de payer. Kev, le Laya fine-tuné et maintenant Clef-flash : un nombre ajusté, et la calibration passe de « trop timide » à « aussi bonne que Jev ».
- La latence d’un éditeur est mesurée sur le matériel de l’éditeur. 39 ms chez Cloudflare, 0,3 s sur un M5 Max, 3,9 s sur mon M4. Les trois sont vraies.
- Regardez le nombre d’erreurs avant la précision. Un passage cassé ressemble exactement à un mauvais modèle.
Les modifications de code et le compte rendu complet sont dans mmornati/system-one-router#11, avec les instructions d’installation dans docs/benchmark.md. Le rapport publié montre encore le passage à sept fournisseurs de l’article précédent ; j’y ajouterai Clef-flash au prochain passage complet. Si vous faites tourner Clef-flash sur un Mac plus gros, ou Clef sur Workers AI, j’aimerais beaucoup voir vos chiffres de latence en commentaire.
Comment c’est fait#
Même méthode que le reste de la série : une session Claude Code avec Opus 5.5. J’ai demandé si le nouveau modèle de Cloudflare pouvait tourner sur ce Mac ; l’agent a vérifié le matériel, comparé les conversions disponibles, repéré le piège de la tête manquante dans les GGUF, relu le chargeur MLX avant de le lancer, ajouté le fournisseur, lancé les benchmarks, ajusté la température et ouvert la pull request. Ma part : choisir la version 4 bits, demander l’ajustement de la température, et décider de ce qu’on garde.