Il y a un mois, j’ai terminé l’article sur VegaML avec la promesse habituelle : le prochain candidat passera dans le benchmark. En temps « System One », un mois, c’est long. Cette fois, je n’ai donc pas attendu qu’un modèle apparaisse dans mon fil. J’ai ouvert une session Claude Code sur le dépôt de system-one-router et posé une question simple : est-ce qu’il y a un nouveau modèle System One à tester ? Une nouvelle version de Laya qui mérite un nouveau passage ?
C’est le sixième article de la série. Si vous arrivez ici :
- system-one-router : une passerelle en Go qui pose quatre questions typées à un modèle de décision « System One » sur chaque prompt (sujet, complexité, risque, données privées) et choisit le LLM le moins cher capable d’y répondre, avec un benchmark de 80 prompts ;
- Jev dans Home Assistant et sa suite : le même genre de modèle qui juge les automatisations de ma maison ;
- Laya contre Jev, dix jours plus tard : Von, Kev-0.8B, une température de confiance et un fine-tuning de Laya ;
- Clef-flash contre Jev : le modèle 9B de Cloudflare, le premier modèle ouvert à égaler Jev sur le sujet ;
- Laya 0.4.2 et VegaML : huit versions de Laya aux réponses identiques, et un modèle de décision qui fait rouler une bille en bas d’une pente.
La réponse à ma question : pas de nouveau modèle Laya, mais Jev 1.14 est sorti, et Kev-4B tient maintenant (tout juste) sur mon M4 de 16 Go. Ce sont les deux passages de cet article. Avant ça, un tour de ce qui a bougé en un mois, parce que beaucoup de choses ont bougé, même là où aucun benchmark n’était nécessaire.
Un mois de « System One » : ce qui a changé#
Laya : 28 versions, les mêmes poids#
Laya est passé de la 0.4.2 à la 0.4.30 entre le 11 octobre et le 8 novembre : 28 versions en quatre semaines. La première chose que j’ai vérifiée, comme je me l’étais promis dans les leçons du dernier article, ce sont les poids. Les trois fichiers model.safetensors sur Hugging Face (convaiinnovations/laya) datent toujours des 18 et 19 septembre. Le seul commit sur le Hub depuis mon dernier passage date de ce matin, et il ajoute seulement la citation d’un preprint en haut de la fiche du modèle (DOI 10.20944/preprints202611.0781.v1). Laya est donc aussi un article scientifique maintenant, ce qui est sympa, mais les checkpoints sont ceux que j’ai déjà mesurés trois fois.
Trois mises à jour d’affilée (0.3.6 → 0.3.24 → 0.4.2) ont donné des décisions identiques sur les 80 prompts. Avec des poids inchangés, la 0.4.30 ferait presque certainement la même chose, je n’ai donc pas passé une soirée à le prouver. C’est le premier « non » de cet article, et c’est un « non » utile.
Mais ce qui a changé dans le runtime est intéressant, même si ça ne fait pas bouger mes chiffres :
- Laya embarque maintenant VegaML.
Agent(vegaml=True)met le moteur physique de VegaML derrière l’API de Laya, avec des politiques entraînées par-dessus. Les deux modèles du même auteur convergent vers une seule boîte à outils. - Une correction de bug de fine-tuning à connaître. En 0.4.30, une étiquette gold oui/non à
1.0s’entraînait commefalsedans le chemin VegaML. Les étiquettes gold sont maintenant lues de la même façon que dans le fine-tuning de Laya lui-même, une étiquette qui ne correspond à aucune question est refusée, et un nombre non fini venant du moteur est refusé avant de pouvoir devenir une décisionautoconfiante. Si vous avez ajusté des têtes VegaML via Laya avec des booléens numériques, refaites l’ajustement. - Des hooks partout.
on_predict_start,on_predict_endeton_errortournent maintenant aussi sur l’agent VegaML, comme sur toutes les surfaces de Laya. - Vidéo. Les horodatages indiquent maintenant l’image d’où vient chaque réponse, et quelques plantages sur des clips sans durée ont disparu.
Rien de tout ça ne touche aux quatre checkpoints que fait tourner mon sidecar. Si je fais un nouveau fine-tuning de Laya, ce sera avec la CLI officielle laya-train, et ce sera le moment de mettre à jour.
VegaML : de la 0.8 à la 0.16.1, « un moteur, n’importe quel lecteur »#
VegaML a bougé plus vite que Laya : 0.8.0 → 0.16.1 en un mois. Le grand changement, c’est vega-U : le moteur physique de 14M de paramètres n’est plus lié à Qwen3.5. On peut l’attacher à un autre modèle de langage (le « lecteur »), en lui donnant de 100 à plus de 1 000 textes de son domaine, sans rien réentraîner. Ensuite, on le calibre avec ses propres exemples étiquetés. Il a aussi gagné des entrées audio et vidéo, et des politiques entraînées.
C’est une direction astucieuse, mais VegaML était faible en zero-shot sur mes questions de routage (51 % sur le sujet). La seule expérience qui vaudrait la peine d’être refaite, ce sont les têtes few-shot, et je l’ai laissée de côté pour ce tour.
Von est archivé#
Le 19 octobre, la fiche Hugging Face de Von a été marquée archivée, et elle renvoie maintenant vers d1-omni-600M de LiquidAI. Von 1.3 était, parmi les petits, le modèle ouvert qui routait le plus près de gold sans réglage (48 %), mais il était trop sûr de lui. Il reste dans mes tableaux comme référence, mais il n’aura pas de nouvelles versions.
LiquidAI entre dans la partie : la famille d1#
C’est le nouveau venu le plus sérieux du mois. LiquidAI a publié toute une famille de modèles de décision : d1-3B et d1-omni-600M le 5 octobre, puis d1-2B et d1-Omni-2B le 24 octobre. d1-2B est construit sur LFM3-VL-2B, lit du texte, des images et de la vidéo, parle 16 langues, et la fiche annonce 5,7 ms par décision sur un H100, avec autant de questions qu’on veut sur un même état en un seul appel. Il tourne sur Apple Silicon via Transformers.
Deux réserves l’ont gardé hors de ce tour : la licence est la LFM Open License v1.0, pas Apache-2.0, et la fiche ne dit pas si les sorties de Jev faisaient partie des données d’entraînement. Il demande aussi un petit sidecar, comme VegaML. C’est le premier candidat pour le prochain passage.
Le reste du paysage#
- vllm-sr d3 (Apache-2.0) : d3-mini, d3-flash et d3-turbo sont forts sur les classements publics de décision, mais d3-mini seul (4,5B) monte à 14,8 GiB en bf16 d’après sa fiche. Pas sur un portable de 16 Go.
- Clef et Clef-flash : pas de nouveaux poids, seulement des résultats d’évaluation ajoutés aux fiches.
- autotrust JEV-* : les modèles « System One » les plus téléchargés et les plus aimés sur Hugging Face, et entraînés sur les sorties de Jev. Même règle qu’avant : je ne benchmarke pas de Jev distillé, puisque les conditions de TypeSafe l’interdisent.
- Le déluge. Une recherche sur Hugging Face avec les tags
system-oneoudecision-modelrenvoie maintenant des dizaines de nouveaux dépôts par jour :zils-*,OneJev, des fine-tunes*-jev-*, des conversions GGUF. La plupart n’ont aucun téléchargement. En septembre, je pouvais compter les candidats sur les doigts des deux mains.
Jev 1.14#
Et puis celui qui compte le plus pour moi, parce que Jev est mon fournisseur en production : TypeSafe a publié Jev 1.14 sur OpenRouter. typesafe/jev-1.13 est toujours disponible, et ~typesafe/jev-latest pointe maintenant vers la 1.14. La nouveauté phare est un nouveau type de question box : on donne une image à Jev, on lui demande de trouver une cible, et il répond avec les quatre bords d’un rectangle (la 1.13 rejette ça avec une 400). Le contexte est de 262 144 tokens.
Mon routeur n’envoie pas d’images, donc la box ne compte pas. La vraie question, c’est de savoir si le sujet, la complexité et le risque dérivent d’une version à l’autre. Et c’est peu coûteux à mesurer : 80 prompts coûtent environ 0,04 $.
Passage 1 : Jev 1.14 contre 1.13#
config.yaml épingle typesafe/jev-1.13. Le bench accepte maintenant n’importe quel jev-<version> comme nom de fournisseur, donc les deux versions tournent côte à côte, sur les mêmes prompts, le même soir, à travers le même routeur :
go run ./cmd/bench -providers jev-1.13,jev-1.14Un modèle distant n’est pas parfaitement déterministe, je l’ai donc lancé deux fois pour voir quelle part de la différence n’est que du bruit.
| Jev 1.13 (passage 1 / passage 2) | Jev 1.14 (passage 1 / passage 2) | |
|---|---|---|
| Précision du sujet | 87,5 % / 88,8 % | 87,5 % / 87,5 % |
| Complexité exacte / à ±1 | 70 % / 71 % · 100 % | 69 % / 69 % · 100 % |
| Risque exact | 60 % / 60 % | 65 % / 66 % |
| Réponses avec une confiance ≥ 0,8 | 86 % / 86 % (93 % justes) | 81 % / 80 % (95–97 % justes) |
| Erreur de calibration (ECE) | 0,088 / 0,099 | 0,072 / 0,059 |
| Route = gold | 71 % / 74 % | 71 % / 70 % |
| Moins cher / plus cher que gold | 5 / 18 · 3 / 18 | 3 / 20 · 3 / 21 |
| Coût estimé des modèles (gold : 1,18 $) | 1,31 $ / 1,35 $ | 1,47 $ / 1,48 $ |
| Latence de décision p50 | 221 / 207 ms | 199 / 192 ms |
Les deux versions sont d’accord sur le sujet pour 95–96 % des prompts et sur le modèle routé pour 84–86 %. Ce n’est donc pas un modèle différent, c’est un affinage. Et cet affinage va dans deux directions à la fois :
- La 1.14 est le meilleur classifieur. +5 points sur le risque dans les deux passages, une erreur de calibration plus basse dans les deux passages, et une réponse un peu plus rapide. Le sujet et la complexité ne bougent pas.
- Mais elle route environ 10 % plus cher. Elle est moins souvent confiante (80–81 % des réponses passent mon seuil de 0,8, contre 86 %), et quand elle n’est pas confiante, mon routeur joue la sécurité et relève le plancher de qualité. Elle fait aussi passer quelques prompts de la complexité 2 à 3.
Est-ce que c’est juste mon seuil qui est trop strict pour un modèle mieux calibré ? J’ai relancé les deux versions avec le seuil à 0,7 et 0,6 :
| Seuil de confiance | Jev 1.13 coût / route = gold | Jev 1.14 coût / route = gold |
|---|---|---|
| 0,8 (actuel) | 1,31–1,35 $ / 71–74 % | 1,47–1,48 $ / 70–71 % |
| 0,7 | 1,32 $ / 75 % | 1,44 $ / 70 % |
| 0,6 | 1,28 $ / 76 % | 1,43 $ / 72,5 % |
Non. La 1.14 reste plus chère à chaque seuil, et la 1.13 garde à chaque fois la meilleure correspondance avec gold.
Ensuite, prompt par prompt : où les deux versions routent-elles différemment ? Sur 13 prompts dans le premier passage et 11 dans le second, et la 1.14 choisit le modèle le plus cher sur 9 et 8 d’entre eux. Les raisons sont mélangées : des passages de complexité 2 → 3 (parfois justes, parfois non), une confiance sur le sujet qui tombe sous le seuil (0,92 → 0,69, 0,82 → 0,59), un risque 1 → 2. Une douzaine de prompts sur 80 : c’est une tendance, pas une mesure. Mais la tendance est la même dans les deux passages.
Décision : je reste sur la 1.13 pour l’instant. Un meilleur score de risque, c’est bien, mais mon routeur ne paie pas la précision sur le risque, il paie des routes. Je revérifierai la 1.14 quand cmd/refit aura assez de vrais résultats pour dire si sa prudence supplémentaire valait le coup, parce que ces routes plus chères étaient peut-être les bonnes.
Une découverte en passant sur le risque#
En regardant les scores de risque, Claude a remarqué que les deux versions de Jev sont biaisées vers le haut par rapport à mes étiquettes : en moyenne, le score de risque brut est environ 0,53 au-dessus de mon étiquette. Le routeur soustrait un risk_offset fixe de −0,3 avant d’arrondir. Avec −0,5 à la place, la précision sur le risque monterait à environ 80 % pour les deux versions.
Je ne l’ai pas changé. Avec −0,5, un risque 2 demanderait un score brut d’exactement 2,0 : ça marche sur ces 80 prompts à cause de l’endroit où leurs scores tombent par hasard, et c’est la définition même du surapprentissage. Un détail amusant : le premier balayage disait que −0,5 était bien meilleur que −0,4 et −0,6, ce qui paraissait suspect. La raison, c’était l’arrondi : Python arrondit au pair le plus proche, Go arrondit en s’éloignant de zéro. Revérifié avec l’arrondi de Go, −0,5 reste le meilleur, mais avec moins d’écart.
Passage 2 : Kev-4B sur un Mac de 16 Go#
Kev, de Jared Palmer, c’est une LoRA plus une tête de pointage sur un modèle de base Qwen3.5. Kev-0.8B était le meilleur petit classifieur de sujet ouvert de la série (81 %, et 100 % sur les prompts multilingues), mais faible sur la complexité et le risque. Kev-4B est la taille recommandée, et dans ma documentation, j’avais écrit qu’il fallait un Mac de 32 Go. La session a trouvé deux façons de l’essayer quand même : une conversion MLX en 4 bits de 3 Go publiée par quelqu’un d’autre, ou le propre serveur de Kev, qui sur Apple Silicon sert automatiquement via MLX.
J’ai choisi le serveur de Kev, en bf16, parce qu’il parle directement mon format /v1/systemone, sans adaptateur :
git clone https://github.com/jaredpalmer/kev.git && cd kev && uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --host 127.0.0.1 --port 8794
go run ./cmd/bench -providers jev,kev-4b
(Claude ne pouvait pas cloner et installer Kev tout seul : la vérification des permissions a bloqué l’exécution de code externe, ce qui est exactement ce qu’elle doit faire. J’ai autorisé l’installation.)
Il « tient » au sens où il tourne : 8,4 Go de poids en bf16 sur une machine de 16 Go qui fait aussi tourner un navigateur, un IDE et un benchmark en Go. Le Mac a swappé entre 4 et 6 Go pendant tout le passage. La première requête a pris 143 secondes (chargement plus préchauffage), puis 44 s, 6,9 s, 3,4 s… jusqu’à environ 2,6 à 3 secondes par décision une fois chaud.
Trois façons de lire la confiance de Kev#
Kev est livré avec sa propre calibration : une température T = 2,41, ajustée sur son jeu de développement. Sur mes questions, c’est beaucoup trop prudent. Kev-4B a donc tourné trois fois :
- Tel que livré ;
- Avec ma température côté client habituelle, ajustée de la même façon que pour les autres modèles (minimiser la log-loss sur la moitié des prompts, mesurer sur l’autre moitié, 20 découpages aléatoires). Le script a d’abord retrouvé la valeur documentée de Kev-0.8B (0,46 contre 0,47) pour s’assurer que c’était bien la même méthode. Pour Kev-4B, il a donné T = 0,46 ;
- Avec la température dans le serveur de Kev :
KEV_TEMPERATURE=1.11, soit 2,41 × 0,46. J’explique la différence plus bas.
| Jev 1.13 | Kev-0.8B | Kev-4B | Kev-4B, T = 0,46 | Kev-4B, KEV_TEMPERATURE=1.11 | |
|---|---|---|---|---|---|
| Précision du sujet | 89 % | 81 % | 86 % | 86 % | 86 % |
| Sujet : core / multilingue / long / piège | 95 % / 88 % / 75 % / 43 % | 89 % / 100 % / 75 % / 43 % | idem | idem | |
| Complexité exacte / à ±1 | 70 % / 100 % | 42 % / 98 % | 51 % / 99 % | idem | 55 % / 98 % |
| Risque exact | 61 % | 49 % | 61 % | 61 % | 74 % |
| Réponses avec une confiance ≥ 0,8 | 85 % (94 % justes) | 5 % | 19 % (100 % justes) | 74 % (95 % justes) | 74 % (95 % justes) |
| Erreur de calibration (ECE) | 0,067 | 0,349 | 0,280 | 0,080 | 0,084 |
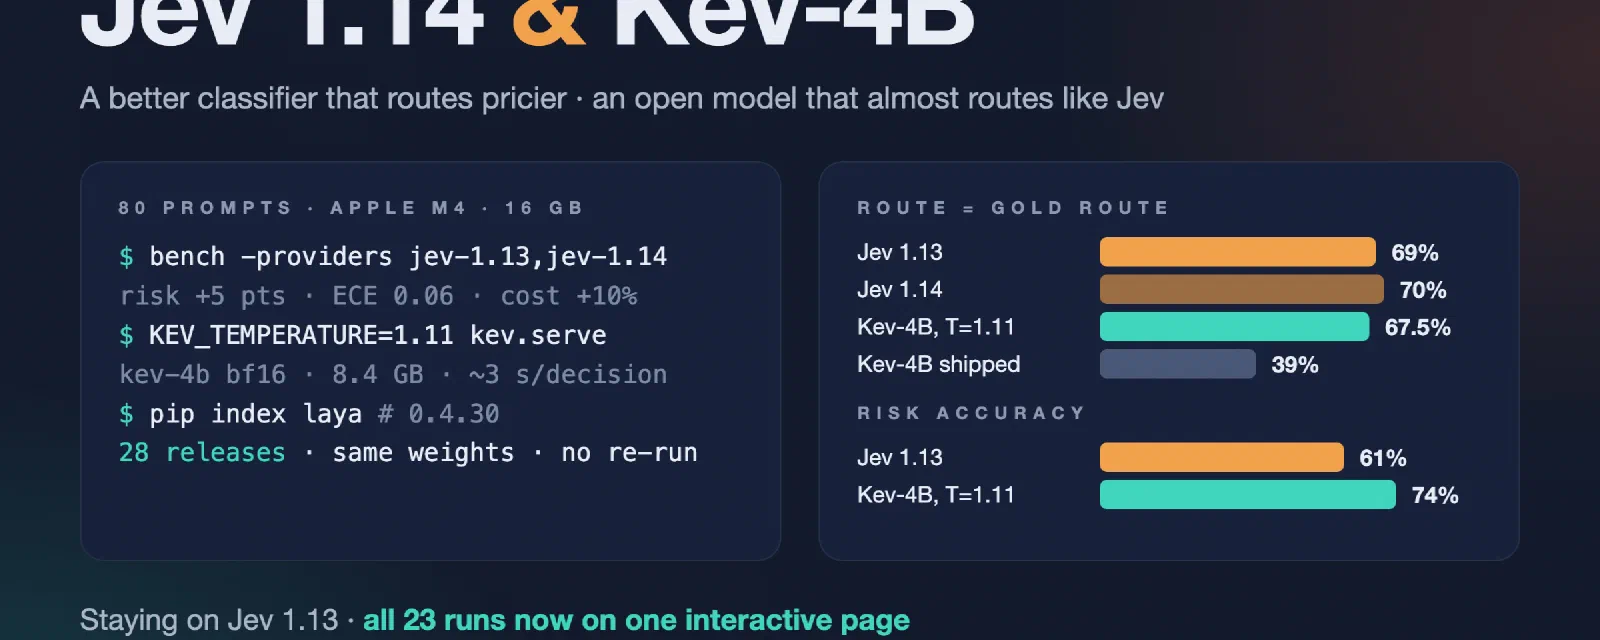
| Route = gold | 69 % | 22 % | 39 % | 61 % | 67,5 % |
| Moins cher / plus cher que gold | 5 / 20 | 4 / 58 | 3 / 46 | 14 / 17 | 11 / 15 |
| Coût estimé des modèles (gold : 1,18 $) | 1,33 $ | 1,16 $ | 1,13 $ | 0,70 $ | 0,87 $ |
| Latence de décision p50 / p90 | 211 / 278 ms | 371 ms | 2 565 / 12 510 ms | 2 699 / 3 308 ms | 2 979 / 6 386 ms |
Tel que livré, Kev-4B est déjà un grand pas par rapport à Kev-0.8B : +5 points sur le sujet, +12 sur le risque (au niveau de Jev), tous les prompts multilingues justes. Il est d’accord avec Jev sur le sujet 90 % du temps. Mais seulement 19 % de ses réponses passent la barre de 0,8 (toutes justes !), donc le routeur ne lui fait pas confiance et surdimensionne 46 prompts. La même histoire de « juste mais timide » que Kev-0.8B.
Avec ma température (T = 0,46), 74 % des réponses deviennent confiantes, toujours justes à 95 %, l’ECE tombe à 0,080 et les routes identiques à gold passent de 39 % à 61 %. Mais quelque chose de nouveau apparaît : le routeur sous-dimensionne maintenant 14 prompts (Jev : 5). Le coût estimé tombe à 0,70 $, en dessous des 1,18 $ de gold. Moins cher que la bonne réponse, ce n’est pas une victoire, c’est un risque pour la qualité.
Pourquoi ? Regardez la complexité et le risque. Kev-4B tasse ses réponses vers le milieu : 17 des 21 prompts triviaux sortent en complexité 1, 8 des 10 prompts experts en dessous de 3, et 15 des 16 prompts à haut risque en risque 1. Tant que le routeur ne faisait pas confiance au sujet, ça ne comptait pas, puisqu’il relevait le plancher de toute façon. Dès qu’il fait confiance au sujet, ces scores tassés au milieu décident du plancher, et les prompts experts tombent sur des modèles trop bon marché.
La solution : mettre la température là où sont les scores#
Voici le détail qui m’avait échappé pendant un mois. La temperature de mon routeur ne remet à l’échelle que les réponses choice (le sujet). La complexité et le risque sont des scores, ils gardaient donc les distributions plates à T = 2,41 de Kev, et une distribution plate sur 0–3 a son espérance près du milieu. Voilà le tassement.
Kev lit KEV_TEMPERATURE au démarrage, et l’applique à toutes les réponses. J’ai donc redémarré le serveur avec 2,41 × 0,46 = 1,11 et lancé le bench sans température côté client :
- Les réponses de sujet sont les mêmes qu’avec T = 0,46 (mêmes probabilités, appliquées à un autre endroit) ;
- Le risque passe de 61 % à 74 %, devant les 61 % de Jev : 8 des 16 prompts à haut risque sont maintenant lus comme un risque 2, au lieu de 1 ;
- Les prompts experts lus en complexité 3 passent de 2 sur 10 à 6 sur 10 ;
- Les routes identiques à gold atteignent 67,5 % (Jev dans la même session : 69 %), avec 11 prompts sous-dimensionnés au lieu de 14.
C’est le plus près de Jev qu’un modèle ouvert soit arrivé sur le routage dans cette série, et la première fois qu’un modèle ouvert bat Jev sur le risque et l’égale presque sur les routes en même temps (Clef-flash battait Jev sur le risque, mais routait à 64 %).
Ce n’est pas une valeur optimisée, cela dit : 0,46 a été ajusté sur les réponses de sujet uniquement. Et la complexité reste le point faible : les prompts triviaux sont toujours lus en complexité 1 (16 sur 21), ce qui représente la plus grande partie de l’écart restant avec Jev.
Le revers : trois secondes, et un timeout#
Le premier passage avec KEV_TEMPERATURE=1.11 a perdu quatre prompts (dont trois longs) sur le timeout client de 60 secondes du bench, alors que le Mac avait environ 6 Go en swap. Comme ce passage mesure la qualité des décisions, pas la latence, le bench donne maintenant 180 secondes à Kev-4B, et le tableau montre le passage propre relancé. Mais ça raconte la vraie histoire : 2,6–3 s en p50 et jusqu’à 12,5 s en p90, ce n’est pas quelque chose qu’on met devant chaque requête sur cette machine. La version 4 bits de 3 Go devrait éviter le swap. C’est la prochaine chose à essayer.
Tous les modèles jusqu’ici#
Les mêmes 80 prompts, le même routeur, des soirées différentes. Le tableau complet, avec toutes les métriques et une vue prompt par prompt, est sur la page des résultats.
| Modèle (M4 de 16 Go sauf si hébergé) | Sujet | Risque | Route = gold | ECE | Latence p50 |
|---|---|---|---|---|---|
| Jev 1.13 (hébergé, épinglé) | 87,5–89 % | 60–61 % | 69–75 % | 0,067–0,099 | 207–364 ms |
| Jev 1.14 (hébergé) | 87,5 % | 65–66 % | 70–71 % | 0,059–0,072 | 192–199 ms |
| Clef-flash 9B 4 bits, T = 0,64 | 90 % | 76 % | 64 % | 0,072 | 4 017 ms |
Kev-4B bf16, KEV_TEMPERATURE=1.11 | 86 % | 74 % | 67,5 % | 0,084 | 2 979 ms |
| Laya fine-tuné (480 étiquettes), T = 0,87 | 85 % | 69 % | 64 % | 0,082 | 319 ms |
| Kev-0.8B, T = 0,47 | 81 % | 49 % | 39 % | 0,059 | 355 ms |
| Von 1.3 (archivé) | 70 % | 46 % | 48 % | 0,226 | 202 ms |
| Laya typed-decisions | 71 % | 34 % | 14 % | 0,509 | 304 ms |
| VegaML 0.8B, few-shot (40 étiquettes), T = 0,72 | 65 % | 64 % | 42,5 % | 0,138 | 862 ms |
| Laya anglais (0.3.6 = 0.3.24 = 0.4.2) | 59 % | 31 % | 21 % | 0,171 | 282 ms |
| VegaML 0.8B, zero-shot, T = 0,60 | 51 % | 54 % | 20 % | 0,092 | 1 337 ms |
Une page pour tout ça#
Jusqu’ici, la seule vue interactive était le rapport HTML d’un seul passage du bench, publié sur les GitHub Pages du projet, et il montrait encore le passage à sept fournisseurs de début octobre. Chaque article ajoutait un nouveau modèle dans un tableau markdown, et les résultats vivaient dans des fichiers JSON éparpillés dans cinq worktrees git.
Alors, comme je l’avais fait pour l’analyse solaire, les résultats ont maintenant leur propre page sur ce blog : /system-one-benchmark/. Elle est construite à partir des fichiers bruts du bench (23 passages, du 2 octobre au 9 novembre), avec des onglets pour :
- Classement : chaque modèle et chaque configuration, triables selon n’importe quelle métrique, avec un graphique sujet contre routage ;
- Jev 1.14 contre 1.13 : les quatre passages, le balayage du seuil et les prompts où les deux versions routent différemment ;
- Kev-4B : les trois réglages de température, avec les matrices de confusion de la complexité et du risque qui montrent le « tassement » ;
- Températures : ce qu’une température ajustée a apporté à chaque modèle ;
- Explorateur de prompts : les 80 prompts avec leurs étiquettes, et deux passages au choix côte à côte, les mauvaises réponses en surbrillance ;
- Écosystème : la chronologie de la série et des modèles que j’ai examinés sans les faire tourner.
Où est-ce que chacun a sa place ?#
- Jev 1.14 : de meilleures réponses, des routes plus chères. Je reste sur la 1.13 jusqu’à ce que les données de résultats disent le contraire. Attention :
jev-latestpointe déjà vers la 1.14, donc épinglez votre version si la stabilité des coûts compte pour vous. - Kev-4B : le meilleur modèle ouvert pour mon routeur, sur le papier. 86 % sur le sujet, 74 % sur le risque, 67,5 % de routes gold, Apache-2.0, multilingue. Sur un Mac de 16 Go, à 3 secondes par décision, c’est un outil de traitement par lots, pas un outil pour le chemin des requêtes. Sur un Mac de 32 Go ou un petit GPU, c’est le premier modèle ouvert que j’essaierais sérieusement en production.
- Laya : pas besoin de nouveau test. Le runtime continue de s’améliorer, et il devient une boîte à outils (avec VegaML dedans). Pour moi, la prochaine étape avec Laya, c’est un fine-tuning avec
laya-train. - Prochains candidats : d1-2B de LiquidAI (après avoir lu sa licence), Kev-4B en 4 bits, et peut-être à nouveau les têtes few-shot de VegaML sur le nouveau moteur vega-U.
Ce que j’en retiens#
- Vérifiez d’abord les poids, encore une fois. 28 versions de Laya, et un appel de deux lignes à l’API de Hugging Face m’a dit qu’il n’y avait rien à mesurer. Ça m’a fait gagner une soirée.
- Lancez deux fois un modèle distant. Jev 1.13 a bougé de 2,5 points sur route = gold entre deux passages, à dix minutes d’écart. Sans le second passage, je n’aurais pas pu dire si les différences de la 1.14 étaient réelles.
- Un meilleur classifieur n’est pas un routeur moins cher. La 1.14 gagne sur le risque et la calibration, et coûte quand même 10 % de plus, parce que le comportement du routeur dépend de la fréquence à laquelle le modèle est confiant, pas seulement de sa justesse.
- Mettez la température là où est l’incertitude. Une température côté client sur les seules réponses choice n’a corrigé que le sujet, et a fait sous-dimensionner Kev-4B. La même température, appliquée par le serveur à toutes les réponses, a aussi corrigé le risque. L’endroit où l’on calibre compte autant que la valeur.
- « Moins cher que gold », c’est un bug, pas une fonctionnalité. Un coût routé sous celui de la route gold veut dire que certains prompts ont reçu un modèle trop faible pour eux.
- Les modèles limités par la mémoire demandent des benchmarks patients. Le swap a transformé un modèle à 3 secondes en un p90 à 12 secondes et quatre timeouts. Mesurez la qualité avec des timeouts généreux, et la latence à part.
- L’écosystème explose. D’une poignée de noms en septembre à des dizaines de dépôts par jour. Un benchmark fixe, avec mes propres étiquettes, est le seul moyen que j’ai trouvé pour garder la tête hors de l’eau.
Le code et le compte rendu complet sont dans mmornati/system-one-router#13, avec les instructions d’installation dans docs/benchmark.md. Si vous faites tourner Kev-4B sur un Mac plus gros, ou la version 4 bits, j’aimerais beaucoup voir votre latence en commentaire.
Comment c’est fait#
Une session Claude Code avec Opus 5.5 sur le dépôt de system-one-router. Je lui ai demandé s’il y avait un nouveau modèle System One ou une nouvelle version de Laya qui méritait d’être testé, en gardant le même benchmark. Il a vérifié PyPI, Hugging Face et OpenRouter, comparé les dates des poids de Laya, lu les fiches d’une douzaine de candidats, et il est revenu avec une liste classée : Jev 1.14 et Kev-4B d’abord, d1 de LiquidAI ensuite, le reste écarté avec ses raisons. J’ai choisi « Jev 1.14 + Kev-4B ». Il a ajouté les fournisseurs au bench, lancé Jev deux fois, balayé le seuil, trouvé le piège de l’arrondi entre Python et Go, et écrit la documentation. Pour Kev-4B, il a demandé avant de cloner et d’installer du code externe, puis a lancé les trois configurations et suggéré la température côté serveur, que j’ai démarrée moi-même. Pour cet article, une deuxième session a lu cette transcription et les fichiers de résultats bruts, rédigé le texte, et construit la page des résultats. Ma part : choisir quoi tester, et démarrer les serveurs.