Mon précédent article racontait comment j’avais branché Jev, le modèle de décision de TypeSafe, sur Home Assistant pour répondre à la question que mes automatisations à seuils ne savent pas trancher (« est-ce que c’est normal ? ») : la pompe de relevage tourne longtemps parce qu’il a plu, ou parce que le flotteur est coincé ; l’eau coule à cause d’une douche, ou d’une fuite. La règle calcule toujours sa propre réponse, Jev ne fait que conseiller, et tout a démarré en mode shadow pour que je puisse lire les désaccords avant de lui faire confiance.
Cet article a reçu un commentaire sur Mastodon qui méritait mieux qu’une simple réponse. Merci à OneClickClaw pour ça :
@mmornati Feed the last few hours of readings to a small local model, it gets the context.
Bonne remarque. Mes prompts étaient vraiment des instantanés - l’humidité maintenant, le débit maintenant - et une douche et une petite fuite peuvent se ressembler pendant quelques secondes. Cet article raconte ce que j’en ai fait, et ce n’est pas ce que suggérait le commentaire. J’ai vraiment envisagé de faire tourner quelque chose en local, j’ai laissé tomber l’idée, et j’ai découvert que le vrai manque n’avait rien à voir avec le modèle qui répond à la question.
Pourquoi pas un petit modèle local, sur mon matériel#
La maison que je décrivais la dernière fois tourne toujours sur le même boîtier dont j’ai déjà parlé sur ce blog : un mini PC N100, 4 cœurs, 16 Go de RAM, sans GPU. Il fait déjà tourner Home Assistant Core, la base de données du recorder, Zigbee2MQTT, et tout ce que HAOS embarque avec. Pas d’accélérateur qui traîne, pas de second boîtier que j’aurais envie de dédier juste à ça.
Dans l’article sur le routeur qui a démarré tout ça, j’avais benchmarké Laya, un modèle open weights pensé exactement pour ce genre de décision typée, et les chiffres répondaient déjà à la question que je me poserais aujourd’hui : sur un GPU Apple, il est rapide, mais sur un CPU de la classe Raspberry - ce à quoi un N100 ressemble bien plus qu’à une machine avec GPU - comptez 1,5 à 3 secondes par appel. Mes décisions se déclenchent toutes les 5 minutes rien que pour la VMC, plusieurs tournent en parallèle (mode: parallel, volontairement, pour qu’un déclencheur qui yo-yote ne fasse pas la queue derrière un appel lent), et certaines partagent le boîtier avec le coordinateur Zigbee qui est censé réagir à un appui sur un bouton en temps réel. Quelques secondes de contention CPU, six fois par heure, en continu, ce n’est pas une erreur d’arrondi sur 4 cœurs - c’est une taxe sur ce que ce boîtier doit vraiment faire.
Et ça, c’est pour un modèle conçu pour être petit. Charger même un LLM généraliste distillé (un petit Llama ou Qwen) ajoute plusieurs gigaoctets de RAM qui restent en mémoire, sur une machine où 16 Go, c’est tout le budget, pas une marge. Les calculs de l’article précédent le disaient déjà clairement : le local n’a de sens que sur son propre matériel, et acheter un second mini PC pour économiser 3 $ par an, ce n’est pas un arbitrage sérieux.
La partie qui aurait été fausse même avec du meilleur matériel#
Voilà ce que je n’ai réalisé qu’en revérifiant les chiffres : l’idée du modèle local part du principe que le problème, c’était l’intelligence de Jev. Ce n’était pas ça. Jev a une fenêtre de contexte de 32k tokens, et j’en utilisais environ 565. Le plafond n’a jamais été le modèle - c’est que je ne lui envoyais que la valeur actuelle. Un petit modèle local avec une fenêtre de 512 tokens aurait tapé le même mur, juste plus vite.
Donc le correctif, ce n’était pas de remplacer Jev par autre chose. C’était d’arrêter de l’affamer.
Ce que j’ai construit à la place#
Cinq ajouts, tous à l’intérieur du même principe shadow/active, sans rien changer au modèle qui répond à la question.
1. Un historique compact, pas des relevés bruts#
Un nouveau script partagé, script.jev_history, appelle recorder.get_statistics de Home Assistant et rééchantillonne le résultat en petites séries qu’un modèle peut lire d’un coup d’œil - une valeur par pas de temps, plus le min, le max, et la plus grosse montée ou descente avec son horaire :
- action: script.jev_history
  data:
    sensors:
      water flow L/min: sensor.water_monitor_general_water_flow_l_min
      upstairs bathroom humidity %: sensor.temperature_sensor_salle_bain_etage_humidity_2
      parents' bathroom humidity %: sensor.temperature_sensor_salle_bain_parents_humidity_2
      kitchen humidity %: sensor.temperature_sensor_cuisine_humidity_2
    hours: 3
    every: 15
Ça fait environ 40 tokens par capteur au lieu de centaines d’états bruts et bruyants, et c’est exactement ce qui distingue une douche d’une fuite : une douche, c’est 8 à 12 L/min pendant dix minutes avec l’humidité de la salle de bain qui grimpe pendant cette fenêtre ; une fuite, c’est un débit faible et plat pendant des heures, sans rien d’autre qui bouge. jev_history tourne maintenant en amont des six décisions - pompe, eau, chute de température, volets, VMC, lessive.
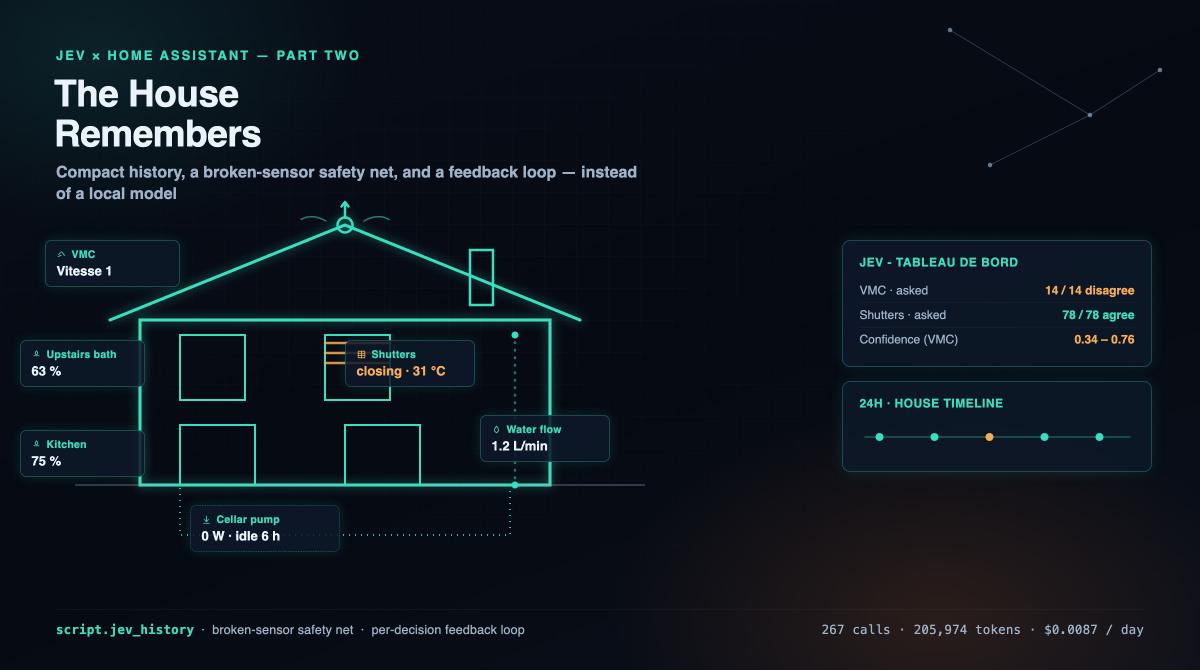
À côté, un sensor.house_timeline glissant sur 24 heures garde les 25 derniers événements de la maison (« la machine à laver a démarré », « quelqu’un est rentré », « VMC passée en Vitesse 2 ») sans jamais dire qui ni où précisément, pour qu’une décision voie aussi ce qui vient de se passer, pas seulement à quoi ressemblent les chiffres.
2. Une ligne de base d’humidité, parce que « élevé » est relatif#
Une pièce qui affiche toujours 72 % n’est pas en train de suer à 72 %, et souffler de l’air extérieur dedans ne sèche rien si cet air extérieur contient plus d’eau que la pièce elle-même. Deux nouveautés comblent ça : un capteur statistics qui suit la médiane sur 24 heures de chaque pièce d’eau, et un template qui transforme température et humidité relative en humidité absolue en g/m³ - le chiffre qui dit vraiment si ventiler va aider. La décision de la VMC reçoit désormais les deux, en plus des pourcentages bruts.
3. Un filet de sécurité pour le bug exact trouvé dans le dernier article#
La plus belle trouvaille accidentelle de l’article précédent, c’était que deux capteurs d’humidité étaient bloqués à 0 % depuis on ne sait combien de temps, en nourrissant silencieusement l’ancienne règle et Jev avec une valeur fausse. Ça ne devrait pas attendre un article de blog pour être repéré, donc il y a désormais un sensor_health.jinja partagé : chaque capteur dont dépend une décision est vérifié - absent, indisponible, hors d’une plage plausible, ou muet depuis trop longtemps. Quand l’un d’eux est cassé, Jev en est informé explicitement (« capteurs non fiables : humidité max du salon (valeur implausible) »), sa réponse n’est jamais retenue pour cet appel, et une safe_answer (en général « continue ce que tu faisais ») l’emporte aussi sur la règle - parce que la règle, elle, lit le même capteur cassé sans savoir qu’il ment.
4. Un interrupteur de mode par décision, plus un seul pour toute la maison#
input_select.jev_mode était un seul interrupteur pour six questions très différentes. C’est maintenant input_select.jev_mode_vmc, _eau, _pompe, _temperature, _volets, _linge, chacun réglé par défaut sur global (suivre l’interrupteur principal) mais capable de passer en active ou en off tout seul. Ça s’est avéré utile plus vite que prévu - voir les chiffres plus bas.
5. Une boucle de retour, pour ne pas devoir éplucher le logbook indéfiniment#
Chaque fois que Jev et la règle ne sont pas d’accord, une notification sur mon téléphone peut désormais demander « qui avait raison ? », avec deux boutons. La réponse déclenche un événement, qui atterrit sur un nouveau sensor.jev_scoreboard : par décision, combien de fois Jev a été interrogé, à quelle fréquence il n’était pas d’accord avec la règle, ce que le retour a dit, plus le coût en tokens. Une automatisation du dimanche soir lit ce tableau de bord, publie un résumé hebdomadaire, et remet le compteur à zéro pour la semaine suivante. J’ai aussi rédigé un petit process de revue (docs/jev-weekly-review.md) pour lire le logbook du mode shadow, le tableau de bord, et l’historique autour de chaque désaccord, et transformer ça en pull request - la même forme de session qui a construit la fonctionnalité au départ, cette fois pointée sur sa propre relecture.
Rien de tout ça n’a demandé un autre modèle, une seconde machine, ou d’abandonner le principe shadow. Il fallait juste envoyer à Jev les faits qu’une personne utiliserait vraiment pour juger la même situation.
Ce que la maison raconte, là maintenant#
J’ai récupéré ça en direct sur l’instance en écrivant cette section, donc c’est ce qui se passe vraiment, pas une estimation.
Aujourd’hui (26 septembre, relevé en milieu d’après-midi UTC) : 267 appels à Jev, 205 974 tokens en entrée, 0,0087 $ jusqu’ici. Sur la semaine écoulée, la moyenne journalière tourne autour de 116 appels et un coût médian d’environ 0,0027 $/jour - un jour calme et un jour chargé peuvent beaucoup différer, ce qui est attendu maintenant que la VMC ne demande que quand quelque chose a vraiment changé, plutôt que sur un minuteur fixe.
Le tableau de bord n’a que quelques heures (je l’ai remis à zéro à la mise en service), et il raconte déjà quelque chose d’utile :
| Décision | Interrogée | En désaccord avec la règle | Confiance de Jev |
|---|---|---|---|
| VMC (choix parmi 3 vitesses) | 14 | 14 (100 %) | 0,34 - 0,76, toujours sous la barre de 0,6 qui le laisserait agir |
| Volets (oui/non) | 78 | 0 (0 %) | toujours confiant |
En regardant directement le logbook du mode shadow sur les dernières 24 heures, ce n’est pas un hasard : sur environ 115 appels VMC, absolument tous étaient en désaccord avec la règle, toujours avec une confiance trop basse pour compter même en mode active, alors que tous les appels sur les volets étaient d’accord avec elle. Deux décisions, câblées de la même façon, qui se comportent de façon complètement différente. C’est exactement pour ça que l’interrupteur par décision existe : les volets pourraient passer en active dès aujourd’hui, il ne reste rien à vérifier ; la VMC ne le peut clairement pas encore, et maintenant j’ai un tableau de bord au lieu d’une simple intuition pour me le dire. Mon hypothèse, à vérifier la semaine prochaine : la règle de la VMC applique déjà de l’hystérésis sur les pics d’humidité courts, donc une bonne partie de ce qui ressemble à un « désaccord » est en fait Jev et la règle qui choisissent des vitesses différentes pendant le même transitoire, plutôt qu’une vraie erreur de l’un ou de l’autre - exactement le genre de chose que le process de revue hebdomadaire est fait pour creuser, une fois qu’une semaine complète de retours aura été lue.
« Ce n’est pas justement fait pour ça, le capteur bayésien ? »#
Un autre commentaire, sur le même fil que celui sur le modèle local, cette fois de Niall O’Callaghan :
@mmornati is this not what the Bayesian sensor is for?
Le capteur bayésien de Home Assistant fait « combiner plusieurs indices en une seule probabilité » depuis des années, entièrement en local, gratuitement. La question se pose légitimement, et la réponse honnête est : presque, mais pas tout à fait - et l’écart, c’est exactement les deux choses dont parle cet article.
Un capteur bayésien part d’un prior (à quelle fréquence la chose est vraie en général) et d’une liste d’observations - chacune une condition state, numeric_state ou template, avec deux chiffres que vous fournissez vous-même : prob_given_true et prob_given_false, la probabilité de voir cette observation si la chose est vraie ou fausse. Il les multiplie entre elles (naïf bayésien) et bascule sur on dès que le résultat dépasse probability_threshold. Entièrement local, instantané, gratuit, déterministe, et chaque chiffre est à vous, réglable sur votre propre historique.
Là où il retombe sur le même mur qu’un simple seuil :
- Il faut connaître les probabilités. « Quelle est la probabilité de 14 mm de pluie, sachant que la pompe se comporte normalement ? » est une estimation déguisée en chiffre, et une mauvaise estimation reste un chiffre qui a l’air sûr de lui.
- C’est binaire, un point c’est tout. Un capteur bayésien, c’est un seul
on/off. La décision VMC a besoin de choisir parmi trois vitesses, chacune avec sa confiance - c’estjev.choice, qui renvoie toute une distribution qui somme à 1. Pour arriver au même résultat avec des capteurs bayésiens, il en faudrait trois qui votent, sans aucune garantie que leurs probabilités s’additionnent à quelque chose de sensé. - Les chiffres deviennent des tranches, et les indices sont supposés indépendants. Une observation
numeric_statene se déclenche qu’au-dessus ou en dessous d’une ligne, donc 11 L/min et 25 L/min tombent dans la même tranche. Et l’humidité de la salle de bain qui grimpe parce que l’eau coule, c’est deux morceaux du même fait, comptés deux fois, sauf à penser soi-même à modéliser ce lien. - Il ne sait pas quand ses propres entrées mentent. Donnez-lui le capteur d’humidité resté bloqué à 0 % on ne sait combien de temps, et il multiplie ce mensonge dans la probabilité finale avec exactement la confiance que vous avez configurée - comme le faisait l’ancienne règle de la VMC. Le filet de sécurité
sensor_health.jinja, plus haut dans cet article, existe précisément parce que rien dans le capteur bayésien lui-même n’aurait détecté ça. - Pas de mémoire non plus. Un capteur bayésien raisonne sur l’état actuel de ses observations, pas sur « l’humidité a grimpé de 6 points en 15 minutes puis s’est maintenue » - exactement la forme que
script.jev_historyexiste pour décrire.
Rien de tout ça n’en fait un mauvais outil. Pour un signal qu’on comprend déjà bien et qu’on veut garder entièrement hors-ligne et déterministe - la présence détectée par des capteurs de mouvement et d’ouverture est l’exemple classique - un capteur bayésien réglé à la main reste vraiment le meilleur choix : pas d’appel réseau, pas de coût par appel, la même réponse à chaque fois. Les deux se combinent d’ailleurs très bien : la probabilité d’un capteur bayésien peut devenir une ligne de plus dans les faits envoyés à Jev, et l’action jev.calibrate de HA-Jev - qui compare l’historique d’un capteur de probabilité avec ce qui s’est réellement passé - peut suggérer un seuil, récupérant un peu de cet avantage « réglé sur ma propre maison » qu’a un capteur bayésien fait main et qu’un modèle généraliste n’a pas au départ.
À essayer ensuite#
Deux choses que je n’ai pas encore faites, et qui découlent naturellement de ce qui existe déjà :
- Calibrer la VMC avec son propre historique. L’action
jev.calibratede HA-Jev compare les valeurs passées d’un capteur de probabilité à ce qui s’est réellement passé, et suggère un seuil. Avec un tableau de bord et un logbook qui grossissent, la décision VMC a enfin assez de ses propres données pour être calibrée dessus, au lieu de dépendre de la calibration générale de Jev. - Donner le même historique à Laya, en shadow, gratuitement. L’idée du modèle local n’avait pas tort de vouloir du contexte - elle se trompait juste de niveau. Maintenant que
jev_historyproduit une petite série JSON rééchantillonnée pour chaque décision, c’est aussi exactement ce dont un modèle local à 512 tokens aurait besoin, et c’est pas cher à essayer : journaliser une troisième colonne à côté de Jev et de la règle, sans notification sur le téléphone, juste des chiffres à comparer dans quelques semaines.
Si vous faites tourner Jev ou un modèle de décision équivalent sur vos propres automatisations, j’aimerais savoir si vous êtes tombés sur la même chose - que ce qui manquait, c’était la mémoire, pas l’intelligence. Dites-le-moi en commentaire, ou répondez sur Mastodon comme la dernière fois.