Il y a une semaine, j’ai terminé l’article sur Clef-flash en disant que j’ajouterais le prochain candidat au benchmark lors du prochain passage complet. Le candidat suivant est venu, une fois de plus, d’un nom familier : Nandakishor M, l’auteur de Laya, a publié un deuxième modèle « System One », VegaML. Et Laya lui-même a enchaîné huit nouvelles versions entre-temps.
C’est le cinquième article de la série. Si vous arrivez ici :
- system-one-router : une passerelle en Go qui pose quatre questions typées à un modèle de décision « System One » sur chaque prompt (sujet, complexité, risque, données privées) et choisit le LLM le moins cher capable d’y répondre, avec un benchmark de 80 prompts de Jev contre Laya ;
- Jev dans Home Assistant et sa suite : le même genre de modèle qui juge les automatisations de ma maison ;
- Laya contre Jev, dix jours plus tard : de nouveaux modèles ouverts (Von, Kev), une température de confiance, et un fine-tuning de Laya sur mon MacBook ;
- Clef-flash contre Jev : le modèle de décision de 9B de Cloudflare, le premier modèle ouvert à égaler Jev sur le sujet, mais à 4 secondes par décision sur mon portable.
Celui-ci a deux parties : une courte mise à jour sur Laya, puis VegaML en détail.
Laya 0.3.24 → 0.4.2 : huit versions, les mêmes réponses#
Entre le 3 et le 10 octobre, Laya est passé de la 0.3.24 à la 0.4.2. Comme la dernière fois, la première question était : est-ce que le modèle a changé, ou seulement le code autour ?
Seulement le code. Le dernier commit qui touche les poids sur Hugging Face (convaiinnovations/laya) date du 19 septembre. Les trois fichiers model.safetensors ont les mêmes hashes, et le seul commit sur le Hub depuis mon passage précédent ajoute un config.json à la racine pour que les téléchargements soient comptés. Je ne m’attendais donc pas à ce que quoi que ce soit bouge, mais j’ai vérifié quand même : les mêmes 80 prompts, les quatre colonnes Laya, sur la 0.4.2.
Chaque sujet, niveau de complexité, niveau de risque et confiance est identique au passage en 0.3.24, sur les 80 prompts et les quatre checkpoints. La plus grande différence de confiance est de 0,0000. L’histoire de l’entraînement et les résultats attendus des articles précédents ne changent pas : Laya en zero-shot est toujours à 59 % sur le sujet et toujours trop peu sûr de lui pour le routeur, et le fine-tuning reste le moyen de le rendre utile.
Ce qui a changé en amont, et pourquoi ça n’atteint pas le benchmark :
| Changement | Effet sur le benchmark ? |
|---|---|
0.4.0, rupture de compatibilité : laya.Router envoie désormais le texte dont il ne détecte pas la langue vers le checkpoint multilingue au lieu de l’anglais | Non. Mon sidecar fait son propre routage par langue pour laya-auto avec laya.detect_language(), et n’utilise pas Router. |
Corrections de detect_language : les acronymes anglais comme MON ou EST ne sont plus lus comme du français ; un mot qui est anglais et aussi un mot-outil étranger ne compte qu’une fois | Ça aurait pu faire bouger un ou deux prompts laya-auto. Ça ne l’a pas fait. |
Recalibration par histogramme, vérifications de min_confidence plus strictes | Non. Aucun checkpoint publié n’est livré avec de nouveaux fichiers de calibration. |
| Disposition « parallèle » des options, optionnelle et indépendante de l’ordre | Non. Il faut un checkpoint réentraîné ; ceux qui sont publiés restent séquentiels. |
Nouvelle CLI laya-train, SDK Java et .NET, LAYA_EXTRA_MODELS, déchargement en cas d’inactivité | Pas pour les chiffres. laya-train est intéressante pour le prochain fine-tuning. |
Le sidecar est maintenant épinglé sur laya==0.4.2. Si vous faites tourner Laya avec le sidecar de system-one-router, la mise à jour est sans risque.
Une chose a bien changé dans le rapport, et c’est un bon rappel du fonctionnement du benchmark : sur 6 à 19 prompts par checkpoint, le modèle routé est différent de celui du 2 octobre, alors que les décisions sont les mêmes. La cause, ce sont les prix d’OpenRouter. DeepSeek V4.1 Flash est passé de 0,02 $/0,60 $ à 0,30 $/1,20 $ par million de tokens, donc GPT-5.6 Luna remporte maintenant ces places, pour tous les fournisseurs et pour la route de référence aussi. Le routeur lit les prix en direct, donc la même décision peut mener à un modèle différent la semaine prochaine. C’est voulu.
VegaML en bref#
VegaML est apparu sur GitHub et PyPI le 9 octobre, et est passé de la 0.1.0 à la 0.8.0 en deux jours. Il est sous Apache-2.0, publié comme paquet Python vegaml, avec les deux tailles dans un seul dépôt Hugging Face (nandakishorm/vega-08b-public-intents). Le README ne mentionne pas Laya, mais l’auteur est le même.
Le principe est le même que pour Jev, Laya, Kev et Clef : on lui donne un état (un ticket, un prompt, une mesure de capteur) et des questions typées dont l’espace de réponses est fixé à l’avance, et il renvoie une réponse que votre code peut utiliser directement, avec des probabilités. Aucun texte n’est généré. Trois types de questions :
choice: une option parmi un ensemble que vous définissez (mon sujet) ;score: un niveau entier selon des critères ordonnés, plus une valeur attendue (ma complexité et mon risque) ;boolean: la probabilité qu’une affirmation soit vraie (mes données privées). Il s’appelaitnouldans les premières versions, le même nom que dans l’API de Jev, et a été renommé en 0.5.0.
Ce qui change, c’est la façon d’arriver à la réponse. Laya fine-tune un ModernBERT entier. Kev et Clef posent une tête entraînée sur un modèle de langage. VegaML garde le modèle de langage complètement gelé et ajoute par-dessus un petit « moteur physique » :
- L’état, la question et les options vont dans un seul prompt, sans chat template. Le Qwen3.5 gelé le lit une fois. VegaML récupère les états cachés de deux couches internes (13 et 19 pour le 0.8B) et s’arrête là : la tête du modèle de langage ne tourne jamais.
- Les vecteurs agrégés placent une particule dans un « espace de décision » à 64 dimensions, avec une position de départ et une impulsion.
- Chaque réponse possible devient une vallée (un puits gaussien) dans cet espace. Pour les questions
score, les niveaux sont alignés, donc le niveau 2 est physiquement à côté des niveaux 1 et 3. - La particule roule selon une dynamique amortie pendant un budget fixe de 12 étapes (avec sortie anticipée), et la réponse est la vallée où elle se pose. Les probabilités viennent de sa distance finale au fond de chaque vallée.
Le titre de l’article de blog de l’auteur le dit bien : un modèle de décision qui fait rouler une bille en bas d’une pente. Le moteur est petit : 14,3M de paramètres (57 Mo) pour le 0.8B, 30,9M pour le 4B, sans couches d’attention. Il est entraîné sur le comportement de stabilisation, pas sur la prédiction du token suivant. Deux petits adaptateurs de type LoRA (environ 5 Mo à eux deux) se greffent sur le moteur, et une porte décide pour chaque question s’ils aident.
La physique n’est pas qu’un gadget. Elle produit plusieurs signaux de sécurité qui reviennent avec chaque réponse :
- Une température par décision. Une particule qui bouge encore à la fin, ou qui s’est arrêtée loin de toutes les vallées, reçoit une température plus « chaude », donc une réponse moins confiante.
- Des ensembles conformes. Pour un niveau de risque α (par exemple 0,1), l’ensemble des réponses qui devrait contenir la bonne 90 % du temps.
- Abstain, un indicateur quand la confiance est sous un plancher ajusté.
- Unbound, un indicateur quand la particule s’est posée loin de toutes les vallées : la façon du modèle de dire « cette question sort de ce que je connais ».
Et il y a la fonctionnalité qui a attiré mon attention : fit(). Donnez-lui des exemples étiquetés (la documentation parle d’environ 20 par question) et il entraîne une petite tête par question, la valide par validation croisée, et écarte toute tête qui ne fait pas mieux que le hasard. Pas de session d’entraînement, pas d’heures de GPU. Ensuite, on choisit un mode :
| Mode | Ce qu’il fait |
|---|---|
engine | Zero-shot. Calibration, ensembles conformes et abstain. C’est le mode derrière tous les chiffres publiés. |
auto | Le mode par défaut depuis la 0.7.0 : utiliser une tête ajustée là où elle bat le hasard, le moteur partout ailleurs. Sans rien d’ajusté, c’est le moteur. |
ttt | Têtes ajustées uniquement. Plus tranchant sur leurs étiquettes, mais sans calibration ni abstain. |
both | Les deux lectures côte à côte. |
Quelques autres choses à savoir :
- Deux tailles. 0.8B (sur Qwen3.5-0.8B, une base de 1,77 Go) et 4B (sur Qwen3.5-4B, 9,34 Go).
- Contexte long : 73 728 tokens. Les états de 4 096 tokens ou plus sont lus une fois et mis en cache, donc poser douze questions sur un long contrat coûte à peu près une lecture. Les entrées trop longues sont refusées, pas tronquées en silence.
- Images.
decide_imagelit une image via l’encodeur visuel gelé de la base. Ça fonctionne depuis la 0.8.0 ; l’auteur précise que les benchmarks publiés ne le couvrent pas. - Vues.
views=2ou3relit l’entrée avec les options inversées ou l’état reformulé, et fait la moyenne. Ça coûte environ deux ou trois fois plus. Tous les chiffres publiés utilisentviews=1. - Langues : non précisées. Les adaptateurs ont été entraînés sur LocalLLaMA/typed-decisions, qui est en anglais.
À quoi il sert, selon l’auteur#
Le README est d’une honnêteté rafraîchissante sur ce point. L’auteur ne prétend pas que VegaML bat Jev en précision ; il dit que Jev gagne en précision partout. Ce que VegaML propose à la place, ce sont des probabilités honnêtes, une réponse à chaque requête (pas de « max tokens exceeded »), une faible latence, et tout qui tourne en local, sans que rien ne quitte la machine.
Les exemples de cas d’usage sont le routage d’un e-mail ou d’un ticket vers une équipe, le score de risque de churn, la classification d’un document à partir de son image, et le fait de poser beaucoup de questions sur un très long contrat. Les domaines où il s’en sort le mieux sont les tâches de filtrage courtes : phishing (son meilleur résultat lors d’un passage précédent), spam, injection de prompt, toxicité, et les tâches avec des espaces d’étiquettes très larges, où le moteur aide le plus la petite base (151 intentions sur CLINC150 : 0,900 avec le moteur contre 0,100 pour la base seule).
Les benchmarks de l’auteur#
Les chiffres actuels (README et bench/RESULTS.md) viennent d’un passage terminé le 11 octobre sur deux Tesla T4 sur Kaggle : mode engine en zero-shot, 3 841 décisions par système, et Jev appelé en direct via l’endpoint jev-latest de TypeSafe pour chaque ligne.
| Vega 0.8B | Vega 4B | Jev | |
|---|---|---|---|
| Menu public, 43 tâches (moyenne macro) | |||
| Précision | 0,556 | 0,717 | 0,836 |
| F1 macro | 0,486 | 0,649 | 0,796 |
| ECE (plus bas = mieux) | 0,151 | 0,148 | 0,115 |
| Latence p50 | 74 ms | 106 ms | 162 ms |
| JevBench, 231 éléments | |||
| Précision | 0,545 | 0,662 | 0,866 |
| ECE | 0,178 | 0,169 | 0,067 |
| Cohérence sur les paraphrases | 0,694 | 0,722 | 0,972 |
| DecisionBench, 1 075 éléments | |||
| Précision | 0,509 | 0,633 | 0,752 |
| Couverture | 1,000 | 1,000 | 0,997 |
| ECE | 0,103 | 0,098 | 0,122 |
| Latence p50 | 85 ms | 245 ms | 163 ms |
Donc, sur les propres suites de l’auteur, Jev est nettement devant en précision, et VegaML est compétitif sur la calibration (meilleur que Jev sur DecisionBench, où la confiance moyenne de Jev est de 0,874 pour une précision de 0,752) et plus rapide sur un GPU.
Avec l’adaptateur typed-decisions, sur la partie test du dataset sur lequel il a été entraîné (2 050 décisions), le tableau est bien meilleur : 76,3 % de précision et une ECE de 0,026 pour le 0.8B, 80,3 % et 0,019 pour le 4B, à 22–28 ms par décision. C’est le VegaML « spécialisé », sur des données de son domaine : le même moteur 0.8B sans l’adaptateur obtient 38,9 % sur la même partie.
Le README liste aussi, tâche par tâche, là où il bat Jev : 4 tâches sur 43 pour le 0.8B et 12 sur 43 pour le 4B (classification de spam, de jailbreak et de toxicité, injection de prompt, équité des conditions d’utilisation, quelques tâches sur des tweets). Puis, et c’est tout à son honneur, l’auteur explique pourquoi la plupart de ces victoires ne comptent pas : 8 des 12 portent sur 3 lignes ou moins, deux ont un problème de classe majoritaire, et seule l’injection de prompt survit à un test de significativité. Lors d’un passage précédent, en face de Jev 1.13, VegaML a attrapé 252 e-mails de phishing sur 400 contre 99 pour Jev (avec une précision plus faible : 0,84 contre 0,96), et était 2,1 fois plus rapide : 280 ms par décision sur un Apple série M en fp32, contre 591 ms pour Jev hébergé.
La page RESULTS liste aussi des « vrais constats contre Vega », ce que j’ai apprécié :
- Les ensembles conformes sous-couvrent : sur le menu public, les ensembles à 90 % contiennent la bonne réponse 70,5 % du temps pour le 0.8B (77,1 % pour le 4B).
- L’ordre des options compte : inverser les options change la réponse sur 70 % des lignes d’un benchmark juridique pour le 0.8B.
- La base seule (Qwen3.5 qui génère la réponse) est à peu près aussi précise que VegaML sur ces suites (0,523 contre 0,556 pour le 0.8B). La conclusion de l’auteur est que la contribution du moteur, c’est la couverture, les probabilités, la calibration, l’abstention et environ un tiers de la latence, pas la précision.
Je n’ai trouvé qu’un seul test indépendant : un petit benchmark d’extraction d’information où le 0.8B a obtenu 9 sur 12, mais où l’indicateur abstain a attrapé les six mauvaises réponses. Il existe aussi un portage ONNX en 8 bits qui tourne dans le navigateur. Personne n’avait encore publié de chiffres de routage. Place aux miens.
Est-ce que ça tourne sur mon Mac ?#
Le 0.8B, oui. Le 4B, non. VegaML ne tourne qu’en fp32, et le 4B demande environ 16,5 Go de RAM en fp32 (c’est le chiffre du testeur indépendant ; l’auteur ne donne que la taille de la base). Sur un M4 de 16 Go, c’est la même histoire que Kev-4B et Clef 27B.
Trois choses à savoir avant de commencer :
- Il n’y a pas de serveur
/v1/systemone. Laya, Von, Kev et Clef-flash parlent tous le format HTTP de Jev, donc les ajouter revenait à ajouter une URL. VegaML est une API Python (vegaml.load(...).decide(state, questions)), il a donc fallu un petit sidecar : sidecar/vega_server.py, 130 lignes. Il renommenoulenbooleanà l’entrée,probsenprobabilitiesetexpected_scoreenscoreà la sortie, et transmet tels quels les champsabstain,prediction_setetunboundde VegaML. - Par défaut, il utilise CUDA, puis le CPU. Sur un Mac, il faut passer
device="mps"pour utiliser le GPU. - Il demande
transformers>=5.17, il a donc son propre environnement virtuel au lieu de partager celui de Laya.
uv venv --python 3.12 sidecar/.venv-vega && uv pip install --python sidecar/.venv-vega/bin/python vegaml==0.8.0
sidecar/.venv-vega/bin/python sidecar/vega_server.py                                  # :8793, zero-shot ("engine")
sidecar/.venv-vega/bin/python sidecar/vega_server.py --mode auto --fit examples.jsonl # with fitted heads
go run ./cmd/bench -providers jev,vega
Le premier démarrage télécharge la base Qwen3.5-0.8B (environ 2 Go), que VegaML vérifie contre un SHA-256 épinglé. Côté benchmark, c’est un nouveau fournisseur vega et une option -vega-url, avec la même limite de 6 000 caractères d’état que Jev, Von, Kev et Clef-flash.
Le test standard, encore une fois#
Pour les nouveaux venus, et parce que les détails comptent pour lire les résultats, voici ce que fait le benchmark. cmd/bench envoie 80 prompts étiquetés à chaque fournisseur de décision, avec le même routeur et la même configuration :
- 57 tâches de développement courantes (code, revue, débogage, SQL, infra, architecture, rédaction, discussion) ;
- 8 prompts dans d’autres langues (français, espagnol, allemand, italien, japonais, chinois, portugais) ;
- 4 entrées de plus de 512 tokens ;
- 7 prompts pièges ou ambigus (« fix it », « can you make it faster? », une injection de prompt…) ;
- 4 avec des données privées (des tokens, une URL de base de données avec un mot de passe, un dossier patient).
Chaque prompt reçoit les quatre questions du routeur en une seule requête : sujet (un choice parmi 10 options : code-gen, code-review, debugging, security, docs, data-sql, infra-devops, architecture, writing, chat), complexité (un score de 0 à 3), risque (un score de 0 à 2) et données privées (un noul/boolean). À partir des réponses, le routeur calcule un plancher de qualité, le relève quand la confiance sur le sujet est sous 0,8, et choisit le modèle le moins cher au-dessus du plancher parmi cinq modèles OpenRouter, de Qwen 3.7 Flash à Claude Opus 5.5.
Aucun prompt n’est envoyé à un modèle de chat. Le benchmark ne compare que des décisions. La référence est la route gold : le modèle que le routeur choisit quand on lui donne les étiquettes humaines au lieu des réponses d’un modèle. Les métriques :
- Précision du sujet, de la complexité et du risque par rapport aux étiquettes (la complexité aussi « à ±1 ») ;
- Réponses confiantes : la part des réponses de sujet à 0,8 ou plus, et combien sont justes ;
- ECE (erreur de calibration attendue) : l’écart entre la confiance annoncée et la précision réelle. Plus bas = mieux ;
- Route = gold : combien de fois le modèle routé est exactement celui de la route de référence, et combien de fois il est moins cher (sous-dimensionné, un risque pour la qualité) ou plus cher (surdimensionné, de l’argent gaspillé) ;
- Latence de la décision elle-même, p50 et p90.
Jev a été relancé dans la même session comme référence, ses chiffres bougent donc un peu d’un article à l’autre (de 70 % à 75 % de routes identiques à la référence sur les derniers passages, le bruit d’un modèle distant sur 80 prompts, plus le changement de prix vu plus haut).
Passage 1 : VegaML en zero-shot#
Le premier passage est la configuration qu’utilisent les chiffres de l’auteur : mode="engine", views=1. Voici le résumé du rapport HTML :

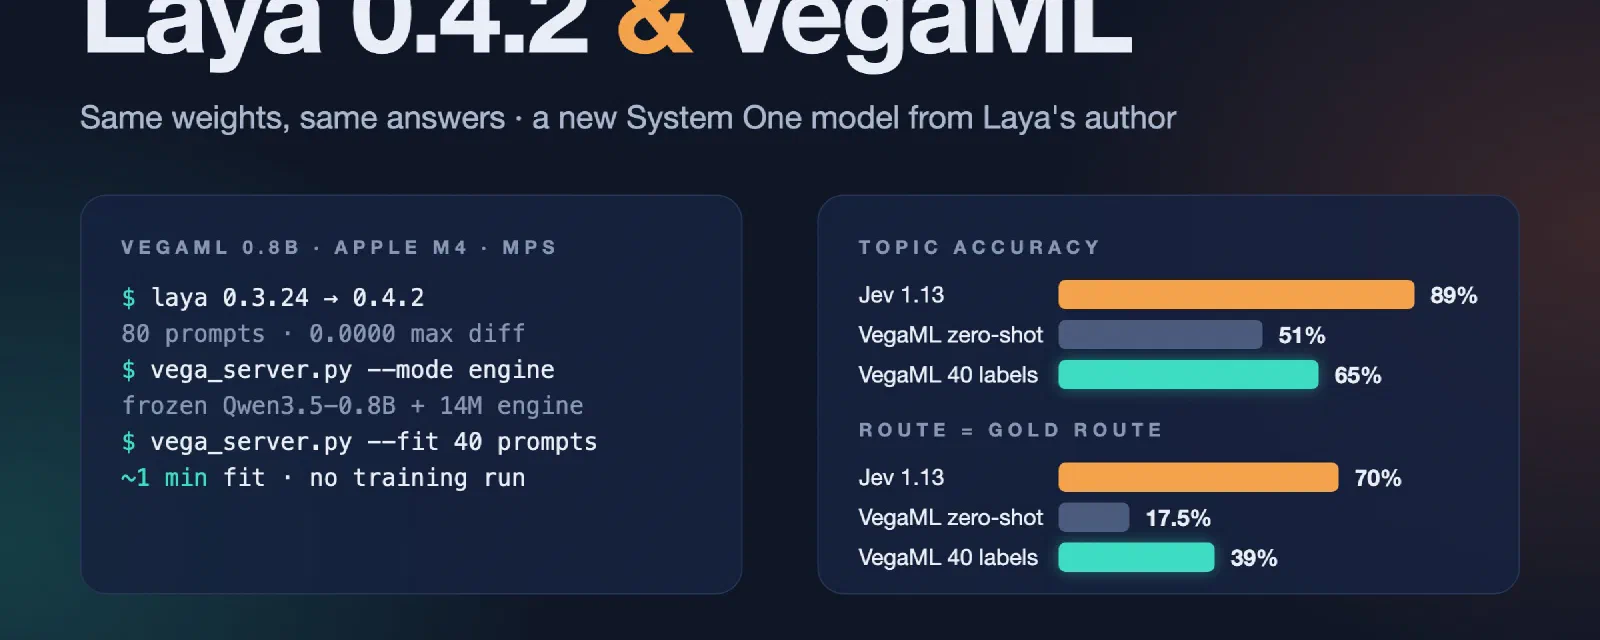
51 % de précision sur le sujet. C’est en dessous de tous les modèles ouverts que j’ai testés, sauf Laya multilingue (45 %), et 0 % sur le groupe des pièges. La complexité et le risque sont un peu meilleurs que ceux de Laya (42,5 % et 54 %), et les données privées sont détectées 92 % du temps. Mais seule une réponse sur 80 atteint la barre de confiance de 0,8 du routeur. Comme avec Laya en zero-shot, le routeur joue la sécurité, relève le plancher de qualité, et envoie presque tout vers Sonnet :

59 prompts partent vers un modèle plus cher que la référence, et seulement 17,5 % correspondent à la route gold. Les lignes prompt par prompt montrent le schéma : hello (« hey, how are you today? ») est lu comme du debugging à 20 %, git-undo comme de la docs à 21 %. Même quand VegaML trouve le bon sujet (py-csv, rename-var), il le fait avec 26–32 % de confiance, ce à quoi le routeur ne peut pas se fier.

Pourquoi un tel écart avec les résultats de l’auteur ? Je pense que la tâche en est la raison. Ses victoires portent sur du filtrage binaire ou à peu de classes (phishing oui/non, spam oui/non, un sujet d’actualité parmi quatre). Ma question de sujet est un choix entre 10 options avec des catégories qui se recouvrent : un prompt « écris une regex » est du code-gen, mais un lecteur raisonnable pourrait dire code-review ou debugging. C’est exactement le genre de question où l’écart de JevBench, 0,866 pour Jev contre 0,545 pour VegaML, se manifeste.
Les signaux de sécurité aident-ils le routeur ?#
L’argument de vente de VegaML, ce sont ses signaux d’incertitude, j’ai donc vérifié chacun d’eux par rapport au seuil de confiance du routeur :
abstainsignale 72 des 80 réponses de sujet. Ces 72 sont justes 47 % du temps ; les 8 qu’il garde sont justes 88 % du temps. C’est donc un signal correct, mais il dit la même chose que le seuil de 0,8 : « je ne suis pas sûr », presque tout le temps.unboundn’apporte aucun signal ici : les réponses signalées et non signalées sont justes 51 % et 52 % du temps.- Les ensembles conformes à α = 0,1 ne contiennent qu’une seule option et incluent le sujet de référence 54 % du temps au lieu de 90 %. La calibration livrée ne se transfère pas à mes questions, ce qui rejoint la sous-couverture que l’auteur signale sur ses propres suites.
Passage 2 : une température de confiance#
Dans l’article sur Laya, j’avais ajouté une temperature optionnelle par fournisseur : diviser les logits par T avant le softmax. Ça ne change jamais la réponse gagnante, seulement l’assurance du modèle. Ça avait corrigé Kev, le Laya fine-tuné et Clef-flash. Même méthode : minimiser la log-loss sur la moitié des prompts, mesurer sur l’autre moitié, 20 découpages aléatoires. Le script a retrouvé la valeur précédente de Kev (0,45 contre 0,47, assez proche pour une grille grossière), et a donné T = 0,60 pour VegaML.
| VegaML zero-shot | VegaML, T = 0,60 | Jev 1.13 | |
|---|---|---|---|
| Précision du sujet | 51 % | 51 % (inchangée) | 89 % |
| Réponses confiantes (≥ 0,8) | 1 % | 19 % (93 % justes) | 84 % (94 % justes) |
| Erreur de calibration | 0,162 | 0,092 | 0,074 |
| Route = gold | 17,5 % | 20 % | 70 % |
| Moins cher / plus cher que gold | 7 / 59 | 11 / 53 | 4 / 20 |
La calibration s’améliore beaucoup (0,162 → 0,092), mais une température ne peut pas créer une précision qui n’existe pas : 51 % reste 51 %, et les routes bougent à peine. Kev avait le problème inverse : juste mais timide. VegaML en zero-shot est surtout incertain parce qu’il se trompe souvent, et le dire est la réponse honnête.
Passage 3 : des têtes few-shot à partir de 40 prompts étiquetés#
C’est la partie qui m’intriguait le plus, et la raison pour laquelle VegaML mérite un article plutôt qu’une ligne dans un tableau. Aucun des autres modèles ne peut apprendre de mes étiquettes sans une session d’entraînement. Le fit() de VegaML prétend le faire en une minute environ.
Pour le mesurer honnêtement, je ne pouvais pas ajuster sur les 80 prompts et tester sur les mêmes 80. Donc :
- Les 80 prompts ont été divisés en deux moitiés, A et B, stratifiées par sujet.
- Le sidecar a reçu une option
--fit: il lit des exemples étiquetés (état, étiquettes, questions) et appellefit()avant de servir en modeauto. - Les têtes ajustées sur A ont répondu aux prompts de B, puis les têtes ajustées sur B ont répondu à A. Les deux moitiés sont regroupées, donc chaque prompt est noté par des têtes qui ne l’ont jamais vu.
Un piège en chemin : Go sérialise les maps avec les clés triées, donc le routeur envoie les options de sujet par ordre alphabétique. Le fichier d’ajustement doit utiliser le même ordre, sinon les caractéristiques des têtes ne correspondent pas aux questions au moment de servir.
Ajuster 40 exemples prend environ une minute sur le M4. Sur la moitié A, la validation croisée de VegaML lui-même annonçait 84 % pour la tête de sujet, 53 % pour la complexité et 70 % pour le risque. La tête des données privées a été écartée sur une des moitiés (trop peu d’exemples privés pour battre le hasard), c’est donc le moteur qui a répondu à cette question, ce qui est exactement le rôle du mode auto.
| Jev 1.13 | VegaML zero-shot | VegaML têtes few-shot (prompts mis de côté) | few-shot, T = 0,72 | |
|---|---|---|---|---|
| Précision du sujet | 89 % | 51 % | 65 % | 65 % |
| Sujet : core / multilingue / long / piège | 95 % / 88 % / 75 % / 43 % | 56 % / 62 % / 75 % / 0 % | 63 % / 62 % / 100 % / 57 % | idem |
| Complexité exacte / à ±1 | 71 % / 100 % | 42,5 % / 94 % | 54 % / 96 % | idem |
| Risque exact | 61 % | 54 % | 64 % | 64 % |
| Réponses confiantes (≥ 0,8) | 84 % (94 % justes) | 1 % | 10 % (88 % justes) | 24 % (84 % justes) |
| Erreur de calibration | 0,074 | 0,162 | 0,186 | 0,138 |
| Route = gold | 70 % | 17,5 % | 39 % | 42,5 % |
| Moins cher / plus cher que gold | 4 / 20 | 7 / 59 | 2 / 47 | 6 / 40 |
| Latence de décision p50 / p90 | 364 / 436 ms | 1 344 / 1 703 ms | 862 / 977 ms | idem |
Avec 40 étiquettes et une minute d’ajustement, sur des prompts que les têtes n’ont jamais vus :
- Le sujet passe de 51 % à 65 %, et le groupe des pièges de 0 % à 57 % (Jev : 43 %) ;
- Le risque atteint 64 %, au-dessus des 61 % de Jev, la même chose que j’avais vue avec le Laya fine-tuné : des étiquettes écrites avec mes conventions apprennent ma vision du risque ;
- Les routes identiques à gold font plus que doubler, de 17,5 % à 39 %, et à 42,5 % avec une température ;
- et il devient plus rapide : une tête ajustée remplace le moteur pour sa question, donc 0,86 s au lieu de 1,34 s.
Les têtes manquent encore d’assurance (10 % des réponses au-dessus de 0,8), et les têtes ajustées n’ont pas de calibration, par conception. Une température (T = 0,72, ajustée sur les réponses mises de côté regroupées, donc dans l’échantillon pour T, comme les autres lignes « bench complet ») aide un peu. On reste loin de Jev, et en dessous des 81 % de Kev-0.8B sur le sujet en zero-shot.
Pour donner l’échelle, le fine-tuning de Laya avait demandé 480 prompts étiquetés et 41 minutes pour atteindre 85 % sur le sujet et 64 % de routes identiques à gold. VegaML arrive à 65 % et 39 % avec 40 prompts et une minute. Ce n’est pas la même expérience (le fine-tuning de Laya s’entraînait sur un ensemble de prompts séparé ; ici, les deux moitiés du benchmark se relaient), mais le compromis est clair : VegaML est un moyen peu coûteux d’obtenir quelque chose à partir d’une poignée d’étiquettes ; un vrai fine-tuning reste le moyen d’obtenir un modèle avec lequel on peut router.
Tous les modèles jusqu’ici#
Les mêmes 80 prompts, le même routeur, des soirées différentes. Jev est la référence de chaque passage, comparez donc chaque modèle avec sa propre colonne Jev dans les articles précédents pour les détails fins.
| Modèle (M4 de 16 Go sauf si hébergé) | Sujet | Route = gold | ECE | Latence p50 |
|---|---|---|---|---|
| Jev 1.13 (hébergé) | 89 % | 70–75 % | 0,068–0,080 | 258–364 ms |
| Clef-flash 9B 4 bits, T = 0,64 | 90 % | 64 % | 0,072 | 3 854 ms |
| Laya fine-tuné (480 étiquettes), T = 0,87 | 85 % | 64 % | 0,082 | 319 ms |
| Kev-0.8B, T = 0,47 | 81 % | 39 % | 0,059 | 371 ms |
| Von 1.3 | 70 % | 48 % | 0,226 | 216 ms |
| Laya typed-decisions | 71 % | 12 % | 0,509 | 334 ms |
| VegaML 0.8B, few-shot (40 étiquettes), T = 0,72 | 65 % | 42,5 % | 0,138 | 862 ms |
| Laya anglais (0.4.2 = 0.3.24) | 59 % | 20 % | 0,171 | 300 ms |
| VegaML 0.8B, zero-shot, T = 0,60 | 51 % | 20 % | 0,092 | 1 344 ms |
Pourquoi 1,3 seconde alors que la fiche annonce 280 ms ?#
Parce que la fiche mesure une décision et qu’une requête du routeur, ce sont quatre questions. VegaML fait une passe dans la base par question, et le cache de préfixe ne démarre qu’à 4 096 tokens, bien au-dessus de mes prompts. Quatre passes à environ 330 ms chacune sur le GPU du M4 donnent les 1,3 s que j’ai mesurées. Avec des têtes ajustées, les têtes remplacent le moteur pour leurs questions, d’où les 0,86 s.
Les 74–85 ms p50 de l’auteur sont mesurées sur un GPU T4 en fp16, encore une autre histoire de matériel. Comme pour Clef-flash, chaque chiffre est vrai sur sa propre machine.
La question habituelle : sur quoi a-t-il été entraîné ?#
Je n’inclus que les modèles qui disent ne pas avoir été entraînés sur les sorties de Jev, puisque les conditions de TypeSafe interdisent la distillation de Jev. VegaML est un cas limite, comme Clef-flash. Les adaptateurs sont documentés : entraînés sur la partie train de LocalLLaMA/typed-decisions, dont la fiche dit qu’il n’est pas affilié à TypeSafe et ne reproduit pas Jev. Les données d’entraînement du moteur de base ne sont pas décrites, seulement son objectif. Jev apparaît dans le dépôt comme référence appelée en direct, rien de plus. J’ai inclus le modèle et signalé la question dans la documentation du benchmark, de la même façon que pour Clef-flash.
Où est-ce qu’il a sa place ?#
- Comme routeur prêt à l’emploi, en zero-shot : non. 51 % sur le sujet et 1 % de réponses confiantes, ça veut dire que le routeur surdimensionne presque tout, et les signaux de sécurité n’ajoutent rien que le seuil de confiance ne dise déjà.
- Comme « amorce » pour mes propres étiquettes : intéressant. system-one-router enregistre déjà les résultats pour
cmd/refit. En donner quelques dizaines àfit()chaque nuit, avec des têtes écartées automatiquement quand elles ne battent pas le hasard, c’est une boucle peu coûteuse qu’aucun autre modèle ici ne propose. - Pour les tâches pour lesquelles il a été conçu : probablement oui. Du filtrage binaire (est-ce une injection de prompt ? est-ce du phishing ?) avec abstention, en local, sur de longs documents. Ce n’est pas la question de mon routeur, mais ça pourrait être une des questions de ma maison.
- Laya : rien de nouveau pour le routage. La prochaine étape reste un fine-tuning, cette fois avec la CLI officielle
laya-trainau lieu de mes propres scripts.
Ce que j’en retiens#
- Vérifiez les poids avant de relancer un benchmark. Huit versions de Laya, zéro poids modifié, zéro réponse modifiée. Une comparaison de hashes m’aurait dit la même chose en une seconde.
- La grille de prix bouge même quand le modèle ne bouge pas. Un changement de prix de DeepSeek a déplacé jusqu’à 19 routes par colonne. Les benchmarks d’un routeur ne sont comparables qu’à prix égaux.
- Les victoires d’un éditeur décrivent les tâches de l’éditeur. Phishing oui/non et un choix de sujet entre 10 options sont tous les deux des « décisions », mais ils n’ont pas la même difficulté.
- Les signaux d’incertitude ne sont utiles que s’ils apportent de l’information.
abstain,unboundet les ensembles conformes sont bien conçus, mais sur mes questions, ils répètent le score de confiance. - Le few-shot est un vrai entre-deux. 40 étiquettes, une minute, mesuré sur des prompts mis de côté : pas assez pour router, mais le meilleur rapport effort/résultat de tout ce que j’ai essayé jusqu’ici.
- « Par décision » n’est pas « par requête ». Quatre questions, ce sont quatre passes pour VegaML. Lisez les chiffres de latence en gardant en tête le nombre de questions.
Le code et le compte rendu complet sont dans mmornati/system-one-router#12, avec les instructions d’installation dans docs/benchmark.md. Le rapport publié montre encore le passage à sept fournisseurs ; Clef-flash et VegaML le rejoindront au prochain passage complet, quand tous les serveurs locaux tourneront en même temps. Si vous avez essayé le fit() de VegaML sur vos propres données, ou le 4B sur une machine plus grosse, j’aimerais beaucoup en entendre parler en commentaire.
Comment c’est fait#
Même méthode que le reste de la série : une session Claude Code avec Opus 5.5. Je lui ai demandé de lire le changelog de Laya, de me dire si un nouveau benchmark valait la peine, et de juger si VegaML était « au même niveau » et pouvait passer dans le benchmark, avec un plan et sans code. L’agent a comparé les hashes des poids, lu le README et le code de VegaML, et proposé six étapes : sidecar, fournisseur de benchmark, passage zero-shot, température, têtes few-shot, documentation. J’ai dit « fais tous les points ». Il a écrit le sidecar, lancé la vérification de Laya et les trois passages de VegaML, trouvé le piège des clés triées dans le fichier d’ajustement, et ouvert la pull request. Pour cet article, une deuxième session a lu cette transcription, cherché en ligne ce que VegaML a publié, et rédigé le texte. Ma part : choisir quoi mesurer et quoi garder.