Depuis un mois, mon Home Assistant pose à Jev les questions auxquelles mes règles YAML répondent mal : faut-il booster la ventilation maintenant ? Faut-il baisser ces volets ? Ce débit d’eau est-il normal ? J’ai décrit l’installation dans le premier article, puis l’historique et la boucle de retour dans le deuxième. Jev, c’est le modèle « System One » hébergé de TypeSafe : vous lui envoyez un state JSON et des questions typées, il vous renvoie des probabilités calibrées, pour une fraction de centime par jour.
Laya, de Convai Innovations, c’est l’alternative open weights que je suis depuis le benchmark du routeur, en passant par un fine-tuning sur mes étiquettes et la vérification de la 0.4.2. Il parle la même API que Jev. Et il a un argument qu’aucun benchmark ne mesure : s’il tourne à la maison, aucune donnée de ma maison ne part nulle part. L’humidité de mes salles de bain, les moments où les volets bougent, la présence de quelqu’un à la maison : c’est exactement le genre de données que je préfère garder sur mon propre réseau.
Dans le deuxième article, j’expliquais pourquoi je n’étais pas passé en local sur mon mini PC N100. Cette fois, j’ai arrêté d’argumenter et je l’ai installé. Cet article couvre :
- faire tourner Laya dans Docker sur un N100 et le brancher sur Home Assistant ;
- ce qui s’est passé quand j’ai rejoué à travers lui deux semaines de vraies requêtes Jev ;
- fine-tuner Laya sur ma propre maison : des données Home Assistant, étiquetées avec le recul par Claude Opus et vérifiées par moi, avec Jev comme point de comparaison plutôt que comme professeur ;
- si ça en valait la peine.
Laya dans un conteneur sur un N100#
Le matériel, c’est un petit boîtier Intel N100 : 4 cœurs, 16 Go de RAM, pas de GPU, et déjà occupé par d’autres conteneurs. Je le gère avec Coolify, mais n’importe quel hôte Docker fait l’affaire. Laya fournit son propre serveur, laya-serve, qui expose POST /v1/systemone avec la même forme de requête et de réponse que Jev.
Ma première version installait tout au démarrage du conteneur :
services:
  laya-api:
    image: python:3.13-slim
    restart: unless-stopped
    command: >
      sh -c "pip install --no-cache-dir torch --index-url https://download.pytorch.org/whl/cpu &&
             pip install --no-cache-dir 'laya[serve]' &&
             laya-serve"
    environment:
      - LAYA_HOST=0.0.0.0
      - LAYA_PORT=8000
      - LAYA_SERVER_PRELOAD=multilingual
      - OMP_NUM_THREADS=4
      - PYTHONUNBUFFERED=1
    volumes:
      - laya_model_cache:/root/.cache/huggingface
    ports:
      - "8180:8000"
    healthcheck:
      test: ["CMD", "python3", "-c", "import urllib.request; urllib.request.urlopen('http://localhost:8000/health')"]
      interval: 30s
      start_period: 120s

volumes:
  laya_model_cache:
Ça marche, et c’est une bonne façon d’essayer Laya en cinq minutes. Quelques remarques si vous la gardez :
- Utilisez le wheel PyTorch CPU uniquement. Celui par défaut tire des bibliothèques CUDA inutilisables sur un N100 et pèse plusieurs gigaoctets de plus.
- Gardez le cache Hugging Face dans un volume, sinon chaque redémarrage retélécharge le checkpoint.
OMP_NUM_THREADS=4correspond aux quatre cœurs du N100. Ajouter des workers ou des réplicas n’aide pas : chaque requête utilise déjà les quatre cœurs.- Figez vos versions. Ce
command:réinstalle unlaya[serve]non figé à chaque redémarrage : un redémarrage peut donc ramener en silence une nouvelle version qui répond différemment, après plusieurs minutes d’installation. Une fois que vous savez que vous voulez le garder, intégrez-le dans une image :
FROM python:3.13-slim
RUN pip install --no-cache-dir torch==2.14.1 --index-url https://download.pytorch.org/whl/cpu \
 && pip install --no-cache-dir "laya[serve]==0.4.15"
ENV LAYA_HOST=0.0.0.0 LAYA_PORT=8000 OMP_NUM_THREADS=4 PYTHONUNBUFFERED=1
CMD ["laya-serve"]
Je précharge le checkpoint multilingue : il lit 1 024 tokens, contre 512 pour l’anglais, et mes requêtes sont longues.
Le brancher sur Home Assistant#
L’intégration HA-Jev que j’utilise accepte déjà une adresse personnalisée. Basculer est donc un changement de configuration, pas de code : une deuxième entrée avec l’URL http://<your-laya-host>:8180, le modèle multilingual, et pas de clé d’API (l’intégration prévient que c’est du HTTP en clair, ce qui est acceptable sur un réseau local). Les scripts qui interrogent Jev prennent un config_entry, chaque décision peut donc être pointée vers l’un ou l’autre.
C’était la partie facile. La suite a été moins drôle.
Premiers résultats : ça marche, lentement, et les réponses sont fausses#
Laya coupe votre requête, et Home Assistant ne le voit pas#
Mon premier test était une vraie requête VMC (ventilation), celle où Jev décide s’il faut lancer la bruyante vitesse 2. Laya a répondu 0,9954, « booster », là où Jev avait dit 0,49. Laya avait l’air décidé. Puis j’ai lu le reste de la réponse :
"usage": {"input_tokens": 1024, "state_tokens": 960,
          "state_tokens_dropped": 196, "truncated": true}
Le checkpoint multilingue lit 1 024 tokens au total, dont 256 sont réservés à la question et à ses options. Mon state VMC fait environ 1 150 tokens, parce que le deuxième article a donné une mémoire à Jev : trois heures d’humidité par pièce, les événements récents, chaque pièce comparée à sa propre médiane quotidienne. Laya laisse tout simplement tomber la fin.
Deux expériences ont montré exactement ce qui se perd. J’ai placé un fait décisif (« porte du garage ouverte/fermée ») après 1 500 tokens de remplissage : les deux versions ont renvoyé exactement 0,7307, Laya ne l’a donc jamais vu. Puis, sur la vraie requête, passer away et sleeping à on, ou changer les seuils à la fin du contexte de la question, renvoyait exactement 0,9954 à chaque fois. Laya coupe la fin du state, c’est-à-dire là où se trouvaient mes away, sleeping, les données extérieures et les avertissements sur les capteurs peu fiables. Il plafonne aussi la question à 256 tokens et coupe la fin d’un contexte trop long sans le signaler.
Et l’intégration ne vous le dit jamais : le client lit les réponses et le nombre de tokens, pas le drapeau truncated. Dans Home Assistant, une réponse tronquée ressemble à n’importe quelle autre.
Raccourcir les requêtes : seulement si les réponses de Jev ne changent pas#
La solution évidente, c’est une requête plus courte. Une version compacte du state VMC, avec les faits décisifs en premier et un bloc par pièce, est passée de 1 221 à 471 tokens. Mais j’avais ajouté toutes ces données parce que Jev en avait besoin pour bien décider, alors je me suis fixé une règle : un raccourcissement n’entre que si les réponses de Jev ne bougent pas plus que le bruit de Jev lui-même.
Claude Code a d’abord mesuré ce bruit : la même vraie requête envoyée deux fois à Jev bouge de 0,013 en moyenne pour la VMC et de 0,007 pour les volets. Puis il a retiré un champ à la fois sur 50 situations réelles, et enfin testé les règles combinées sur 200 autres (environ 1 400 appels à Jev, 0,10 $) :
| Changement VMC | Gain | Écart moyen / max de la réponse de Jev | Verdict |
|---|---|---|---|
| Retirer les entrées vides | 126 o | 0,013 / 0,05 | bruit |
| Liste courte des capteurs peu fiables | 76 o | 0,009 / 0,03 | bruit |
| Retirer les lignes de pompe des événements | 154 o | 0,039 / 0,14 | Jev s’en sert |
| Retirer l’humidité absolue et le gain de ventilation | 104 o | 0,041 / 0,18 | utilisé |
| Retirer la série sur 3 heures | 741 o | 0,058 / 0,26 | utilisé |
| Retirer le texte de contexte | 1 079 o | 0,096 / 0,42 | utilisé |
Même ensemble, les règles « sûres » faisaient bouger les réponses VMC deux fois plus que le bruit et inversaient quatre décisions sur 120. Seuls les volets ont passé le test : garder les valeurs des séries sans les résumés min/max économise 15 % des tokens sans aucun changement, et c’est entré dans ma configuration. La requête VMC reste telle quelle. Elle ne rentre pas dans Laya, et la faire rentrer rendrait Jev moins bon.
Est-ce assez rapide ?#
Pour dimensionner, j’ai compté deux semaines de vrais appels à Jev : 1 416 appels, 101 par jour, 4,2 par heure en moyenne. La minute la plus chargée en a compté 4, à :00 et :30, quand les questions programmées tombent en même temps. Sur le N100, sans rien d’autre qui interroge :
| Requête | Temps |
|---|---|
| Requête VMC complète (1 024 tokens, tronquée) | 4,9 s (7,8 s pour le premier appel) |
| Requête VMC compacte (325 tokens) | 1,0 s |
| 4 requêtes en même temps | 5,3 / 10,2 / 15,1 / 19,9 s |
laya-serve traite une requête à la fois, une rafale fait donc la queue. Avec 4 en même temps, la dernière réponse prend 20 secondes, dans le timeout de 30 secondes de l’intégration, mais sans beaucoup de marge. Le coût grandit plus vite que la longueur : une requête plus courte est donc la vraie accélération, plus que n’importe quel réglage du CPU. Sur une journée, cela dit, ça représente environ 8 minutes de travail CPU. Pour une maison, lent, ça va. J’attendrais volontiers 5 secondes une décision de ventilation si ça veut dire que mes données restent à la maison.
Le vrai test : deux semaines de vraies requêtes#
Jusque-là, je n’avais qu’une seule vraie requête. Mais la journalisation des prompts était activée sur mon compte OpenRouter, toutes les vraies requêtes étaient donc là. Claude Code les a lues dans le navigateur, après que je me suis connecté moi-même : 1 416 requêtes du 11 au 25 octobre, chacune avec le JSON exact envoyé par Home Assistant et la réponse de Jev. Ces journaux montrent quand les gens sont à la maison : ils sont donc restés sur mon portable, hors de tout dépôt.
Chaque requête est partie vers Laya sans modification. Après 396 d’entre elles, le tableau était clair :
| Question | Laya de base | Jev |
|---|---|---|
| Boost de la VMC | tronquée à chaque fois ; « oui » à 0,994–0,999 à chaque fois | « oui » 18 % du temps |
| Volets | « les baisser » 99 % du temps | une fois |
| Arrosage du jardin | « oui » 100 % du temps | jamais |
| Quelle lumière allumer | même choix que Jev 27 % du temps |
La troncature n’est pas le problème principal. Avec le state complet visible sur un exemple fait à la main, une douche en cours (90,8 %, +16 points en 15 minutes), une douche il y a une heure, une humidité plate et « tout le monde dort » obtenaient tous entre 0,980 et 0,992. Je lui ai donné les faits sous forme de nombres, de mots (« rising fast, fresh steam ») et d’un simple drapeau fresh_steam: true : rien de tout ça n’a fait bouger la réponse dans le bon sens. Sur la VMC, son classement des situations était à peine meilleur que le hasard (AUC de 0,60 par rapport aux décisions de Jev).
Ça correspond à la documentation de Laya lui-même : c’est un encodeur de 322M de paramètres (mmBERT-base) pré-entraîné sur des tâches de décision génériques, ses réponses oui/non peuvent suivre la formulation des options plutôt que le state, et les auteurs disent de le traiter comme une base à spécialiser. Une température ou un seuil ne peuvent rien y faire : ils remettent les scores à l’échelle, mais gardent leur ordre, et ici, c’est l’ordre qui est faux.
Dans sa forme de base, Laya ne peut donc pas remplacer Jev dans ma maison. Il faut l’entraîner. La vraie question, c’est : l’entraîner sur quoi ?
Apprendre ma maison à Laya#
Le raccourci que je n’ai pas gardé#
La cible évidente était sous mes yeux : 1 416 requêtes, chacune avec la réponse de Jev. Entraîner Laya à reproduire ces réponses, c’est de la distillation, et le contrat client de TypeSafe (§2.3(b)) l’exclut : on ne peut pas utiliser le service ou ses sorties « to perform model distillation » ni pour « train a model to imitate the output of the Services » (autrement dit, ni pour faire de la distillation de modèle, ni pour entraîner un modèle à imiter les sorties du service). Il n’y a aucune exception pour un usage personnel.
Pour être transparent : je l’ai essayé une fois, en local, comme premier test, pour voir si Laya pouvait seulement apprendre ma maison. Il le pouvait. Après une heure sur mon MacBook, ses décisions VMC sont passées de 14 % à 93 % d’accord avec Jev sur des jours qu’il n’avait jamais vus. Mais ce modèle était une copie de Jev : je ne pouvais pas le faire tourner la conscience tranquille, et il ne pourrait jamais être meilleur que Jev. J’ai donc supprimé le checkpoint et les données d’entraînement étiquetées par Jev, et je suis reparti avec des étiquettes qui ne viennent pas de Jev. C’est de ce deuxième modèle que parle cet article.
Je ne suis pas le seul à être curieux. Sur GitHub, Mini-Jev distille Jev dans un petit modèle Qwen et invite lui-même ses lecteurs à vérifier les conditions de TypeSafe. D’autres, comme Kev ou system-one-open, s’entraînent plutôt sur des datasets publics ou sur leurs propres étiquettes synthétiques, et c’est la voie propre.
Des étiquettes venues de Home Assistant, jugées avec le recul#
Home Assistant sait déjà ce qui s’est passé après chaque décision : si l’humidité de la salle de bain a continué de grimper après un « pas de boost », si le salon a atteint 28 °C l’après-midi où les volets sont restés levés. Un juge qui voit à la fois le moment de la décision et les heures qui suivent peut dire quelle était la bonne décision, sans demander à Jev.
Toutes les entrées viennent de mon Home Assistant :
- Octobre : 1 411 vraies décisions. Les states exacts envoyés par Home Assistant entre le 11 et le 25 octobre : VMC, volets et les questions plus rares. Pour chacun, le recorder ajoute ce qui s’est passé ensuite : les relevés bruts des capteurs pour l’heure suivante depuis la mi-octobre, les statistiques horaires avant.
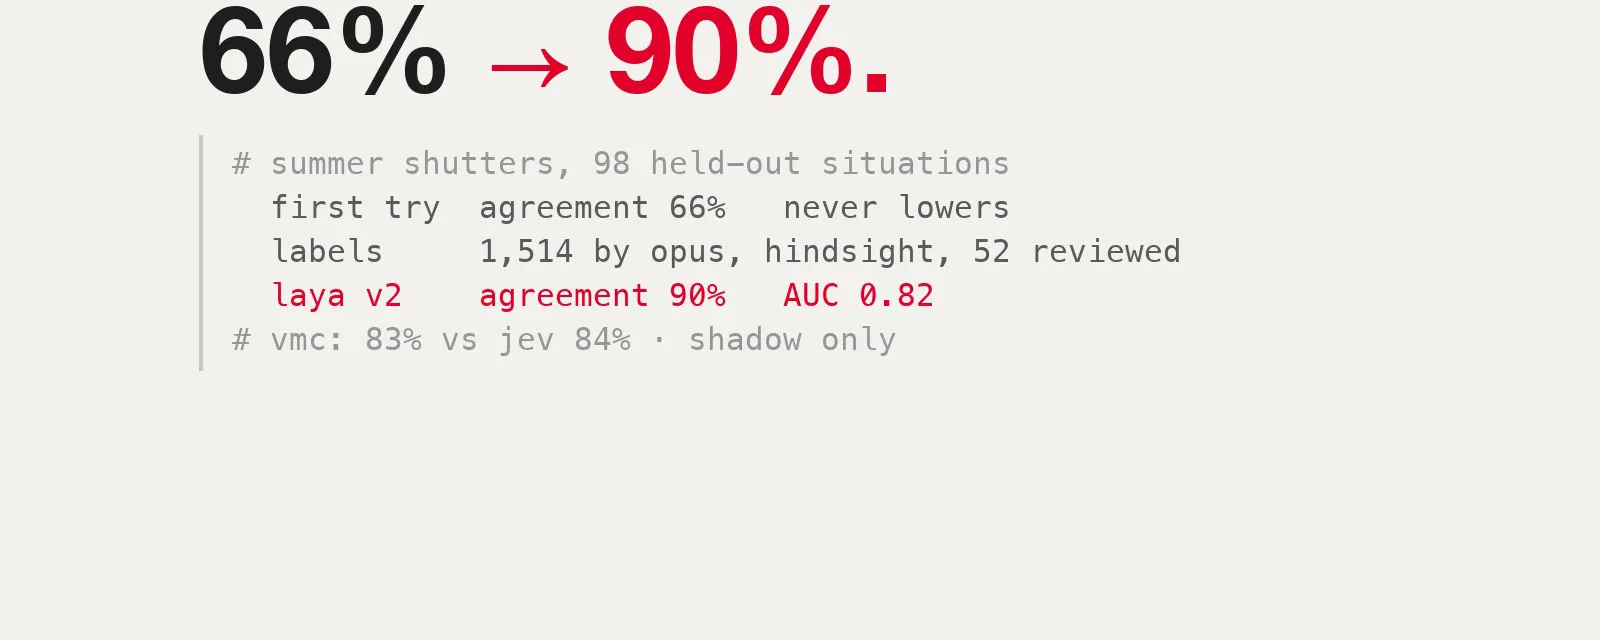
- Été : 608 situations de volets. Mon automatisation des volets n’a commencé à interroger Jev qu’à l’automne, quand la réponse est toujours « les laisser levés » : il n’y avait donc rien à apprendre sur le fait de les baisser. Mais Home Assistant garde des statistiques horaires à long terme (moyenne, min, max) pendant des années. À partir de là, Claude Code a reconstruit la décision des volets pour chaque zone et chaque heure de mai à septembre : température intérieure et extérieure, capteurs de façade au soleil, les quatre dernières heures, la position du soleil. Il en a ensuite tiré 608, réparties entre journées chaudes, tièdes et fraîches, avec la température atteinte par chaque pièce plus tard dans la journée.
Le juge, c’est Claude Opus, via des sous-agents Claude Code qui travaillent à partir d’une grille écrite. Booster quand une pièce humide montre de la vapeur fraîche (environ +5 points en 15–30 minutes) et que le recul montre que c’est réel, pas un raté de capteur. Baisser les volets si la pièce va atteindre environ 26 °C plus tard dans la journée et que le soleil est sur cette façade. Pour tout le reste, le bon sens et le contexte de la question elle-même. Chaque étiquette est une probabilité, pas un oui/non (0,95 pour « booster, clairement », 0,6 pour « plutôt oui »), avec une raison en une ligne comme “parents’ bathroom +11 to 82.8, fresh shower steam”. Soit 2 019 étiquettes au total.
Ensuite, j’ai vérifié le juge. Claude Code a rassemblé les 52 cas les plus discutables et je les ai revus un par un moi-même. Une précision : pour trouver vite les cas difficiles, il les a choisis là où Opus et Jev n’étaient pas d’accord. J’ai été d’accord avec Opus sur les 52, aucune étiquette n’a donc changé. Les réponses de Jev n’ont jamais servi d’étiquettes ; elles sont gardées uniquement pour comparer.
Jev n’est pas la vérité#
C’est finalement la partie la plus intéressante. Sur les 831 requêtes VMC d’octobre, Jev et les étiquettes avec recul sont d’accord sur 743, environ 89 %. Les désaccords ne sont pas aléatoires :
- 53 fois, le juge aurait boosté et Jev ne l’a pas fait. Presque toujours le début d’une douche : “upstairs bathroom +12 to 81.5, fresh shower steam”. Jev l’avait en général vu aussi, mais donnait 0,45–0,59, juste sous mon seuil de 0,6.
- 35 fois, Jev a boosté et le juge ne l’aurait pas fait. Dans 31 cas, le boost tournait déjà : la cuisine ou la salle de bain était revenue à son niveau habituel, et Jev gardait la bruyante vitesse 2.
- Le chauffe-eau de nuit : quelques fois, Jev a dit « chauffer cette nuit » là où le juge penchait pour non, par exemple avec une seule personne à la maison.
Une partie de tout ça vient de mes seuils autant que de Jev. Mais le message est clair : Jev est un bon point de comparaison, pas la vérité, et un modèle entraîné à le copier hérite de ses ratés.
Ce qu’est vraiment Laya, et ce que l’entraînement change#
Laya n’est pas un modèle de chat et n’écrit jamais de texte. Pour chaque question, il construit une seule séquence :
[CLS] <question type> instructions [SEP] [MASK] option 1 option 2 ... [SEP] state JSON [SEP]Un encodeur lit le tout d’un coup, et une petite tête au-dessus le transforme en probabilités sur les options : noul: 0.12, ou une probabilité par choix. Une seule passe avant, aucune étape de raisonnement, c’est pour ça qu’un modèle de 322M répond en environ une seconde sur le CPU d’un mini PC.
Le fine-tuning change les poids, pas le programme. Pour chaque exemple d’entraînement, Laya fait une prédiction, on la compare à la cible, et tous les poids bougent un peu dans sa direction. Faites ça quelques centaines de fois avec un petit learning rate, et le modèle s’adapte à vos questions sans oublier le reste. Avec des probabilités comme cibles, il apprend aussi le doute : un 0,6 enseigne « plutôt oui », pas « oui ».
Laya fournit son propre code d’entraînement, laya.train, ce qui valait mieux que de faire de la rétro-ingénierie sur le notebook Kaggle cité dans la model card.
L’entraînement#
Chaque ligne d’entraînement est un state plus la probabilité du juge :
{"state": {...},
 "questions": {"answer": {"type": "noul", "instructions": {...}, "criteria": {...}}},
 "gold": {"answer": {"probabilities": {"false": 0.05, "true": 0.95}}}}
Les choix importants ont été :
- Découper dans le temps, pas au hasard. Entraînement sur le 11–21 octobre et sur les journées d’été, sauf le 16–31 août. Test sur le 22–25 octobre (402 requêtes) et sur le 16–31 août (98 situations de volets). Un découpage aléatoire mettrait des requêtes VMC consécutives presque identiques des deux côtés, et le score aurait l’air bien meilleur qu’il ne l’est.
- Ne jamais rien couper. Le modèle n’a besoin de fonctionner que pour Laya, il reçoit donc un state compact : les faits décisifs en premier et un contexte VMC court. Chaque ligne a été vérifiée avec le
build_sequencede Laya lui-même : si un seul token du state devait sauter, une règle de repli raccourcit les séries, puis retire les événements les plus anciens un par un. Résultat final : chaque entrée tient dans 1 024 tokens avec 0 token perdu. - Les probabilités comme cibles souples, converties au format de Laya pour chaque type de question (
noul,choice).
Le script d’entraînement est court, parce que laya.train fait le travail :
from laya.train import TrainConfig, finetune

cfg = TrainConfig(
    epochs=6,
    micro_batch=2, grad_accum=8,   # effective batch of 16
    encoder_lr=2.5e-5,
    loss="soft-ce",                # match the label's probability, not just yes/no
    gradient_checkpointing=True,   # 1,024-token inputs in 16 GB
    seed=0,
)
finetune(data="train.jsonl", model_dir="laya/multilingual",
         output_dir="ckpt/house-v2", config=cfg, device="mps")
Trois réglages qui méritent une explication :
- 6 epochs, batch effectif de 16 : 516 mises à jour de l’optimiseur sur 1 363 lignes, avec 151 autres mises de côté pour la calibration. Les valeurs par défaut en auraient donné beaucoup moins, et le code de Laya lui-même prévient que trop peu de mises à jour peuvent faire s’effondrer le modèle vers une réponse constante, exactement le problème que j’essayais de corriger.
- La loss
soft-ceau lieu derlcd, celle par défaut : la cross-entropy souple est l’objectif naturel quand la cible est une probabilité, et les notes de Laya elles-mêmes disent que le terme RL n’apportait aucun gain ici. - Le gradient checkpointing : sans lui, des séquences de 1 024 tokens ne tiennent pas dans les 16 Go de mémoire du M4. Il n’est pas exposé par la CLI, c’est pour ça que j’ai appelé
finetune()depuis Python.
L’entraînement part des poids de base de Laya, pas de la copie de Jev supprimée. Il a pris 1 h 48 sur le GPU du M4 (MPS), rien n’a quitté le portable, et la loss est passée de 0,45 à 0,27. Elle ne peut pas atteindre zéro quand la cible elle-même est 0,6 ; ce sont les jours mis de côté qui disent si ça a marché.
Les résultats sur des jours qu’il n’a jamais vus#
Chaque réponse est transformée en décision au seuil que mon automatisation utilise vraiment, puis comparée aux étiquettes avec recul revues :
| Mis de côté | Jev | Laya, premier test (entraîné sur Jev, supprimé) | Laya v2 (étiquettes avec recul) |
|---|---|---|---|
| VMC 22–25 oct. : même décision que les étiquettes (244) | 84 % | 79 % | 83 % |
| VMC : classement des situations (AUC) | 0,95 | 0,85 | 0,93 |
| VMC : boosts ratés (sur 53) | 29 | 43 | 37 |
| VMC : boosts inutiles | 10 | 8 | 4 |
| Volets 22–25 oct. (145, aucun nécessaire) | 100 % | 100 % | 100 % |
| Volets d’été 16–31 août (98, 33 à baisser) | jamais interrogé | 66 % | 90 % |
| Volets d’été : baisses ratées / inutiles | 33 / 0 | 9 / 1 | |
| Questions rares, 22–25 oct. (13) | 85 % | 85 % | 77 % |
Pour référence, Laya de base obtient 22 % sur la VMC et 34 % sur les volets d’été : il dit oui à tout.
Ce que j’en lis :
- Les volets d’été sont le vrai gain. Jev n’a jamais été interrogé sur la baisse des volets en été, et le premier test, entraîné sur des réponses d’automne, n’avait appris que « les laisser levés ». Entraîné sur cinq mois de statistiques, v2 les baisse dans 24 des 33 situations où il le faut, et une seule fois quand il ne le faut pas. C’est une décision pour laquelle ma maison n’avait aucune donnée jusque-là.
- Sur la VMC, v2 fait jeu égal avec Jev ; il ne le bat pas. 83 % contre 84 %, et plus prudent : moins de boosts inutiles (4 contre 10), plus de ratés (37 contre 29). La plupart des ratés sont limites. Pour un ventilateur bruyant, je préfère ce côté-là, mais ce n’est pas « meilleur que Jev ».
- Il est noté par le juge dont il a appris. v2 a appris des étiquettes d’Opus et il est évalué sur des étiquettes d’Opus ; Jev, non. Ça avantage v2. Ma revue des 52 cas disputés est la seule vérification indépendante. La lecture honnête, c’est « comparable à Jev sur la VMC, plus les volets d’été », pas « bat Jev ».
- Le state des volets vient de statistiques horaires, une vue plus grossière qu’une requête en direct. Avant qu’il décide quoi que ce soit, Home Assistant doit envoyer ce même format. C’est un chantier pour le printemps prochain.
- Il a appris ma maison, pas le raisonnement. Posez-lui une nouvelle question demain, et vous retrouvez le modèle de base. Et les 13 questions rares sont trop peu nombreuses pour juger.
Servir le checkpoint#
La bonne nouvelle : c’est le même programme et la même image. laya-serve charge des checkpoints supplémentaires depuis la variable LAYA_EXTRA_MODELS, un dossier local ou un dépôt Hugging Face. Le dossier du checkpoint fait environ 650 Mo (model.safetensors, rl_agent_config.json, questions.json, encoder/, tokenizer/ ; l’état de l’optimiseur n’est pas nécessaire).
Je ne toucherais pas au conteneur en service pour un essai. Un deuxième service à côté suffit :
services:
  laya-shadow:
    build: .                      # the Dockerfile above
    restart: unless-stopped
    environment:
      LAYA_EXTRA_MODELS: '{"house-v2": "/models/house-v2"}'
      LAYA_MODELS: house-v2
      LAYA_DEFAULT_MODEL: house-v2
      OMP_NUM_THREADS: "4"
    volumes:
      - ./house-v2:/models/house-v2:ro
    ports:
      - "8181:8000"
Avec LAYA_DEFAULT_MODEL, Home Assistant n’a même pas besoin de nommer le modèle ; sinon, il envoie "model": "house-v2". Un dépôt Hugging Face privé avec un HF_TOKEN marche aussi, mais un dossier local est plus simple et garde les poids sur votre réseau. Attention à la RAM : le modèle lui-même a besoin d’environ 1,3 Go, et docker stats montre mon conteneur Laya actuel à environ 5 Go, cache de pages compris, sur une machine de 16 Go qui fait aussi tourner d’autres choses. La vitesse ne change pas, puisque le modèle a la même taille : environ 1 seconde pour une requête courte, 5 pour une longue.
Il reste un vrai changement côté Home Assistant, et il n’est pas optionnel : il doit envoyer les states sur lesquels le modèle a été entraîné, le state VMC compact et le state des volets basé sur les statistiques. La requête Jev complète serait de nouveau coupée à 1 024 tokens, et le modèle verrait quelque chose sur quoi il n’a jamais été entraîné.
Est-ce que ça en valait la peine ?#
Comme expérience, oui, clairement. Ce que j’en retiens :
- L’installation est la partie facile. Une API compatible Jev, ça veut dire un conteneur Docker et une URL dans Home Assistant. C’est vraiment agréable.
- Vérifiez
truncatedavant toute chose. Un modèle qui coupe en silence la fin de votre requête aura l’air sûr de lui et se trompera, et Home Assistant ne vous le dira pas. - Un N100 suffit pour une maison, à environ 100 décisions par jour. La lenteur n’est pas un problème ici ; les rafales, si, et des requêtes plus courtes les règlent mieux que du matériel.
- Laya de base n’est pas un moteur de décision pour des states de maison numériques, et ses auteurs le disent. Fine-tuné, il devient étonnamment bon sur mes questions, après moins de deux heures d’entraînement sur un portable.
- Copier Jev n’était de toute façon pas la bonne cible. Conditions mises à part, une copie hérite des ratés de Jev et n’apprend rien là où Jev n’a jamais été interrogé. Les étiquettes avec recul m’ont donné les volets d’été, ce qu’aucune quantité de données Jev n’aurait pu faire.
- Un LLM avec du recul est un bon étiqueteur, à condition de le vérifier. Le recorder a les faits ; le juge les transforme en 2 019 étiquettes calibrées ; une personne doit quand même regarder les cas difficiles.
- La maison tourne toujours sur Jev. v2 est assez bon pour le mode shadow sur la VMC : Home Assistant interroge les deux, agit selon Jev, et journalise Laya à côté. Les volets suivront au printemps prochain, une fois que le template enverra le bon state.
La leçon la plus importante concerne toujours les données. Mon tableau de bord collecte mes propres réponses « qui avait raison ? », et les vérifications du résultat enregistrent ce qui s’est vraiment passé après chaque décision. Ces étiquettes sont les miennes, elles n’ont besoin d’aucun juge, et ce sont les meilleures cibles qui soient. Le juge avec recul est une façon de commencer avant d’en avoir un millier ; le prochain entraînement mélangera les deux.
Si vous faites tourner Laya, ou n’importe quel modèle compatible Jev, à la maison, j’aimerais vraiment savoir comment vous gérez la fenêtre de contexte et sur quoi vous l’entraînez. Les commentaires sont ouverts.
Comment il a été construit#
Plusieurs sessions Claude Code avec Opus 5.5. La première est partie de mon « remplaçons Jev par Laya », a compris comment l’intégration parle à Jev, a trouvé la troncature, a mesuré le N100, a lu mes journaux de prompts OpenRouter dans le navigateur (je me suis connecté moi-même), les a rejoués à travers Laya, et a testé chaque raccourcissement par rapport au bruit de Jev avant de modifier le moindre template. Une deuxième a construit le premier dataset, lancé le test entraîné sur Jev sur mon MacBook et vérifié comment servir un checkpoint. Après ma relecture d’un premier brouillon de cet article, une troisième a reconstruit cinq mois de décisions à partir d’une copie en lecture seule du recorder de Home Assistant, a fait étiqueter 2 019 d’entre elles par des sous-agents Opus à partir d’une grille écrite, a préparé les 52 cas disputés pour ma revue, a entraîné et évalué v2, a supprimé le test entraîné sur Jev, et a réécrit cet article. Mon rôle a été de décider quoi tester, d’insister pour que les réponses de Jev ne changent pas, de revoir les cas difficiles du juge, et de décider quoi garder et quoi publier.