Il y a dix jours, dans l’article sur system-one-router, j’ai benchmarké deux modèles de décision « System One » : Jev, le modèle hébergé de TypeSafe, et Laya, l’alternative open weights de Convai Innovations. Le verdict était net. Jev était utilisable tel quel (89 % de sujets corrects, bien calibré), Laya en zero-shot ne l’était pas (59 %, et tellement peu sûr de lui que le routeur surdimensionnait presque chaque requête). Je concluais par « si Laya est fine-tuné avant que je m’y mette, j’aimerais vraiment en entendre parler ».
Personne n’a écrit, alors je m’y suis mis. Dix jours, c’est long dans ce coin du monde de l’IA : Laya a publié 18 versions, une poignée de nouveaux modèles façon Jev sont apparus, et le README de Laya le dit désormais sans détour : traitez Laya comme une base rapide à spécialiser, pas comme un moteur de décision zero-shot. Cet article fait donc trois choses :
- relancer le benchmark avec le nouveau Laya et trois nouveaux modèles ouverts ;
- fine-tuner Laya sur mes propres étiquettes, sur mon MacBook M4, avec les vraies commandes, les sorties et les temps ;
- revenir à ma maison, où Jev juge désormais mes automatisations Home Assistant, et rejouer 80 vraies décisions à travers Laya pour vérifier ce que j’avais dit sur son exécution en local.
Comme la dernière fois, la machine de test est un Apple M4 avec 16 Go de RAM.
Laya 0.3.6 → 0.3.24 : du nouveau code, le même modèle#
Entre le premier benchmark (23 septembre) et aujourd’hui, Laya a enchaîné 18 versions : autocast MPS, réutilisation du tokenizer, regroupement par longueur, corrections du routage par langue, outillage pour la température, un SDK TypeScript… Tout ça, c’est du code d’exécution. Les poids et les fichiers de calibration sur Hugging Face sont identiques à l’octet près à ce que j’avais testé la première fois. Je m’attendais donc à des chiffres identiques, et c’est ce que j’ai obtenu :
| 0.3.6 | 0.3.24 | |
|---|---|---|
| Laya anglais, sujet correct | 59 % | 59 % |
| Laya multilingue, sujet correct | 45 % | 45 % |
| Laya auto, sujet correct | 58 % | 56 % (un prompt) |
| Erreur de calibration, latence | — | à 0,003 et 10 ms près |
La mise à jour est sans risque, et elle ne change rien pour le routage. Jev, remesuré le même jour, a à peine bougé lui aussi : 89 % de sujets corrects, 72 % de routes identiques à la référence, 268 ms de latence médiane.
Les nouveaux venus#
Quand j’ai écrit le premier article, Laya était « l’alternative » ouverte. Ce n’est plus le cas. J’ai retenu ceux qui sont sous Apache-2.0, tournent sur un Mac de 16 Go et affirment ne pas avoir été entraînés sur les sorties de Jev. Ce dernier point compte : le contrat client de TypeSafe interdit d’utiliser les sorties de Jev « to perform model distillation » ou pour entraîner un modèle qui l’imite, et quelques modèles communautaires sont exactement ça.
- Laya typed-decisions : un troisième checkpoint qui dormait depuis le début dans le dépôt de Laya. C’est le modèle anglais fine-tuné sur le dataset typed-decisions (2 000 décisions réparties sur quatre workflows).
- Von 1.3 : un ModernBERT-large de 395M avec une tête à marqueurs d’options, 8k de contexte, anglais uniquement.
- Kev-0.8B : une LoRA plus une tête de pointage sur Qwen3.5-0.8B, servie via MLX. Le Kev-4B recommandé demande un Mac de 32 Go, je n’ai donc pas pu le tester.
Les trois parlent le même format de requête que Jev : system-one-router n’a eu besoin d’aucun adaptateur, juste d’une URL. Le benchmark de 80 prompts, mêmes prompts, même routeur, même configuration :
| Jev 1.13 | Laya anglais | Laya typed-decisions | Von 1.3 | Kev-0.8B | |
|---|---|---|---|---|---|
| Sujet correct | 89 % | 59 % | 71 % | 70 % | 81 % |
| Complexité exacte | 72 % | 45 % | 41 % | 55 % | 42 % |
| Risque exact | 61 % | 31 % | 34 % | 46 % | 49 % |
| Réponses confiantes (≥ 0,8) | 84 % (dont 94 % justes) | 12 % | 0 % | 74 % (dont 75 % justes) | 5 % |
| Erreur de calibration (plus bas = mieux) | 0,068 | 0,171 | 0,509 | 0,226 | 0,349 |
| Même route que la référence | 72 % | 20 % | 12 % | 48 % | 22 % |
| Modèle moins cher / plus cher que la référence | 3 / 19 | 3 / 61 | 0 / 70 | 15 / 27 | 4 / 58 |
| Coût modèle estimé (référence 1,18 $, toujours Opus 2,40 $) | 1,37 $ | 1,74 $ | 2,32 $ | 0,99 $ | 1,16 $ |
| Latence de décision p50 | 268 ms | 300 ms | 334 ms | 216 ms | 371 ms (MLX) |
Trois personnalités bien différentes :
- Laya typed-decisions est le meilleur Laya sur le sujet (71 %), mais il n’est jamais confiant. Pas une seule fois sur 80 prompts. Le routeur traite chaque décision comme incertaine, monte la complexité d’un cran et envoie 70 prompts sur 80 vers un modèle plus cher que nécessaire. C’est le routeur le plus coûteux du tableau, alors que chacune de ses décisions est gratuite.
- Von est celui qui route le plus près de la référence sans aucun réglage (48 %), et c’est le moins cher. Mais en partie pour de mauvaises raisons : il est trop sûr de lui, et 15 prompts finissent sur un modèle trop faible pour eux. Dans un routeur, c’est le mauvais sens pour se tromper.
- Kev-0.8B est le meilleur classifieur de sujet ouvert : 81 %, et 100 % sur les prompts multilingues, avec un modèle de 0,8B. Mais il manque cruellement de confiance, et il surdimensionne donc comme Laya.
Le rapport interactif montre les sept fournisseurs côte à côte, prompt par prompt.
Une astuce pas chère avant d’entraîner : recalibrer la confiance#
Regardez à nouveau le tableau : pour Kev et Laya typed-decisions, le problème est moins « de mauvaises réponses » que « de bonnes réponses données avec 40 % de confiance ». Et mon routeur pénalise la faible confiance, c’est voulu. Un modèle qui a raison mais qui doute coûte quand même de l’argent.
La solution classique, c’est le temperature scaling : diviser les logits par une constante T avant le softmax. Ça ne change pas l’option gagnante, seulement l’assurance avec laquelle le modèle la donne. J’ai ajouté une temperature optionnelle par fournisseur dans system-one-router, et j’ai ajusté T sur la moitié des prompts en mesurant sur l’autre moitié (20 découpages aléatoires) :
| Kev-0.8B | Laya typed-decisions | Von 1.3 | |
|---|---|---|---|
| T ajusté | 0,47 | 0,43 | 2,47 |
| Erreur de calibration, avant → après | 0,349 → 0,059 | 0,509 → 0,072 | 0,226 → 0,236 |
| Même route que la référence, avant → après | 22 % → 39 % | 12 % → 25 % | 48 % → 36 % |
Avec T = 0,47, Kev est aussi bien calibré que Jev (0,059 contre 0,068). Pour Von, ça n’aide pas : ses erreurs sont des erreurs confiantes, et aucun recalibrage ne peut distinguer une mauvaise réponse confiante d’une bonne réponse confiante. Une réserve honnête : 80 prompts, c’est peu, prenez donc ces valeurs comme un point de départ.
Mais même un Kev parfaitement calibré ne retrouve la route de référence que 39 % du temps. Le goulot d’étranglement s’est déplacé : pour tous les modèles ouverts, le sujet n’est plus le point faible ; ce sont la complexité et le risque. Et aucune température n’apprendra à un modèle ce que « complexité 2 » veut dire dans ma configuration. Pour ça, il faut de l’entraînement.
Fine-tuner Laya sur un MacBook#
Le README de Laya est très direct là-dessus : sur le benchmark typed-decisions, les checkpoints de base sont proches du hasard en zero-shot (0,36 contre une base aléatoire de 0,32), et le checkpoint fine-tuné atteint 0,766, au-dessus des 0,727 publiés pour Jev. Convai fournit deux chemins d’entraînement : un notebook Kaggle pour deux GPU T4 gratuits, et un script autonome pour Apple Silicon. La méthode s’appelle RLCD : une étape de policy gradient dont la récompense est une règle de score propre (elle récompense une probabilité à la fois juste et honnête), combinée à une simple cross-entropy, puis un ajustement de température par type de question. J’ai lu le script avant de le lancer, comme pour le paquet : des téléchargements Hugging Face, des safetensors, pas de code distant.
Première règle : entraîner sur ses propres étiquettes, pas sur celles de Jev#
Dans l’article sur le routeur, mon plan était de « fine-tuner Laya sur les décisions de Jev enregistrées ». Le mode shadow les journalisait même pour moi. J’ai abandonné ce plan : entraîner un modèle sur les réponses de Jev, c’est exactement la distillation qu’interdisent les conditions de TypeSafe. Et, à la réflexion, c’était de toute façon le mauvais objectif. Je ne veux pas une copie de Jev ; je veux un modèle qui sait ce que « complexité 2 » veut dire dans ma configuration.
Les étiquettes doivent donc être les miennes. Pour cette expérience, il me fallait plus que les 80 prompts du benchmark (qui doivent rester un jeu de test), alors j’ai fait écrire à l’agent 480 nouveaux prompts étiquetés : 48 par sujet, complexité de 0 à 3, risque de 0 à 2, 10 % avec des secrets ou des données personnelles (manifestement faux), 45 en français, italien, espagnol ou allemand, 30 longs avec des stack traces ou des diffs, quelques injections de prompt. Puis j’ai vérifié qu’ils ne recoupent pas le benchmark : la paire la plus proche partage un tiers de ses mots (« fix it » contre « deploy it »). Dans la vraie vie, la meilleure source, c’est votre propre trafic : des requêtes journalisées, étiquetées à la main, plus les résultats de vérification et de retour que la passerelle enregistre déjà.
Étape 1 : installation (5 secondes et 800 Mo)#
uv venv --python 3.12 train/.venv
uv pip install --python train/.venv/bin/python laya==0.3.24 datasets pyyaml
mkdir -p train/work && cd train/work
curl -sLO https://raw.githubusercontent.com/NandhaKishorM/laya/v0.3.24/notebooks/laya_finetune_typed_decisions_mps.py
# uniquement le checkpoint anglais, pas tout le dépôt
../.venv/bin/python -c "from huggingface_hub import snapshot_download as s; \
  s('convaiinnovations/laya', local_dir='laya_base', \
    allow_patterns=['model.safetensors','rl_agent_config.json','encoder/*','tokenizer/*'])"
Étape 2 : transformer les étiquettes en éléments d’entraînement#
C’est l’étape où il est facile de se tromper subtilement. Le modèle doit être entraîné sur exactement ce qu’il verra à l’inférence : la même formulation des questions, les mêmes options dans le même ordre, la même forme de state. train/build_items.py importe donc le build_sequence de Laya lui-même et reconstruit mot pour mot les quatre questions du routeur. Un piège que je n’ai repéré qu’en lisant le code Go : la passerelle envoie les sujets sous forme de map Go, et l’encodeur JSON de Go trie les clés des maps. Laya voit donc les options dans l’ordre alphabétique, pas dans l’ordre de config.yaml, et les éléments d’entraînement doivent suivre le même ordre.
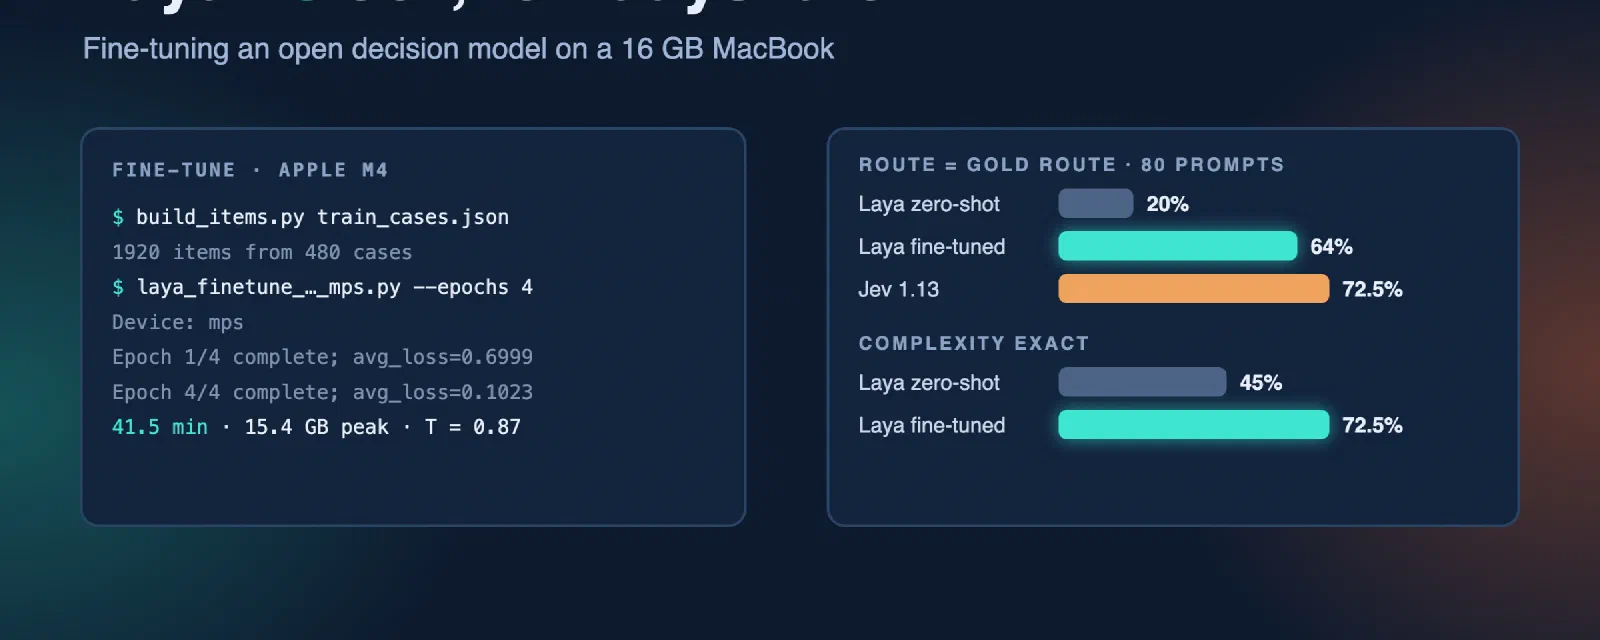
Chaque prompt devient quatre éléments (sujet, complexité, risque, données privées). Les cibles sont les étiquettes avec un peu de lissage (90 % sur l’étiquette, le reste surtout sur les niveaux voisins pour les scores), parce que des cibles à 100 % apprennent à un modèle à être trop sûr de lui :
train/.venv/bin/python train/build_items.py train/data/train_cases.json train/work/route_items.pt
1920 items from 480 cases -> train/work/route_items.pt (skipped 0)
Étape 3 : l’entraînement (41 minutes)#
La recommandation de Convai pour un MacBook de 16 Go : un exemple à la fois, avec des gradients accumulés sur 32 :
cd train/work
../.venv/bin/python laya_finetune_typed_decisions_mps.py --model-dir ./laya_base \
  --items ./route_items.pt --output-dir ./laya-route \
  --micro-batch 1 --grad-accum 32 --epochs 4
00:10:39 Using legacy cached training items without metadata: route_items.pt
00:10:40 Device: mps
00:10:40 Training items: 1728; calibration items: 192
00:10:40 micro_batch=1; grad_accum=32; epochs=4
00:11:18 epoch 1/4, step 100, loss=0.9694
...
00:21:04 Epoch 1/4 complete; avg_loss=0.6999
00:31:16 Epoch 2/4 complete; avg_loss=0.2924
00:41:27 Epoch 3/4 complete; avg_loss=0.0979
00:51:44 Epoch 4/4 complete; avg_loss=0.1023
00:51:47 Running temperature calibration ...
00:52:01 Model saved to ./laya-route
00:52:01 Temperatures: [1.25038480758667, 1.4553054571151733, 1.0085362195968628](La ligne « legacy cached items » est normale : quand --items existe déjà, le script saute son propre dataset.) Le script met de côté 10 % des éléments pour l’ajustement de la température, ce qui va servir dans une minute.
| Apple M4, 16 Go, rien d’autre en cours | |
|---|---|
| Durée réelle, 4 epochs | 41,5 minutes, environ 10,3 minutes par epoch |
| Vitesse | ~0,36 s par élément d’entraînement |
| Pic d’empreinte mémoire | 15,4 Go : fermez le navigateur |
| Résultat | un checkpoint de 1,6 Go |
Combien de temps ça prendrait chez vous ? Avec des prompts courts comme les miens, comptez environ 0,36 s par élément et par epoch, et quatre éléments par prompt étiqueté : 4 epochs sur N prompts prennent à peu près N × 6 secondes. 500 prompts : moins d’une heure. 2 000 prompts : environ 3 heures, une nuit. Pour comparer, j’ai aussi lancé la recette officielle sur son propre dataset (6 000 éléments, avec des states plus longs) : elle tournait à 0,58 s par élément, ses 4 epochs prendraient donc environ 3,6 heures sur ce portable. J’ai mesuré les 700 premières étapes et je l’ai arrêtée là. Deux choses que j’ai essayées et qui n’ont pas aidé : des micro-batches de 8 étaient plus lents sur 16 Go, pas plus rapides, et faire tourner quoi que ce soit de lourd en même temps (mon rejeu Home Assistant, plus bas) ralentissait visiblement les deux.
Étape 4 : est-ce que ça marche ?#
Le sidecar a gagné une option --checkpoint NAME=DIR pour servir un checkpoint local, et le benchmark un fournisseur laya:NAME correspondant :
sidecar/.venv/bin/python sidecar/laya_server.py --checkpoint laya-route=train/work/laya-route &
go run ./cmd/bench -providers jev,laya,laya:laya-route
jev laya laya:laya-route
topic accuracy 88.8% 58.8% 85.0%
topic acc · tricky 42.9% 28.6% 100.0%
complexity exact / ±1 72.5% / 100.0% 45.0% / 98.8% 72.5% / 98.8%
risk exact 61.3% 31.2% 68.8%
confident (≥ threshold) share 85.0% 12.5% 0.0%
ECE (lower = better calibrated) 0.070 0.171 0.311
route = gold-label route 72.5% 20.0% 35.0%
under / over-provisioned 3 / 19 3 / 61 1 / 51Le bond en précision est bien réel : le sujet passe de 59 % à 85 %, la complexité de 45 % à 72,5 %, comme Jev, le risque de 31 % à 69 %, mieux que Jev. Et puis il y a la ligne de la confiance : 0 %. Pas une seule décision n’a atteint la barre de 0,8 du routeur, qui continue donc à jouer la sécurité et surdimensionne 51 prompts. La même maladie qu’avant, dans un modèle plus malin.
La cause vient en partie de moi : le lissage des étiquettes dit au modèle « ne sois jamais sûr à plus de 90 % », et le routeur lit le champ confidence de Laya, plus strict que la probabilité la plus haute. La solution, c’est la temperature de tout à l’heure, mais ajustée honnêtement : pas sur le benchmark, mais sur les 192 éléments que l’entraîneur avait mis de côté. Un petit script pose la question du sujet au checkpoint servi pour ces prompts mis de côté et cherche le T qui minimise la log-loss :
train/.venv/bin/python train/fit_temperature.py train/data/train_cases.json train/work/route_items.pt
52 held-out cases, topic accuracy 79%, log-loss 0.766 at T=1 -> 0.748 at T=0.87
go run ./cmd/bench -providers laya,laya:laya-route -temperature laya:laya-route=0.87
La colonne Jev vient du run de la même nuit, d’où les petites différences avec le tableau du début (0,070 au lieu de 0,068, par exemple).
| Jev 1.13 | Laya zero-shot | Laya fine-tuné | Laya fine-tuné, T = 0,87 | |
|---|---|---|---|---|
| Sujet correct | 89 % | 59 % | 85 % | 85 % |
| Complexité exacte | 72,5 % | 45 % | 72,5 % | 72,5 % |
| Risque exact | 61 % | 31 % | 69 % | 69 % |
| Réponses confiantes (≥ 0,8) | 85 % (dont 94 % justes) | 12,5 % | 0 % | 86 % (dont 90 % justes) |
| Erreur de calibration | 0,070 | 0,171 | 0,311 | 0,082 |
| Même route que la référence | 72,5 % | 20 % | 35 % | 64 % |
| Modèle moins cher / plus cher que la référence | 3 / 19 | 3 / 61 | 1 / 51 | 9 / 20 |
| Coût modèle estimé (référence 1,18 $) | 1,35 $ | 1,74 $ | 1,80 $ | 1,28 $ |
| Latence de décision p50 (GPU M4) | 250 ms | 283 ms | 308 ms | 319 ms |
| Coût de la décision | 0,04 $ / 1k | 0 $ | 0 $ | 0 $ |
De 20 % à 64 % de routes identiques à la référence, avec une calibration presque aussi bonne que celle de Jev, et un coût routé légèrement inférieur à celui de Jev. Pour 41 minutes sur un portable et 480 prompts étiquetés, c’est bien plus que ce que j’attendais. De tous les modèles ouverts que j’ai testés, c’est le premier que j’envisagerais vraiment de brancher sur la passerelle.
Maintenant les réserves, parce qu’elles comptent :
- L’étiqueteur est le même. Les 480 prompts d’entraînement et les 80 étiquettes de référence ont été écrits par le même genre d’étiqueteur (un agent LLM qui suit les mêmes conventions). Une partie du gain vient du fait que le modèle apprend l’idée que cet étiqueteur se fait de la complexité et du risque. C’est tout l’intérêt du fine-tuning (c’est l’idée de ma configuration, pas une idée générique), mais c’est aussi pour ça qu’il peut battre Jev sur le risque. Sur les étiquettes de quelqu’un d’autre, l’écart serait plus faible.
- Les groupes sont minuscules. 100 % sur le groupe « piégeux », ça sonne bien, mais ça fait 7 prompts.
- Il est moins prudent que Jev. 9 prompts partent vers un modèle plus faible que la référence, contre 3 pour Jev. C’est le sens d’erreur que j’aime le moins. Un
confidence_thresholdou une température plus élevés échangeraient un peu d’économies contre de la sécurité. - Jev gagne toujours sur la partie difficile : quand il est sûr, il a raison 94 % du temps, et il le fait en zero-shot, sur n’importe quelle question que vous inventerez demain. Mon Laya est bon sur ces quatre questions-là. Posez-lui autre chose, et vous retrouvez le modèle de base.
La recette, les scripts et les prompts étiquetés sont dans le dépôt : docs/fine-tuning.md.
Retour à la maison : Laya peut-il juger mes automatisations ?#
Le routeur est un cas d’usage. L’autre, celui qui tourne 24 h/24, c’est ma maison : depuis le premier article sur Home Assistant, Jev répond aux questions « est-ce que c’est normal ? » que mes règles à seuils ne savent pas trancher, toujours à côté de la règle, d’abord en mode shadow. Dans le deuxième, un lecteur sur Mastodon demandait pourquoi ne pas utiliser un petit modèle local, et j’avais expliqué pourquoi je n’étais pas passé en local sur un mini PC N100. C’était le bon moment pour vérifier cette réponse avec des chiffres plutôt qu’avec des arguments.
D’abord, comment Jev s’en sort dans la maison#
Le tableau de bord a été remis à zéro le dimanche 27 septembre, voici donc une semaine des nouveaux prompts (avec l’historique compact et la ligne de base d’humidité du deuxième article), tirée directement de l’instance en production :
| Décision | Interrogée | En désaccord avec la règle | Retour « qui avait raison ? » |
|---|---|---|---|
| VMC (choix de la vitesse) | 265 | 17 (6 %) | Jev 3, règle 0 |
| Volets contre chaleur (oui/non par volet) | 198 | 6 (3 %) | — |
| Arrosage ce soir ? | 5 | 0 | — |
| Simulation de présence (choix de la pièce) | 4 | 4 | — |
| Lessive, eau, chute de température, chauffe-eau | 6 | 0 | — |
La VMC, c’est la ligne intéressante. Dans le deuxième article, elle était en désaccord avec la règle à chaque appel, toujours avec une confiance trop basse pour agir. Avec l’historique dans le prompt, elle n’est plus en désaccord que 6 % du temps, et sur les trois désaccords auxquels j’ai répondu depuis la notification du téléphone, Jev avait raison les trois fois (l’un d’eux, une douche vendredi soir, fait partie des exemples plus bas). La simulation de présence est nouvelle et encore dans sa phase « Jev et la règle choisissent des pièces différentes », ce qui est normal : la règle y fait un tirage aléatoire pondéré, un désaccord est donc attendu.
Côté coût, rien n’a changé : hier, 84 appels, 118k tokens en entrée, un demi-centime.
Rejouer 80 vraies décisions de la maison à travers Laya#
Pour comparer Laya à Jev sur des questions de la maison plutôt que sur des prompts de routage, il me fallait les vraies requêtes. Home Assistant ne journalise que le résultat de chaque décision (« jev=True (p=0.71) rule=False »), pas les faits envoyés, alors j’ai demandé à Claude Code de les reconstruire, en lecture seule :
- les définitions des questions (instructions, options, seuils) viennent directement du dépôt de ma configuration ;
- les faits actuels ont été rendus sur l’instance en production avec les vrais templates ;
- les moments passés, en particulier les désaccords journalisés, ont été reconstruits à partir du logbook, du capteur de timeline et des relevés du recorder. Pour 11 des 19 moments journalisés, un nouvel appel à Jev a reproduit la probabilité journalisée à ±0,1 près : la plupart des reconstructions sont donc fidèles, mais pas toutes ;
- chaque payload est parti vers Jev, vers Laya anglais et vers Laya multilingue, ces deux derniers sur le CPU avec 4 threads, pour se rapprocher de mon N100 à 4 cœurs.
80 payloads au total, 80 appels à Jev, 0,0043 $. Les résultats, avec chaque réponse convertie en oui/non au seuil que l’automatisation utilise vraiment (0,6 pour la VMC, 0,7 pour les volets et l’arrosage, 0,8 pour l’eau) :
| Décision | n | Laya anglais = Jev | Laya multilingue = Jev | p de Jev | p de Laya anglais | p de Laya multilingue |
|---|---|---|---|---|---|---|
| VMC | 19 | 15 | 4 | 0,07 – 0,75 | 0,52 – 0,61 | 1,00, toujours |
| Volets | 18 | 15 | 3 | 0,14 – 0,86 | 0,54 – 0,57 | 0,72 – 0,99 |
| Débit d’eau | 15 | 12 | 4 | 0,09 – 0,85 | 0,46 – 0,54 | 0,85 – 0,98 |
| Arrosage | 12 | 12 | 0 | 0,12 – 0,61 | 0,52 – 0,54 | 0,98 – 0,99 |
Ne vous laissez pas tromper par la colonne « Laya anglais = Jev ». Laya anglais répond environ 0,5 à tout : ses probabilités vont de 0,46 à 0,61 sur 64 questions oui/non. Il n’est « d’accord » avec Jev que parce que 0,5 est sous tous les seuils : il n’agit jamais, et Jev non plus, la plupart du temps. Sa corrélation de rang avec les probabilités de Jev est même légèrement négative sur la VMC et les volets. Le checkpoint multilingue a le problème inverse : il dit oui à presque tout, avec une grande confiance, y compris à « la lumière de la cuisine est-elle allumée ? » quand l’état indique qu’elle est éteinte.
Quatre moments pour rendre ça concret :
- Vendredi 20 h 00, une douche. L’humidité de la salle de bain de l’étage passe de 67 % à 82 %, l’air extérieur est plus sec que l’air intérieur. Jev : 0,75, booster la VMC (et j’avais répondu « Jev avait raison » sur mon téléphone ce soir-là). Laya anglais : 0,52, non. Laya multilingue : 1,00.
- Vendredi 19 h 56, 11 L/min d’eau juste après notre retour à la maison. Jev : normal (0,67), cause « douche ou bain » à 0,93. Laya anglais : 0,49, cause « autre » à 0,06. Laya multilingue : 0,96, cause « chasse d’eau qui coule ».
- Une fuite nocturne. 0,8 L/min, plat, pendant des heures, à 4 h 30, aucun changement d’humidité nulle part. Jev : 0,11, suspect, cause « fuite ». Laya multilingue : 0,97, normal. C’est au-dessus de la barre de 0,9 pour les fuites : en mode active, il aurait supprimé l’alerte de fuite. C’est celle-là qui coûterait de l’argent.
- Après-midi chaud, salon, 27,8 °C dehors et plein soleil. Jev : 0,86, baisser les volets. Laya anglais : 0,54. Laya multilingue : 0,99, mais il disait aussi 0,94–0,97 les jours frais et pluvieux.
Et le côté pratique :
| Jev (réseau) | Laya anglais, CPU 4 threads | Laya multilingue, CPU 4 threads | |
|---|---|---|---|
| Latence, médiane / p95 | 310 / 479 ms | 684 / 2 221 ms | 329 / 1 635 ms |
| Eau (3 questions en un appel) | 315 ms | 1 487 ms | 1 435 ms |
| Payloads tronqués par la fenêtre de contexte | 0 / 80 (32k tokens) | 64 / 80 (512 tokens) | 34 / 80 (1 024 tokens) |
C’est un cœur de M4, bien plus rapide qu’un cœur de N100 : sur le mini PC, multipliez par « plusieurs ». Une partie du p95 est aussi de ma faute : la première tentative du fine-tuning ci-dessus tournait sur le GPU en même temps.
Là où je me suis trompé dans les articles précédents#
Rejouer de vraies requêtes rend humble, alors laissez-moi corriger trois choses que j’ai écrites :
- « Mes requêtes font environ 300 tokens de texte utile, ce qui rentre dans 512. » C’était vrai pour la première version. Depuis que le deuxième article a ajouté l’historique compact à chaque décision, les requêtes font 1 000 à 1 900 tokens. La correction de « Jev n’a pas de mémoire » est exactement ce qui les rend trop longues pour Laya anglais : il lit moins de la moitié d’une requête VMC. Pour Jev, avec 32k tokens, ce n’est rien.
- « Je prendrais le checkpoint multilingue, qui lit aussi mieux les noms français de mes entités. » Les payloads sont en anglais par conception (seuls quelques noms d’entités et « Vitesse 2 » sont en français), et le checkpoint multilingue est ici le pire des deux. La langue n’a jamais été le problème. Et envoyer une requête plus courte, sans les séries d’historique, n’a aidé aucun des deux checkpoints.
- « Quand il est confiant, il a raison. » Vrai sur les prompts de routage. Sur les questions de la maison, Laya anglais n’est tout simplement jamais confiant, et le multilingue est confiant et se trompe. Le benchmark de routage ne s’est pas transposé, ce qui rappelle utilement qu’un benchmark mesure ses questions.
La conclusion du deuxième article tient, chiffres à l’appui désormais : sur mon matériel et avec mes questions, Laya en zero-shot n’est pas une option, et ce n’est pas une question de CPU. La maison reste sur Jev.
Les alternatives côté Home Assistant#
Si vous voulez quand même essayer, l’écosystème a lui aussi bougé vite. HA-Jev, l’intégration que j’utilise (capteurs, actions jev.noul / jev.choice / jev.score / jev.ask, un agent Assist), ne fonctionne toujours qu’avec Jev dans le cloud et s’installe comme dépôt personnalisé HACS ; il en existe plusieurs forks. Il y a aussi des composants plus ciblés comme ha-conversation-jev (un chemin rapide Jev pour les lumières, le chauffage et les volets) et « Gut Check », un bilan de santé hebdomadaire de votre installation. Pour les modèles locaux, la passerelle la plus pratique que j’ai trouvée est Decidealot, un service Docker qui sert Laya, Von ou CLM derrière une API REST compatible TypeSafe : en théorie, il suffit de pointer l’adresse personnalisée de HA-Jev dessus. Je ne l’ai pas essayé, et après le rejeu ci-dessus, je n’y brancherais qu’un modèle fine-tuné.
La suite#
Où en sont les deux projets :
- system-one-router : le Laya fine-tuné devient une vraie option pour
decision.provider: auto, où les prompts privés sont décidés en local. Avant d’en faire le fournisseur principal, je veux l’entraîner sur du vrai trafic : quelques centaines de requêtes journalisées et étiquetées à la main, plus les résultats de vérification et de retour que la passerelle journalise déjà. Kev, qui fournit son proprekev-finetune, mérite le même traitement, idéalement la version 4B sur une machine plus costaude. - Home Assistant : la maison reste sur Jev. Le chemin vers un modèle local est désormais clair, cela dit : les réponses « qui avait raison ? » du tableau de bord et les vérifications automatiques du résultat (la pompe s’est vraiment arrêtée, l’alerte de fuite était ou n’était pas une fuite) sont des étiquettes qui sont les miennes, pas celles de Jev. Quelques semaines de ces données, un fine-tuning avec le checkpoint multilingue et sa fenêtre de 1 024 tokens (ou un payload plus petit, l’historique étant la partie longue), et ça devient intéressant. Au rythme actuel des désaccords, cela dit, en collecter assez prendra du temps, ce qui est aussi une bonne nouvelle pour Jev.
Leçons apprises#
- Une nouvelle version n’est pas un nouveau modèle. 18 versions de Laya, zéro changement dans les chiffres : les poids n’avaient pas bougé. Vérifiez ce qui a réellement changé avant de relancer un benchmark, et relancez-le quand même.
- Les modèles de décision zero-shot sont une base, pas un produit. Le README de Laya le dit lui-même, et le passage de 20 % à 64 % de bonnes routes après 41 minutes d’entraînement le montre.
- La calibration, c’est la moitié du travail, encore une fois. Le modèle fine-tuné est passé de « jamais confiant » à « aussi calibré que Jev » avec un seul chiffre, T = 0,87. Ajustez-le sur des données mises de côté, jamais sur votre jeu de test.
- Entraînez sur vos propres étiquettes. C’est ce qu’exigent les conditions de TypeSafe, et c’est aussi ce que vous voulez vraiment : un modèle qui connaît vos définitions, pas une copie de celles de quelqu’un d’autre.
- Un portable suffit. 480 prompts, 41 minutes, 15 Go de mémoire. Ce qui coûte cher, ce sont les étiquettes, pas le GPU.
- Rejouez de vraies requêtes avant de croire un benchmark. Le benchmark de routage disait « quand Laya est confiant, il a raison ». Ma maison a dit le contraire, et l’historique que j’ai ajouté pour Jev rendait de toute façon les requêtes trop longues pour Laya.
Le code, les scripts d’entraînement et les 480 prompts étiquetés sont sur GitHub : mmornati/system-one-router, et le rapport de benchmark est en ligne. Si vous fine-tunez un modèle de décision sur vos propres données, en particulier pour Home Assistant, j’aimerais vraiment comparer nos notes dans les commentaires.
Comment il a été construit#
Même configuration que pour les articles précédents : une session Claude Code avec Opus 5.5. Une première session avait mis à jour Laya, ajouté Von et Kev au benchmark et ouvert la pull request. Celle-ci a vérifié ce travail, cherché les modèles plus récents, mesuré la recette d’entraînement officielle, écrit les 480 prompts étiquetés (avec un sous-agent) et les scripts d’entraînement, lancé le fine-tuning et les benchmarks, et rejoué les décisions Home Assistant (avec un autre sous-agent, en lecture seule sur l’instance en production). Mon rôle a été de choisir quoi mesurer, de challenger les résultats (la ligne à 0 % de confiance a été le moment de s’arrêter pour réfléchir), et de décider quoi garder.