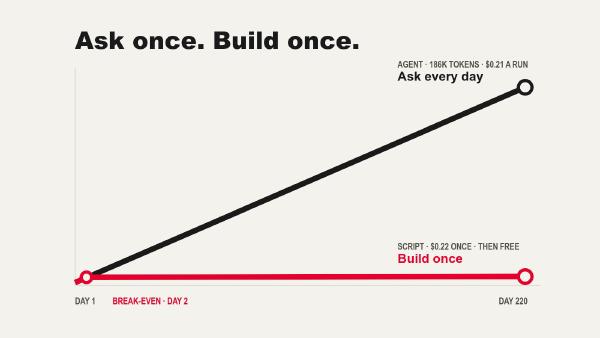
Demander à un agent de bloquer du temps de concentration, de résumer les chiffres d’hier ou de trouver un créneau de réunion, ça marche, mais on paie à chaque fois, et la réponse change. J’ai mesuré 14 exécutions de Claude Code sur trois tâches du quotidien. Écrire le script une fois coûte à peu près autant que poser la question une fois. Avec un calculateur interactif, une checklist, et mes propres projets comme exemples.
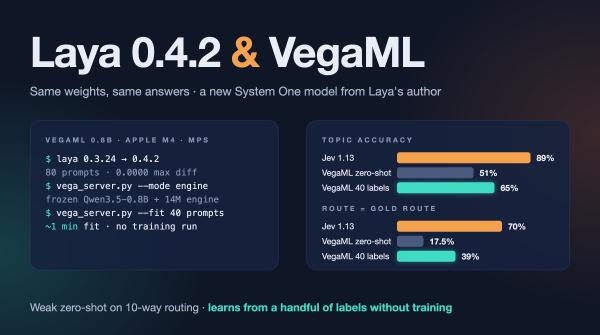
Laya a publié huit versions et rien n’a bougé pour le routage. Son auteur a aussi publié VegaML, un modèle de décision qui répond en laissant une particule se poser au fond d’une vallée. En zero-shot, il n’est pas prêt pour mon routeur, mais il peut apprendre à partir de 40 étiquettes en une minute, ce qu’aucun des autres modèles ne sait faire.
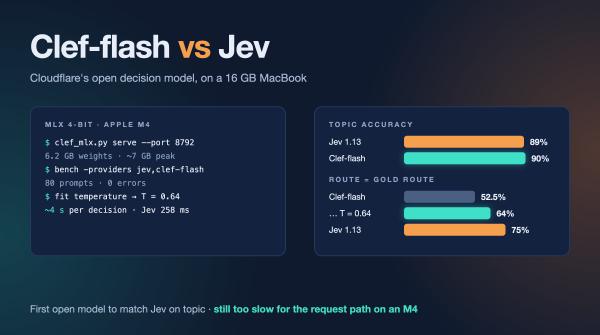
Trois jours après l’annonce de Cloudflare, Clef-flash est passé par le même benchmark de 80 prompts que Jev, Laya, Von et Kev. 90 % de précision sur le sujet, une température de confiance qui le met au niveau de Jev sur la calibration, et un problème qu’aucune température ne règle sur un portable.
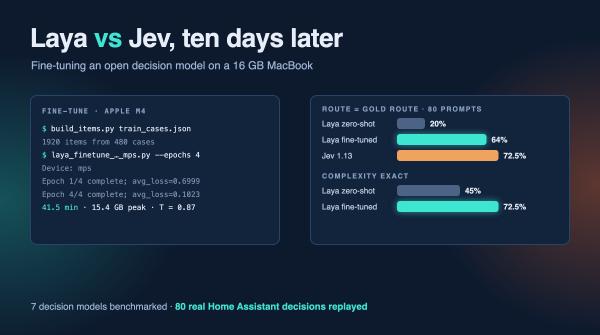
Laya dit « fine-tunez-moi », alors je l’ai fait, sur un MacBook de 16 Go. Voici la recette, le temps que ça prend, ce que ça change sur le benchmark de 80 prompts, et pourquoi ma maison tourne toujours sur Jev.
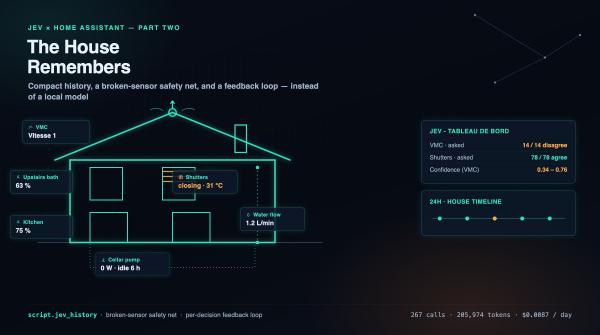
Le vrai correctif à « Jev n’a pas de mémoire », ce n’était pas un autre modèle. C’était de donner une mémoire à Jev. Voici le script d’historique, la boucle de retour, et ce que le tableau de bord en direct raconte déjà.
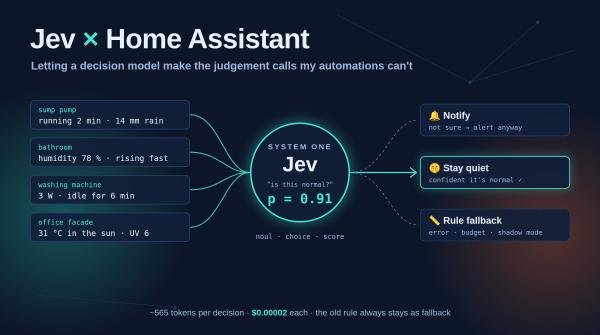
Mes automatisations sont douées pour les seuils et nulles pour le contexte. Jev répond à des questions typées avec une probabilité calibrée, pour environ deux millièmes de centime la question. Voici comment je l’ai branché sur Home Assistant en gardant les anciennes règles comme filet de sécurité, et ce que ça coûte vraiment.
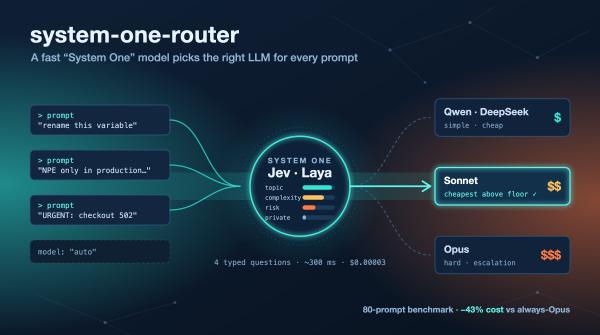
Mon premier routeur de modèles laissait un LLM lire un fichier de prompt pour choisir un agent. Celui-ci pose quatre questions typées à un modèle de décision « System One », calcule le score des modèles avec de la simple arithmétique, et publie un benchmark pour prouver que ça marche (et montrer où ça ne marche pas).