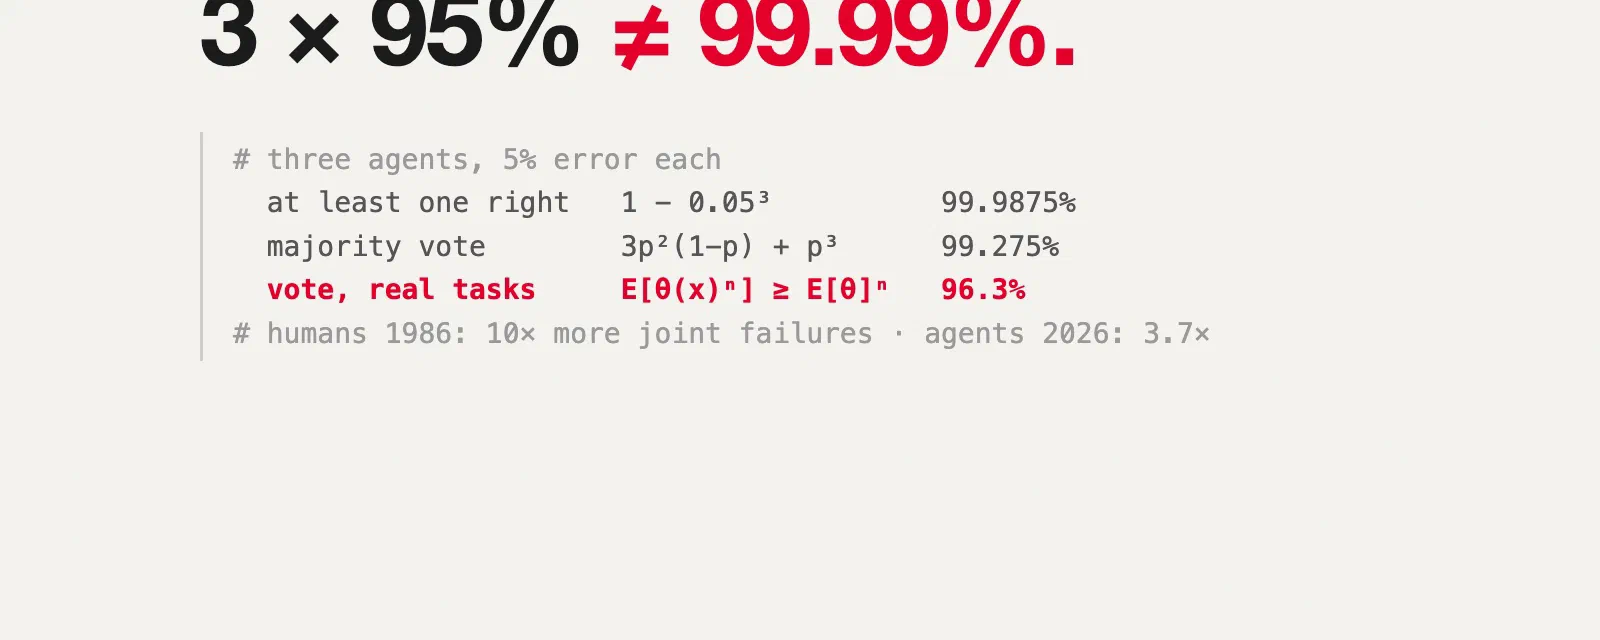
Chaque réponse d’un LLM vient avec un taux d’erreur. Même un très bon agent de code se trompe sur certaines tâches : disons une sur vingt, 5 %. On ne peut pas ramener ce chiffre à zéro, mais la statistique a une vieille astuce pour les mesures peu fiables : ne pas se fier à une seule, en prendre plusieurs. Si on confie la même tâche à plusieurs agents, la probabilité qu’ils se trompent tous devrait chuter vite. Avec trois agents à 5 % d’erreur chacun, la probabilité qu’au moins un ait raison vaut :
1 - 0.05 × 0.05 × 0.05 = 99.9875%C’est le chiffre derrière chaque argumentaire « utilisez plusieurs agents », et celui que j’avais en tête quand j’ai commencé à utiliser un deuxième modèle pour relire les pull requests du premier. La vraie question est de savoir s’il tient, et pas besoin d’une nouvelle expérience pour le vérifier. Des décennies d’ingénierie de la fiabilité fournissent déjà les données : un rapport de la NASA de 1985, une expérience célèbre de 1986 avec des programmeurs humains, deux réplications avec des agents de code publiées cet été, plus les benchmarks publics et les études sur les défauts. Cela suffit pour faire les calculs et les estimations de cet article.
Cet article, c’est cette réponse. La version courte : oui, plus d’exécutions, plus de modèles et une vérification indépendante aident tous, et les maths expliquent pourquoi. Mais ils aident beaucoup moins que ce que dit la formule naïve, et la raison est la même que celle qu’on a découverte avec les programmeurs humains il y a quarante ans.
1. La formule est juste, la question est fausse#
1 - 0.05³ est la probabilité qu’au moins un des trois agents ait raison. Pour en faire un résultat, il faut deux choses :
- Les agents échouent de façon indépendante. La probabilité que l’agent B échoue ne dépend pas de l’échec de l’agent A.
- On sait reconnaître la bonne réponse. Quelqu’un, une suite de tests complète ou un oracle, choisit la sortie correcte chaque fois qu’il y en a une.
La deuxième hypothèse est celle qu’on oublie. En pratique, on a rarement un oracle ; si on en avait un, on n’aurait pas besoin de trois agents. Alors on vote : on garde la réponse sur laquelle au moins deux des trois sont d’accord. Avec des agents indépendants à 95 %, le vote à la majorité donne :
P(majority right) = 3p²(1 - p) + p³ = 99.275%C’est encore impressionnant, mais l’erreur résiduelle est passée de 0,0125 % à 0,725 %, 58 fois plus, uniquement parce que personne ne sait quelle réponse est la bonne. Cet écart entre « au moins un a raison » (ce que les articles appellent pass@k) et « le vote a raison » est la première chose à garder en tête. L’article Large Language Monkeys l’a mesuré sur du code : la couverture continue d’augmenter avec le nombre d’échantillons, mais sans vérificateur, le vote et les modèles de récompense plafonnent.
2. La difficulté, c’est de la corrélation#
La première hypothèse est pire, et elle n’a besoin d’aucun argument mystérieux du genre « les modèles pensent pareil ». Les tâches ne sont tout simplement pas toutes aussi difficiles.
Prenons deux mondes où les agents ont exactement la même précision moyenne de 95 % :
- Monde A : chaque tâche échoue 5 % du temps.
- Monde B : 90 % des tâches sont faciles et échouent 1 % du temps ; 10 % sont difficiles et échouent 41 % du temps. En moyenne, ça fait toujours 5 %.
Un seul agent ne peut pas distinguer les deux mondes. Trois agents, si :
| 3 agents, 95 % de précision moyenne | Monde A (indépendant) | Monde B (tâches faciles + difficiles) |
|---|---|---|
| Au moins un a raison (oracle) | 99,9875 % | 99,31 % |
| Le vote à la majorité a raison | 99,275 % | 96,31 % |
Dans le monde B, les trois agents échouent ensemble 55 fois plus souvent que ce que prévoit l’indépendance. Personne n’a copié personne. Ils sont simplement tous mauvais sur les mêmes tâches difficiles. Et ajouter des agents n’aide presque pas : avec un vote à la majorité, le monde B passe de 96,3 % avec 3 agents à 96,7 % avec 5 et 97,1 % avec 9. Si les tâches difficiles échouent plus d’une fois sur deux, le vote les rend même pires, et c’est ce qu’ont trouvé Chen et al. : plus d’appels au LLM aident sur les requêtes faciles et nuisent sur les difficiles.
Ce n’est pas une idée nouvelle. C’est le modèle d’Eckhardt-Lee, écrit pour la NASA en 1985 pour les logiciels de vol redondants, et affiné par Littlewood et Miller. Si θ(x) est la probabilité qu’une version choisie au hasard échoue sur l’entrée x, alors :
P(all n versions fail) = E[θ(x)ⁿ] ≥ (E[θ(x)])ⁿToute l’histoire est dans cette inégalité : dès que la difficulté varie d’une entrée à l’autre, l’échec simultané est plus probable que ce que prévoit l’indépendance. La seule façon d’en sortir, c’est de rendre les versions différentes exprès, pour que leurs θ(x) n’atteignent pas leur maximum sur les mêmes entrées.
On peut reproduire les deux tableaux en quelques lignes :
from math import comb

def vote_fails(theta, n):
    return sum(comb(n, k) * theta**k * (1 - theta)**(n - k)
               for k in range(n // 2 + 1, n + 1))

worlds = {"A": [(1.0, 0.05)], "B": [(0.9, 0.01), (0.1, 0.41)]}
for name, tasks in worlds.items():
    for n in (1, 3, 5, 9):
        oracle = 1 - sum(w * t**n for w, t in tasks)
        vote = 1 - sum(w * vote_fails(t, n) for w, t in tasks)
        print(f"world {name}, n={n}: oracle {oracle:.4%}, vote {vote:.4%}")
3. Ce qu’on a mesuré : des humains en 1986, des agents en 2026#
En 1986, John Knight et Nancy Leveson ont fait l’expérience : 27 étudiants de deux universités ont écrit des versions indépendantes du même programme à partir de la même spécification, et chaque version a été exécutée sur un million d’entrées aléatoires. Sous l’hypothèse d’indépendance, ils attendaient environ 127 échecs simultanés. Ils en ont observé 1 255, à peu près dix fois plus. L’indépendance a été rejetée avec 99 % de confiance, et les échecs se concentraient sur les parties difficiles de la spécification.
En juin, Ron, Baudry et Monperrus l’ont rejouée avec des agents de code : 69 versions issues de 5 harnais d’agents et de 23 modèles, le même genre de spécification, un million de tests. Les résultats :
- Prises une par une, les versions des agents sont bonnes : 27 des 48 qui ont passé la recette n’ont eu aucun échec sur le million d’entrées, et la moyenne était de 387 échecs par version (environ 0,04 %).
- Les triplets avec vote à la majorité réduisent les échecs moyens d’environ deux tiers (de 387 à 131).
- Mais l’indépendance est de nouveau rejetée : 429 échecs simultanés observés contre 115 attendus, 3,7 fois plus. Les échecs se concentrent sur les ambiguïtés de la spécification, exactement comme avec les étudiants.
Une deuxième étude de 2026, Nogueira et al., a fait tourner 12 modèles sur 224 problèmes dans 5 langages, et a trouvé que les gains du vote à la majorité restent sous la moitié de ce que prévoit l’indépendance, et qu’aucun ensemble n’a battu le meilleur modèle seul. Le choix du modèle comptait le plus ; le style de prompt, presque pas.
Le résumé honnête est donc : l’ensemble aide, d’un facteur trois environ sur les échecs, pas d’un facteur quatre cents.
4. Des modèles différents ? Mieux, mais moins qu’on l’espère#
Si le problème, c’est que les versions partagent leurs angles morts, la solution évidente est de choisir des versions qui ne les partagent pas : des familles de modèles différentes. Ça aide, avec une réserve.
Kim et al. (ICML 2025) ont étudié plus de 350 modèles. Quand deux modèles se trompent tous les deux, ils choisissent la même mauvaise réponse environ 60 % du temps sur un des classements. Et plus les modèles sont précis, plus leurs erreurs sont corrélées, même d’un fournisseur à l’autre. Goel et al. ont trouvé la même chose : quand les capacités augmentent, les erreurs se ressemblent de plus en plus. Les grands modèles sont entraînés sur le même internet, le même GitHub, et de plus en plus sur les mêmes données synthétiques. Leurs θ(x) atteignent leur maximum sur les mêmes entrées.
Ce qui décorrèle vraiment les erreurs, ce n’est pas le logo sur le modèle, c’est ce qu’on change autour :
- une entrée différente : une spécification réécrite ou clarifiée, un autre découpage de la tâche ;
- une méthode différente : une version écrite en commençant par les tests, une autre générée à partir d’exemples ;
- un autre type de vérification : des tests qui exécutent le code, pas un autre modèle qui le lit.
Ce dernier point, je l’utilise tous les jours.
5. Générer et relire : la vérification qui change la formule#
La plupart d’entre nous ne font pas tourner trois agents pour les faire voter. On fait tourner un agent qui écrit le code et un autre, ou le même dans un contexte neuf, qui le relit. La formule change :
P(bug ships) = P(generator wrong) × P(reviewer misses it)Avec un générateur à 95 % et un relecteur qui attrape 80 % des bugs, l’indépendance prévoit que 5 % × 20 % = 1 % des changements partent avec un bug. Le même problème de corrélation s’applique : le relecteur a le plus de chances de rater justement les bugs qui étaient difficiles à éviter au départ. Et il y a un deuxième risque, celui de l’auto-relecture. Goel et al. montrent que les LLM juges favorisent les sorties des modèles qui leur ressemblent, et plusieurs études trouvent que les modèles ratent dans leur propre sortie des erreurs qu’ils attrapent quand le même texte vient de l’extérieur. Les résultats sont partagés : un test vérifiable n’a trouvé aucune préférence pour soi mesurable. Mais personne n’a encore mesuré, sur du code avec une vérité de référence exécutable, à quel point un bug écrit par le modèle A est plus souvent approuvé par A que par un relecteur d’une autre famille. C’est la question ouverte la plus utile de tout ce domaine.
Ce que les chiffres permettent déjà de dire :
- Un relecteur vaut plus qu’un troisième générateur. Pour qu’un vote échoue, il faut que deux mauvaises réponses sur trois soient d’accord ; une relecture multiplie par le taux de ratés, et un relecteur qui lit la spécification et le diff, c’est une méthode différente, pas une troisième copie de la même.
- Préférez un relecteur d’une autre famille, dans un contexte neuf, avec la spécification mais sans le raisonnement du générateur.
- Préférez une vérification qui s’exécute. Des tests, un vérificateur de types, un fuzzer. Leurs erreurs ne sont pas du tout corrélées avec celles du modèle, et c’est exactement la propriété que demandent les maths. C’est aussi pour ça que j’ai construit Graft et le contrôle de release autour de vérifications scriptées, et pas autour d’un deuxième avis.
6. « On laisse le LLM valider la PR » : comment les outils font déjà les calculs#
Quand un outil dit « une IA relit votre pull request », c’est rarement un modèle qui lit un diff une seule fois. Les outils qui publient leur fonctionnement utilisent les mêmes ingrédients que les formules ci-dessus : plusieurs passes, un point d’entrée différent pour chacune, un vote ou un seuil, et une deuxième vérification de chaque problème trouvé.
BMAD-Method. La skill bmad-code-review de BMAD-Method (v6.12, octobre 2026) lance jusqu’à quatre relecteurs en parallèle. Chacun est un sous-agent neuf, sans contexte, et chacun reçoit volontairement une entrée différente :
| Relecteur | Ce qu’il reçoit | Ce qu’il cherche |
|---|---|---|
| Blind Hunter | le diff, rien d’autre | ce qui est faux et ce qui manque ; une liste vide n’est pas acceptée |
| Edge Case Hunter | le diff ; la description de la PR seulement après avoir tracé tous les chemins | les branches non gérées, et les promesses de la description que le code ne tient pas |
| Verification Gap Reviewer | le diff et les tests du dépôt | les changements de comportement qu’aucun test n’attraperait |
| Intent Alignment Auditor | l’intention du ticket ou du plan, et le diff | si le changement fait ce qui était demandé |
C’est la section 2 appliquée. Quatre relecteurs qui lisent la même chose avec le même contexte partagent le même θ(x). Donner à l’un seulement le diff, à l’autre les tests et au troisième l’intention déplace leurs angles morts à des endroits différents. La description de la PR est retenue exprès, pour que les affirmations de l’auteur ne puissent pas orienter l’analyse après coup : le cadrage de l’auteur est exactement le genre d’entrée partagée qui corrèle les erreurs. Ensuite, la session qui orchestre vérifie chaque problème contre le code avant de fusionner les doublons, et un relecteur qui échoue est signalé comme une relecture incomplète, pas comme un résultat propre. La version v6.2, celle que j’ai utilisée plus tôt cette année, avait déjà trois couches avec des accès différents : le diff seul, le diff plus le projet, le diff plus la spec. Ce que BMAD ne change pas par défaut, c’est le modèle : tous les relecteurs tournent avec le modèle de la session, et un autre modèle n’est qu’un repli ou une personnalisation. La section 4 dit que c’est la décorrélation la moins chère qui reste sur la table.
Claude Code. Le plugin code-review lance quatre agents en parallèle : deux agents Sonnet vérifient les règles du CLAUDE.md, un agent Opus lit seulement le diff, sans contexte supplémentaire, et un agent Opus cherche les bugs et les problèmes de sécurité dans le nouveau code. Ensuite, chaque bug reçoit son propre sous-agent validateur, qui doit le confirmer avec un haut niveau de confiance ; tout le reste est écarté. La version de novembre 2025 notait chaque problème de 0 à 100 et gardait ceux à 80 ou plus, un seuil de confiance. Le service managé Code Review d’Anthropic décrit la même forme (trouver en parallèle, vérifier, classer) et annonce que moins de 1 % des problèmes remontés sont marqués comme incorrects. Des angles différents, des entrées différentes, des tailles de modèle différentes, et une vérification qui vise les fausses alertes.
Cursor Bugbot. Bugbot a démarré avec la version la plus littérale de la section 1 : huit passes en parallèle sur le même diff, chacune avec le diff dans un ordre aléatoire différent, pour pousser le modèle vers des raisonnements différents. Les bugs trouvés par une seule passe étaient écartés par un vote à la majorité, et un modèle validateur filtrait le reste. Mélanger l’entrée est la façon la moins chère de changer le point d’entrée. Depuis, Bugbot est passé à une conception agentique, et son taux de résolution est passé de 52 % à plus de 70 % ; l’article ne dit pas si le vote a survécu.
OpenAI Codex. Le contre-exemple, c’est le relecteur d’OpenAI : un seul relecteur entraîné, pas un comité, mais avec accès à tout le dépôt et à l’exécution. Le laisser exécuter du code a amélioré à la fois le rappel et la précision par rapport à un relecteur qui ne voit que le diff. C’est le dernier point de la section 5 : une vérification qui s’exécute fait des erreurs qui ne sont pas corrélées avec celles du modèle.
Ce qu’ils ont en commun, et ce qui manque encore :
- Tous diversifient le point d’entrée ou l’angle. C’est le levier principal, et il ne coûte que des tokens.
- Seul Bugbot vote. Les autres gardent l’union de tous les problèmes trouvés et vérifient chacun. Pour une relecture, c’est le bon choix : un vote garde ce sur quoi la plupart des passes sont d’accord, donc un bug qu’un seul angle peut voir, comme un test manquant, serait éliminé par le vote. En relecture, le rappel vient de la diversité et la précision de la vérification.
- La vérification lit plus qu’elle n’exécute. Les relecteurs BMAD travaillent par inspection, le plugin Claude Code et le service managé ne compilent ni n’exécutent le code. Un vérificateur qui lit le code avec le même modèle partage ses angles morts ; un vérificateur qui lance un test, non. Ultrareview est l’exception côté Anthropic : il annonce que chaque problème est reproduit et vérifié de façon indépendante.
- La diversité de modèles est le levier le moins utilisé. BMAD utilise un seul modèle par défaut, et Claude Code mélange des tailles d’une même famille.
Donc « on laisse le LLM valider la PR », ça va, à condition que ça veuille dire ceci : plusieurs relecteurs avec des entrées différentes, chacun dans un contexte neuf, une vérification de chaque problème trouvé, et idéalement une autre famille de modèles et quelque chose qui s’exécute.
7. Et les humains ? Quarante ans de données sur les défauts#
La deuxième question que je me posais : comment tout ça se compare-t-il à nous ? Quelle est la probabilité qu’un changement écrit par un humain échoue, et comment se compare-t-elle à celle d’un modèle d’il y a un an et d’un modèle d’aujourd’hui ?
La première réponse honnête, c’est que les métriques ne correspondent pas. Les données humaines se comptent en défauts par ligne ou par point de fonction sur un projet entier. Les données des modèles se comptent en tâches réussies sur un benchmark. Avec cet avertissement, voici ce qu’on a.
Les humains, de 1975 à aujourd’hui#
| Source | Période | Ce qui est mesuré | Chiffre |
|---|---|---|---|
| Watts Humphrey, SEI | Années 1990 | Défauts introduits par des ingénieurs expérimentés, avant toute relecture ou test | 80-125 par KLOC |
| Ray Panko, données d’inspection | 1986-2006 | Fautes par ligne trouvées en inspection de code | 1,9 %-3,7 % des lignes |
| Panko, fautes résiduelles (Putnam & Myers, 1 486 projets) | 1975-1996 | Fautes restantes après la livraison | ~0,1 %-0,3 % des lignes (1-3 par KLOC) |
| Capers Jones | ~2010 | Moyenne américaine des défauts créés par point de fonction, part éliminée avant la release | 5,1 par PF, 86,7 % éliminés, 0,68 livré |
| Capers Jones, mêmes données | ~2010 | Équipes utilisant TSP/PSP | 4,0 par PF, 97 % éliminés, 0,12 livré |
| Coverity Scan | 2013-2014 | Défauts d’analyse statique sur ~10 milliards de lignes | 0,61-0,77 par KLOC |
| Logiciel embarqué de la navette spatiale (NASA) | Années 1990 | Erreurs dans chacune des trois dernières releases de 420 000 lignes | 1 par release |
Trois choses ressortent.
- Les humains font beaucoup d’erreurs et en attrapent la plupart. Environ 100 défauts par millier de lignes entrent ; un à trois sortent. Presque toute la qualité vient des étapes de relecture, d’inspection et de test, pas du premier jet.
- Le taux d’erreurs n’a presque pas bougé en quarante ans. Les potentiels de défauts de Jones paraissent stables d’un de ses écrits à l’autre, et son efficacité d’élimination est à peine passée d’environ 85 % (2007-2012) à un peu plus de 90 % (2015). Je n’ai trouvé aucune série fiable décennie par décennie avant ça. Ce qui change le résultat d’un facteur cinq à dix, c’est le processus : comparez 0,68 défaut livré par point de fonction pour la moyenne américaine avec 0,12 pour les équipes TSP/PSP, ou le groupe de la navette, qui est arrivé à une erreur pour 420 000 lignes avec 260 personnes et 35 millions de dollars par an.
- Les vérifications humaines sont l’ensemble d’origine. L’inspection plus les tests plus une autre personne qui relit, c’est exactement la « vérification indépendante » de la section 5, et elle a la même limite : Knight et Leveson ont montré que les humains partagent eux aussi leurs angles morts.
Pour comparer avec les modèles, il me faut la même unité. Le mieux que je puisse faire, c’est la probabilité qu’un changement typique parte avec au moins une faute. Prenons un changement de 50 lignes et les chiffres de Panko. Avant relecture, à ~3 % de fautes par ligne, la probabilité d’au moins une faute est de 1 - 0,97⁵⁰ ≈ 78 %. Après la relecture et les tests habituels, à ~0,3 % de fautes résiduelles par ligne, elle est de 1 - 0,997⁵⁰ ≈ 14 %. Prenez ces chiffres comme des estimations de coin de table, pas comme des mesures.
Les modèles, octobre 2025 et octobre 2026#
| Benchmark | Octobre 2025 | Octobre 2026 |
|---|---|---|
| SWE-bench Verified (500 vraies issues GitHub, tests cachés) | Claude Sonnet 4.5 : 77,2 %, GPT-5 : 74,9 % | 95-97 % en tête, désormais archivé car saturé |
| SWE-Bench Pro (plus difficile, résistant à la contamination) | ~23 % au lancement (GPT-5, Opus 4.1) | ~60 % sur le jeu d’origine ; 90-98 % sur la V2 nettoyée |
| Horizon temporel METR (durée des tâches à 50 % de réussite) | ~3,5 h (GPT-5), ~5 h (Opus 4.5, mesuré en janvier 2026) | ≥16 h (Claude Mythos Preview, mai 2026) |
| Taux de réussite sécurité Veracode (tâches sensibles pour la sécurité) | 55 % (45 % des tâches vulnérables) | 56 % en moyenne, meilleur modèle à 68 % |
Les taux de réussite des benchmarks surestiment la justesse, parce que les tests cachés sont faibles. SWE-ABS a revérifié les patchs « résolus » des 30 meilleurs agents et en a trouvé environ un sur cinq sémantiquement faux. Si j’applique cette décote, la probabilité qu’une tâche sorte juste :
- Octobre 2025 : environ 0,77 × 0,80 ≈ 60-65 % sur SWE-bench Verified, et moins de 25 % sur SWE-Bench Pro. Donc 35-40 % des tâches échouaient, plus du double des 14 % d’un changement humain relu, et pas loin d’un changement non relu.
- Octobre 2026 : 95 % ou plus sur un benchmark saturé. Même avec la même décote de 20 %, pessimiste pour des modèles plus forts, les échecs tombent à environ 5-25 %. C’est la fourchette d’un changement humain relu.
La seule comparaison à armes égales, c’est l’expérience N-version : le même genre de spécification, un million de tests. Les versions des agents de 2026 échouent en moyenne sur environ 0,04 % des entrées, et plus de la moitié n’échouent jamais. Shape of Code note que ça paraît beaucoup plus bas que les versions des étudiants de 1986. Gardez en tête que c’étaient des étudiants, pas des équipes professionnelles.
Et un chiffre n’a pas bougé : la sécurité. Le taux de réussite de Veracode sur les tâches sensibles pour la sécurité est resté entre 45 % et 55 % depuis 2023, pendant que les benchmarks fonctionnels passaient de 75 % à 95 %. Java est à 29 %, le XSS et l’injection de logs à 13-15 %. Le modèle écrit du code qui fonctionne beaucoup plus souvent qu’il y a un an. Il n’écrit pas beaucoup plus souvent du code sûr.
Il existe aussi des données sur de vrais dépôts, et elles sont moins spectaculaires que ce que disent les deux camps. Mao et al. ont apparié 36 855 unités de code probablement écrites par IA avec 65 391 unités humaines dans les mêmes dépôts : 10,0 alertes d’analyse statique par KLOC pour l’IA contre 13,6 pour les humains, le même taux d’alertes à haut risque, et un peu plus de corrections ultérieures pour le code IA. Des effets « plutôt faibles », selon leurs propres termes. De l’autre côté, CodeRabbit a compté 1,7 fois plus de remarques de relecture sur les pull requests assistées par IA fin 2025, sur un petit échantillon et de la part d’un éditeur qui vend de la relecture par IA. Je n’ai trouvé aucune étude de 2026 qui mesure les incidents en production du code écrit par IA face au code écrit par des humains. C’est le chiffre que tout le monde voudrait, et personne ne l’a encore.
8. Ce que j’en retiens#
Les maths et les données disent la même chose, pour les humains comme pour les modèles :
- Une seule exécution, c’est un brouillon. Les humains introduisent environ 100 défauts par millier de lignes ; les modèles échouent sur une part des tâches qui est passée d’environ 40 % à quelque part entre 5 % et 25 % en un an. Aucun des deux n’est prêt à livrer tel quel.
- La répétition aide moins que la diversité. Demander trois fois au même modèle revient surtout à échantillonner les mêmes angles morts. Trois familles de modèles font mieux, mais les meilleurs modèles sont de plus en plus d’accord entre eux, y compris sur leurs erreurs.
- La vérification qui rapporte le plus est celle dont les erreurs ne sont pas corrélées avec celles de l’auteur. Pour les humains, c’était l’inspection plus les tests plus le processus, et ça a divisé les défauts livrés par cinq à dix. Pour les agents, c’est un relecteur d’une autre famille avec la spécification en main, et surtout des vérifications qui s’exécutent : des tests, des types, du fuzzing, un contrôle de release.
- Corrigez la spécification avant d’ajouter des agents. En 1986 comme en 2026, les échecs communs se concentrent sur les spécifications ambiguës. Aucun ensemble ne corrige une question mal posée.
- La sécurité est l’exception. Les modèles sont devenus bien meilleurs pour écrire du code qui fonctionne, pas du code sûr. C’est un endroit où une vérification dédiée, un scanner ou une revue de sécurité, n’est pas optionnelle.
L’essentiel de ce qu’il faut pour raisonner sur les ensembles est déjà mesuré, et les calculs ci-dessus suffisent pour s’en servir. Ce qui reste ouvert est étroit : savoir si un modèle approuve ses propres bugs plus souvent qu’un relecteur d’une autre famille. Une poignée de tâches dotées de bons tests cachés suffirait pour y répondre.
Sources#
- Knight & Leveson, An Experimental Evaluation of the Assumption of Independence in Multi-Version Programming (1986)
- Eckhardt & Lee, A theoretical basis for the analysis of redundant software subject to coincident errors (NASA, 1985)
- Littlewood & Miller, Conceptual modeling of coincident failures in multiversion software
- Ron, Baudry, Monperrus, N-Version Programming with Coding Agents (2026)
- Shape of Code, Reliability via N-version programming (2026)
- Nogueira et al., Evaluating Failure Independence in LLM-Generated Code (2026)
- Kim et al., Correlated Errors in Large Language Models (ICML 2025)
- Goel et al., Great Models Think Alike and this Undermines AI Oversight (ICML 2025)
- Chen et al., Are More LLM Calls All You Need? (2024)
- Brown et al., Large Language Monkeys (2024)
- Watts Humphrey, The Software Quality Profile (SEI)
- Ray Panko, Human Error in Software
- Capers Jones, Software Quality in 2010
- Coverity Scan Open Source Report 2014
- They Write the Right Stuff (Fast Company, 1996)
- Anthropic, Introducing Claude Sonnet 4.5 (2025)
- Classement SWE-bench Verified (llm-stats) et Vals.ai
- Scale, SWE-Bench Pro et SWE-Bench Pro V2
- SWE-ABS : des patchs « résolus » sémantiquement faux (2026)
- METR, Time Horizon 1.1 (2026) et horizons temporels METR
- Veracode, 2025 GenAI Code Security Report et rapport 2026
- Mao et al., code généré par IA et code humain dans de vrais dépôts (2026)
- CodeRabbit, State of AI vs Human Code Generation (2025)
- Cross-Context Review (2026), Do LLM Evaluators Prefer Themselves for a Reason?, Self-Preference Is Weak or Absent in Verifiable Revision (2026)
- BMAD-Method, skill
bmad-code-review, v6.12 (2026) et les couches de relecture de la v6.2 - Anthropic, plugin
code-reviewde Claude Code et sa version de novembre 2025 - Anthropic, Code Review for Claude Code (2026) et Ultrareview
- Cursor, Building a better Bugbot (2026)
- OpenAI, Scaling code verification (2025)