Depuis quelques semaines, je teste jusqu’où le cycle de développement logiciel peut changer quand humains et agents travaillent sur le même tableau. Pas « une IA qui écrit du code pour moi », mais un espace de travail partagé : le backlog, les colonnes, les pull requests et les décisions vivent tous dans un GitHub Project, et humains comme agents le lisent et le mettent à jour.
J’ai mené l’expérience sur deux vrais projets. Horae, un agent personnel auto-hébergé, a été le premier. Avant d’écrire la moindre ligne de code, j’ai demandé à Claude de l’estimer de deux façons : en jours humains, si une équipe de développeurs le construisait, et en jours IA, si une équipe d’agents le construisait sous ma supervision. La réponse était claire, et un peu décevante : un humain avec quatre agents serait plus lent que trois développeurs. 76 semaines contre 22, parce que ma supervision serait le goulot d’étranglement. Angelia, un bus d’événements de releases écrit en Go, est arrivé quelques jours plus tard, avec un tableau organisé à partir de ce qu’Horae m’avait appris.
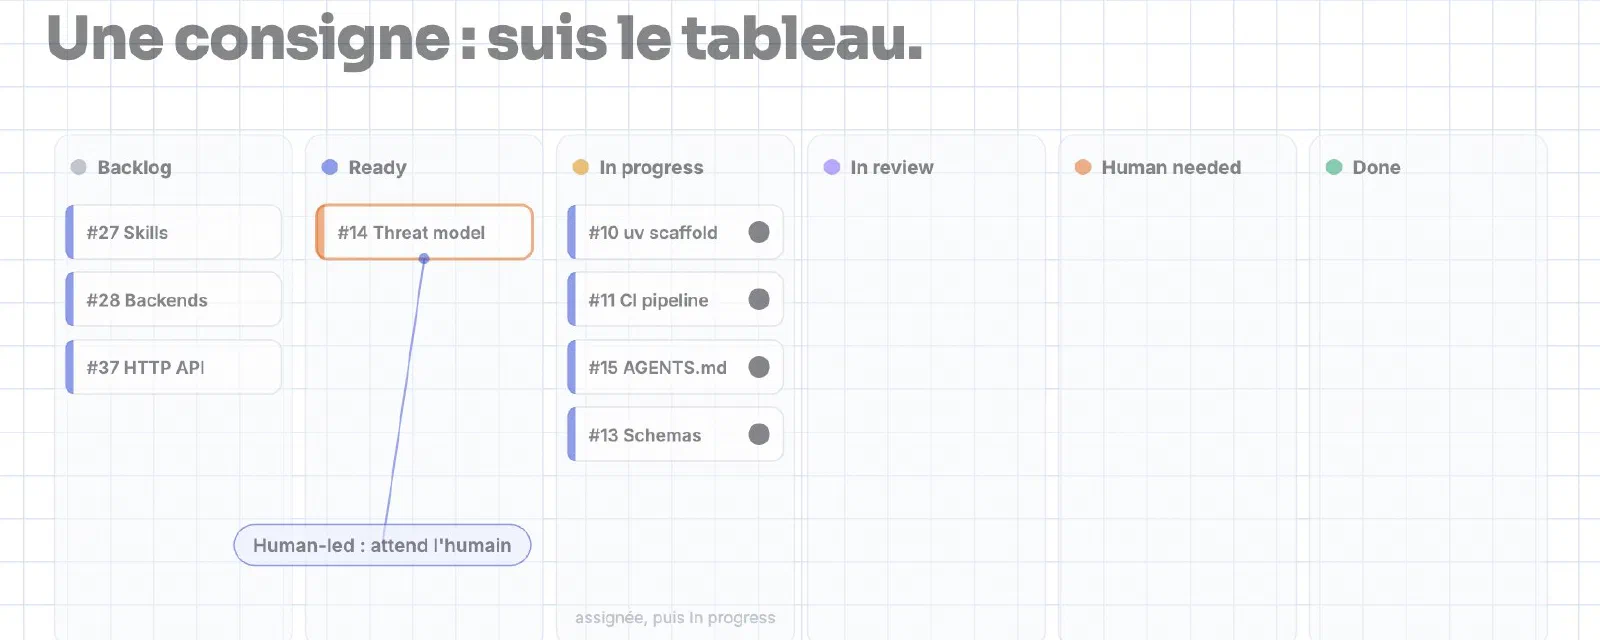
L’estimation ne m’a pas convaincu. J’ai donc organisé les deux projets pour que le tableau lui-même me donne la réponse : chaque story porte son estimation, et chaque story reçoit ses chiffres réels une fois terminée. Puis j’ai donné aux agents une seule consigne : suis le tableau.
Deux semaines et demie plus tard, tout le travail d’Horae qu’un agent pouvait faire est fusionné, Horae tourne sur mon serveur à la maison et a déjà envoyé un rappel sur mon téléphone, et Angelia a publié sa première release. Ce billet raconte comment cela fonctionne au quotidien, ce que disent les chiffres face à l’estimation, ce qu’ont changé le quota d’utilisation et la facture de tokens, et pourquoi le dernier kilomètre est resté surtout humain.
0. Le résultat d’abord#
Voici toute la boucle en une centaine de secondes. Comme mes vidéos précédentes, ce n’est pas un fichier vidéo : chaque image est dessinée en JavaScript, sur une voix de synthèse.
Appuyez sur Lecture (avec le son). Changez de langue dans la barre de contrôle ou activez les sous-titres. Ouvrez-la en pleine page pour avoir la liste des chapitres.
1. Deux projets#
Horae est un agent personnel prévisible et auto-hébergé : des pipelines fixes au lieu d’une boucle d’agent, au plus une étape LLM bornée, des plugins aux permissions déclarées installés depuis git. Le brief du matin, des rappels, des intégrations avec mes notes, mes calendriers et mes mails. Un vrai produit avec de vraies contraintes : des entrées non fiables, des secrets, des plugins que je n’ai pas écrits. En Python, 15 dépôts.
Angelia est un bus d’événements de releases auto-hébergé : il surveille PyPI, npm, crates.io, les releases GitHub et les registres OCI, et livre un CloudEvent signé par nouvelle version à la CI, aux chats et aux agents IA. En Go, 5 dépôts.
J’ai construit les deux surtout avec des agents dès le premier jour, avec moi comme mainteneur à temps partiel : le soir, quelques matins et le week-end.
2. D’abord les tickets, et c’est l’humain qui les valide#
Rien de ce qui suit ne fonctionne sans cette étape, et c’est celle qui m’a pris le plus de temps.
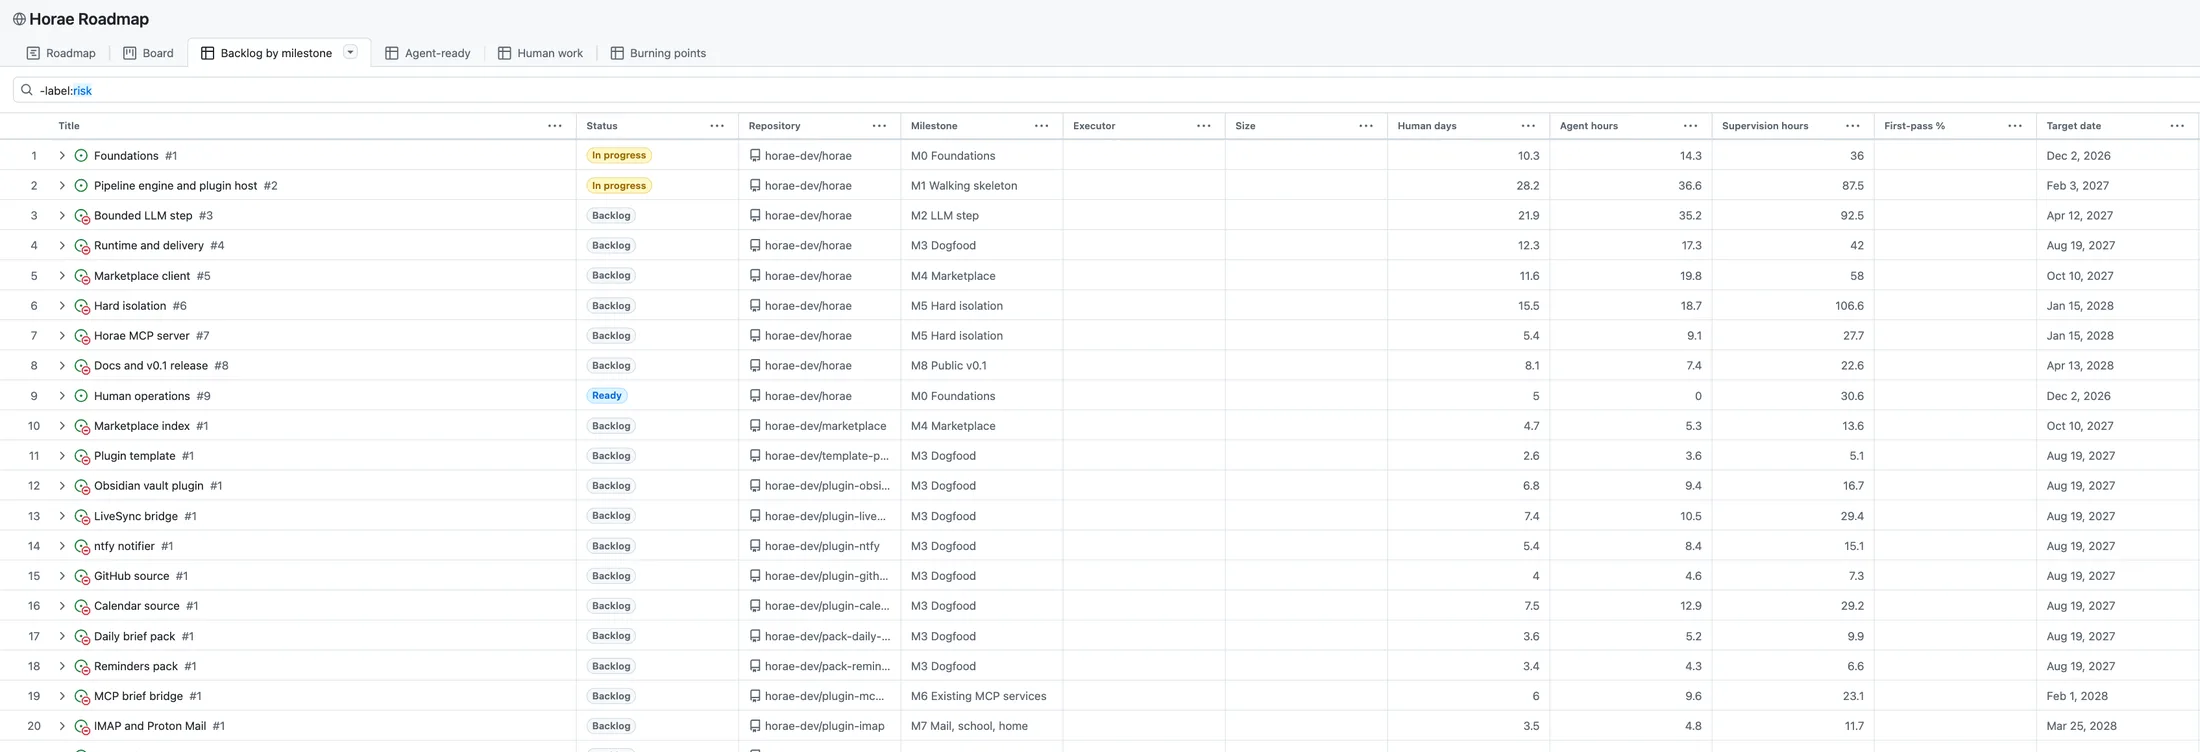
En quelques sessions, Claude et moi avons écrit le plan (PLAN.md), les décisions d’architecture à prendre et le backlog. Puis j’ai demandé à Claude de tout mettre sur GitHub : une organisation, 15 dépôts et un projet public, la Horae Roadmap. Il a créé 130 tickets : 23 epics, 90 stories, 7 tâches réservées aux humains et 10 risques (les « burning points »), avec des types de tickets (Epic, Story, Risk), des sous-tickets et des liens « bloqué par ».
J’ai lu et validé les tickets avant que la moindre ligne de code existe. C’est la partie que je ne déléguerais jamais : décider ce que veut dire « terminé ».
Chaque story a la même forme : un résumé, des critères d’acceptation, un tableau d’estimation, des instructions pour les agents, et une section Actuals vide à remplir à la fin.
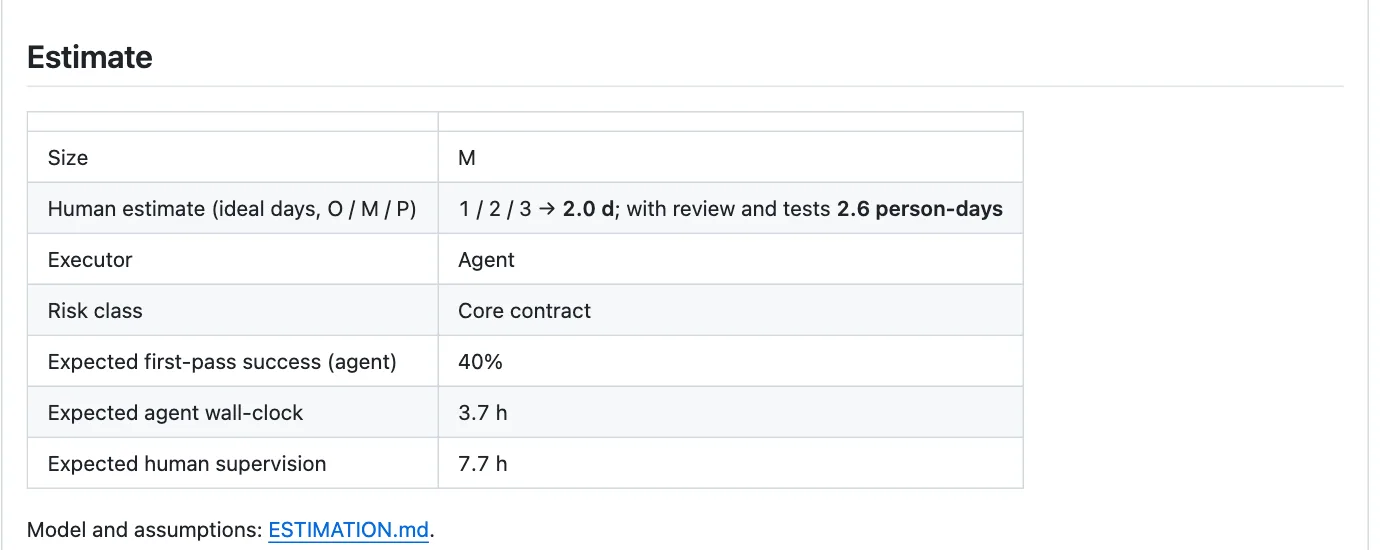
Le projet a des champs personnalisés qui rendent le tableau lisible par les humains comme par les agents :
| Champ | Valeurs | Pourquoi |
|---|---|---|
| Executor | Agent · Agent + human check · Human-led · Human-only | qui fait le travail, pour que les agents sachent quoi laisser de côté |
| Size | XS · S · M · L | pour l’estimation |
| Risk class | Normal · Docs/CI · Core contract · Security · Integration · External API · Design/prompt | la sécurité et les API externes demandent beaucoup plus de supervision |
| Human days, Agent hours, Supervision hours, First-pass % | nombres | les deux estimations, par story et par epic |
Chaque dépôt a aussi un AGENTS.md (installation, commandes, conventions, définition de « terminé ») et une politique graft.yaml qui dit quels chemins demandent ma relecture. Les règles vivent dans le dépôt, pas dans un prompt.
3. Le tableau est l’interface#
La vue tableau a six colonnes. Leurs descriptions comptent, parce qu’elles sont le contrat entre les agents et moi :
| Colonne | Signification |
|---|---|
| Backlog | pas encore prêt |
| Ready | spécification complète, on peut commencer |
| In progress | un agent ou un humain y travaille |
| In review | PR ouverte, relecture par Graft et/ou le mainteneur |
| Human needed | bloqué sur le mainteneur |
| Done | fusionné et accepté |
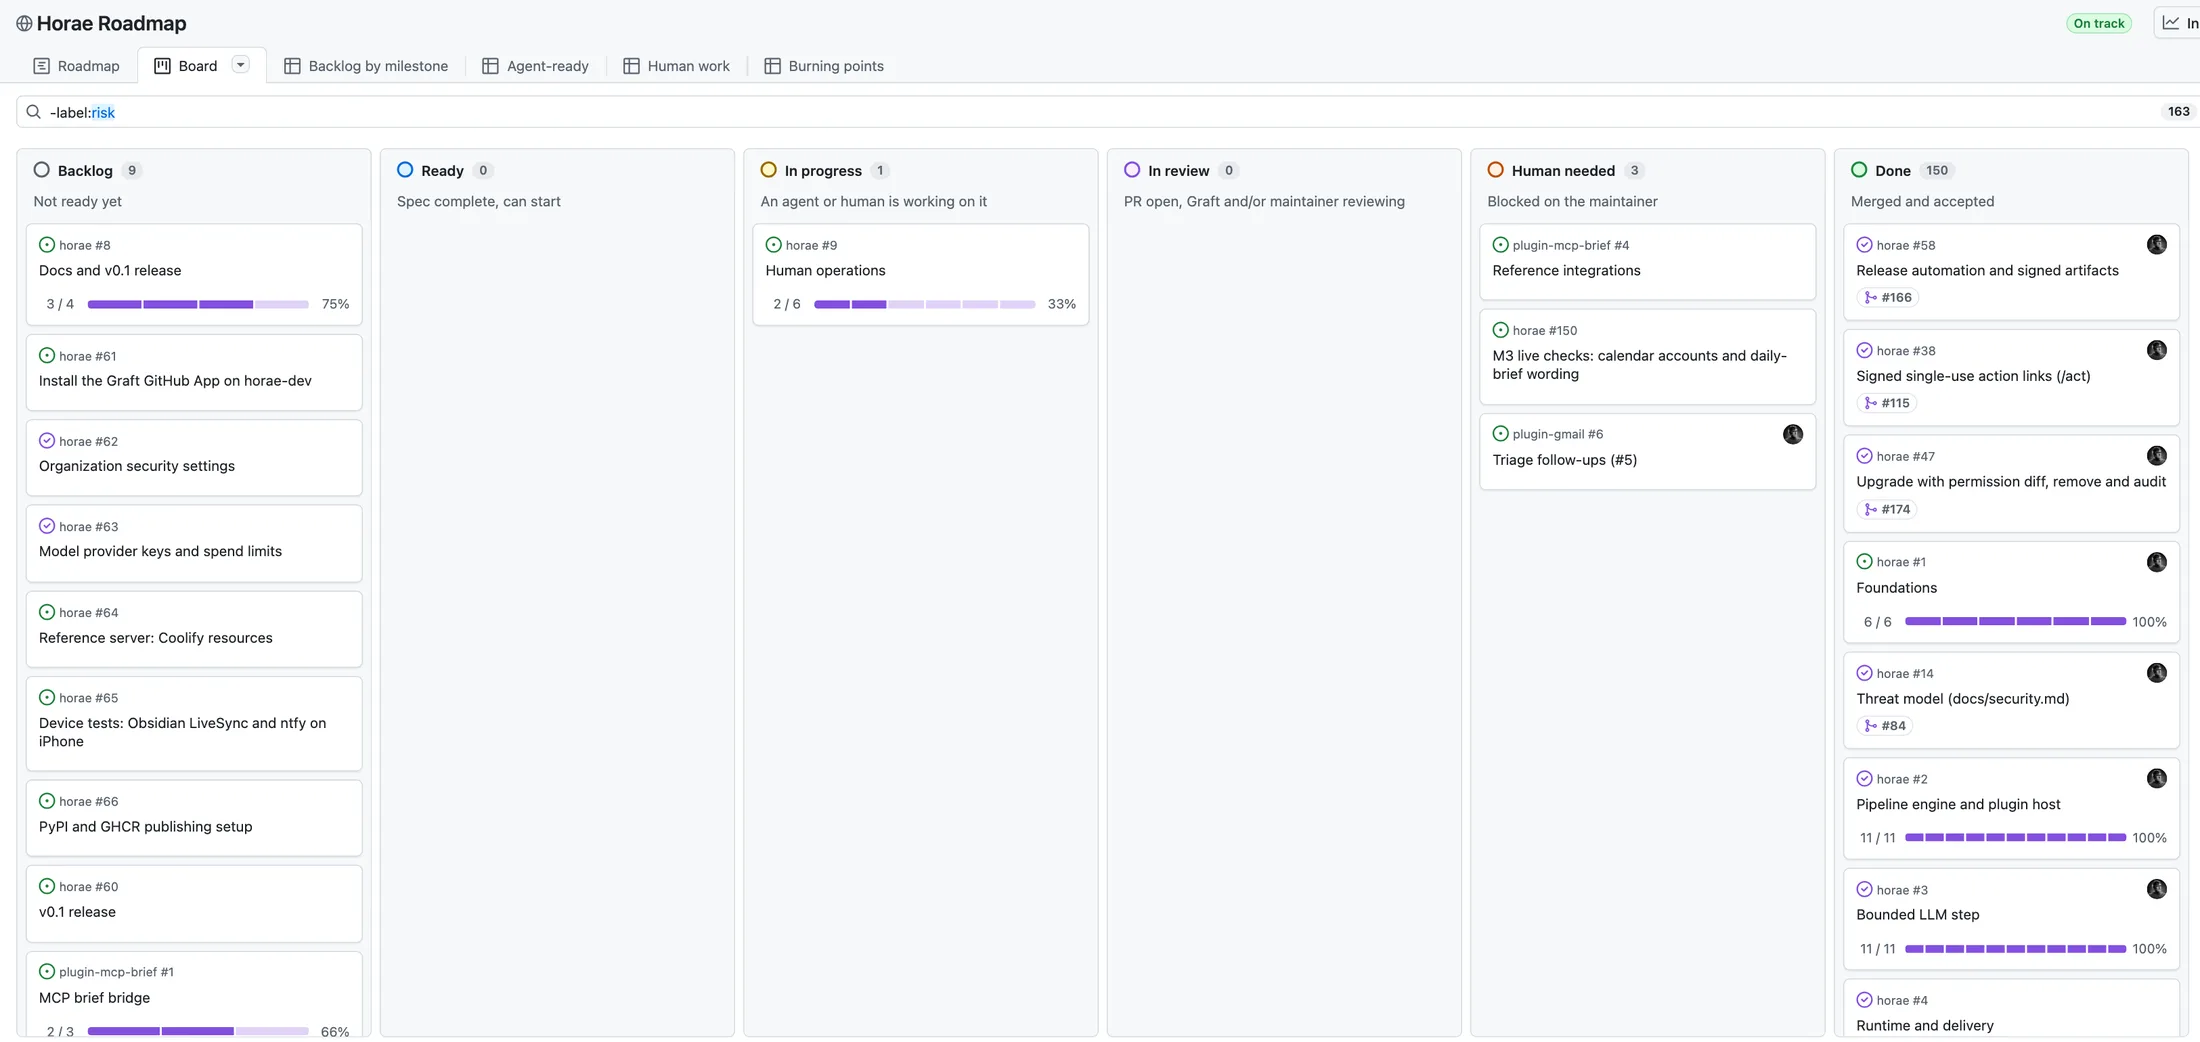
Autour, cinq autres vues : Roadmap, Backlog by milestone (avec les estimations), Agent-ready (filtre label:agent-ready status:Ready : ce qu’un agent peut prendre maintenant), Human work (les éléments Human-led et Human-only, le vrai goulot) et Burning points (les risques).
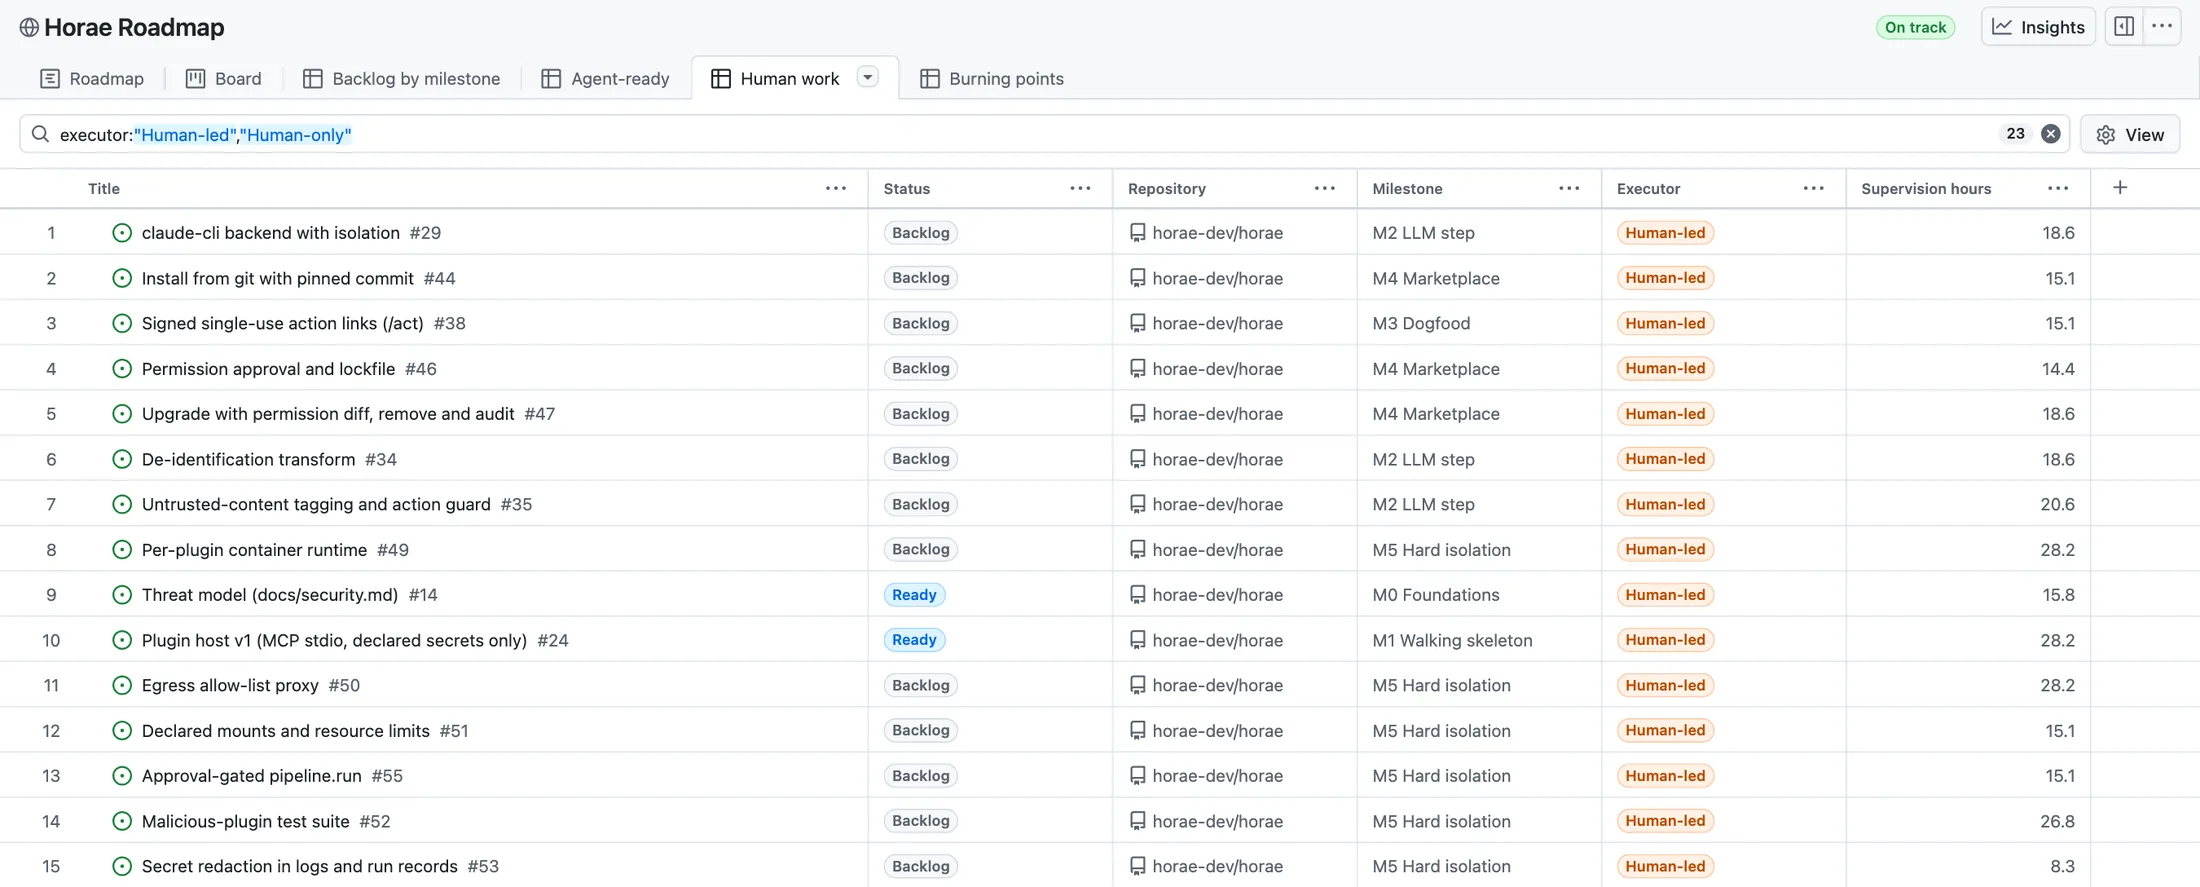
Regardez la colonne Backlog dans le tableau ci-dessus : ce qui reste sur Horae, c’est exactement le travail que je suis seul à pouvoir faire.
4. Une seule consigne : suis le tableau#
Puis j’ai écrit ceci (en anglais, fautes comprises) :
Following the project on github https://github.com/orgs/horae-dev/projects/1/views/3 Start in the right order the epics/issues ready for agents dev. Use the proper workflow with subagents when needed assigning the proper model based on the complexity, make a full review with another agent and fix then all the findings with a third agent. Create the PR referencing the issue, wait for the CI to be green, merge and move on.
Et un second message une minute plus tard : “be sure to assign each task before to start to be able to track the time”.
À partir de là, la session Claude Code principale a piloté le tableau. Pour chaque story Ready, dans l’ordre des dépendances :
- Assigner le ticket (à moi) et le passer en In progress : l’horodatage lance le chronomètre.
- Construire : un sous-agent l’implémente sur une branche
story/<n>-<slug>. L’agent principal choisit le modèle selon la complexité : Sonnet pour l’échafaudage, la CI et le workflow des agents ; Opus pour les JSON Schemas, la validation des intents, les ADR et tout ce qui touche à la sécurité. - Relire : un agent distinct relit le travail au regard des critères d’acceptation, de
PLAN.mdet des stories qui en dépendent. Il ne modifie rien : il reproduit les problèmes dans un clone jetable et écrit ses remarques. Les stories de sécurité ont un relecteur spécialisé en sécurité. - Corriger : un troisième agent corrige toutes les remarques.
- Ouvrir la PR qui référence le ticket, attendre que la CI soit verte, fusionner.
- Publier les Actuals sur le ticket et passer la carte en Done.
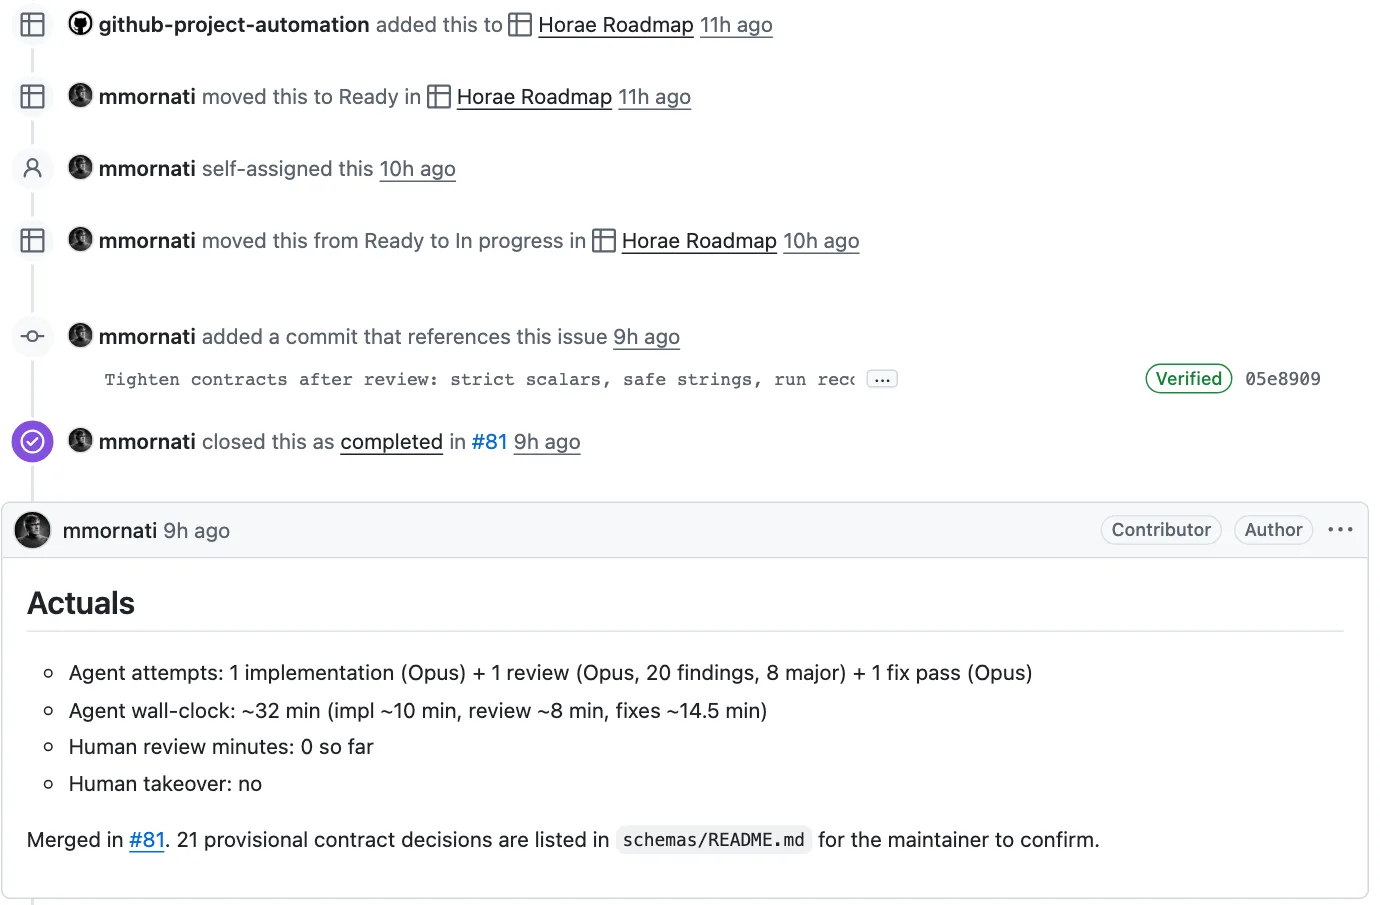
Les cartes dont l’Executor est Human-led sont laissées de côté tant que je n’ai pas pris les décisions. Quand des stories indépendantes sont en Ready, l’agent principal les lance en parallèle, chacune dans son propre worktree git.
Après la première soirée, mes consignes sont devenues encore plus courtes, et toujours un jalon à la fois : “Start M2”, “Can you proceed with the next user stories ready to dev?”, “continue”. Onze jours plus tard, la dernière a été “yes go to complete the full project with the remaining tasks”. Je n’ai jamais demandé tout le backlog d’un coup. Cela s’est révélé important (section 8).
Le tableau a aussi grandi tout seul. Les agents ont ouvert 43 nouveaux tickets sur Horae et 34 sur Angelia : des suites issues des relectures, des stories coupées en deux, des manques dans le cœur découverts en construisant les plugins. Ils sont passés par la même boucle.
Ce que les relecteurs ont trouvé#
C’est la partie qui m’a convaincu que la boucle fonctionne. L’implémenteur disait toujours « tous les contrôles passent ». Le relecteur trouvait presque toujours quelque chose de réel, et souvent de sérieux. Sur les 36 premières stories d’Horae à elles seules, les Actuals recensent plus de 360 remarques de relecture, toutes corrigées avant fusion. Quelques exemples :
- #15 workflow des agents : le hook de commit utilisait le premier
python3du PATH. Avec le Python 3.9 par défaut de macOS, il plantait et bloquait tous les commits, y compris les miens. - #13 schémas (20 remarques, dont 8 majeures) : un chemin de note pouvait sortir du coffre Obsidian vers
.obsidian/plugins(exécution de code sur mon portable),notify.pushacceptait des liensjavascript:, et le lockfile acceptait des URL gitext::. - #18 stockage SQLite : les clés étrangères étaient activées avant les migrations, donc une future reconstruction de table aurait effacé en silence toutes les entrées du journal. Le relecteur a reproduit la perte de données.
- #32 cache : après l’annulation d’une exécution, l’exécution suivante, inchangée, aurait réappliqué les mêmes intents depuis le cache, gratuitement, pendant jusqu’à 7 jours, y compris des intents issus d’une injection de prompt.
- #191 installations tierces : un plugin tiers pouvait déposer un paquet empoisonné dans le cache de téléchargement partagé avec les installations officielles, qu’une compilation ultérieure aurait exécuté sur ma machine, sans que le plugin ait jamais tourné. Le relecteur a reproduit l’attaque de bout en bout.
- #52 suite de plugins malveillants : aucune des 41 attaques n’est passée. Puis un relecteur a désactivé 24 protections une par une pour vérifier que le test correspondant échouait. Cinq tests passaient encore avec leur protection retirée : pour ces garanties, la suite donnait une fausse assurance. Corrigé avant fusion.
Et une que les relecteurs ne pouvaient pas trouver : le backend claude-cli (#29) passait tous les tests avec mocks, mais la première exécution réelle avec mon vrai token a fait échouer quatre tests. Le vrai CLI enveloppe le JSON dans des blocs de code, réfléchit avant de répondre et relance en silence les réponses tronquées jusqu’à trois fois, si bien qu’un appel plafonné à 64 tokens en facturait 256. Les mocks sont d’accord avec vos hypothèses ; la réalité, non. La section 10 en contient bien d’autres.
5. Quand on a besoin d’un humain#
Certaines stories sont à moi par conception : le modèle de menaces, l’hôte de plugins, tout ce où un mauvais choix par défaut devient une faille. Pour celles-là, l’agent ne devine pas. Il écrit une note de conception dans une PR en brouillon, avec des questions numérotées et une recommandation pour chacune, et la carte passe en Human needed.
Le protocole tient en deux étapes :
- Répondre sur la PR, en gardant les numéros des questions. Des réponses courtes suffisent ; « tout comme proposé » aussi.
- Remettre la carte en Ready. C’est le signal. La prochaine fois qu’un agent la prend, il lit mes commentaires, transforme la note en livrable réel et relance la boucle habituelle construire → relire → corriger → fusionner.

Dix questions, dix réponses d’une ligne, une carte remise en Ready. C’est toute l’interface.
Quand PLAN.md était ambigu, les agents ont choisi l’option la plus stricte (assouplir une règle plus tard ne casse rien, la durcir si), l’ont notée comme provisoire et me l’ont listée. À la fin, il y avait plus de 70 décisions numérotées dans le schemas/README.md d’Horae.
Le protocole a changé le treizième jour#
Le 9 novembre, plusieurs cartes m’attendaient sur le tableau, toutes avec du code déjà fusionné et seulement une vérification en conditions réelles à faire. J’ai écrit : “Get for all of them the recommendation you would like to do and move on. Plan the next development phases and go.” L’agent principal les a fermées, a déplacé chaque vérification réelle dans l’un de trois tickets de checklist pour moi, a accepté le modèle de note par défaut comme un choix de conception que je lui avais délégué, a publié un plan pour M4 à M8, et s’est mis à construire.
Il a quand même tracé une limite que je n’avais pas demandée. Les stories qui contrôlent quel code de plugin est installé et exécuté (#44, #46, #47) se sont arrêtées à une PR relue : « Fusionner du code d’installation critique pour la sécurité sans que vous l’ayez regardé, ce n’est pas à moi de le décider. » Dans les deux jours suivants, j’ai approuvé neuf de ces PR : l’installation depuis git, l’approbation des permissions et le lockfile, la mise à jour et l’audit, l’environnement d’exécution en conteneur, l’authentification MCP, le proxy de sortie, les exécutions de pipeline soumises à approbation, les montages et les limites, et les installations tierces.
Voici la partie inconfortable. Certaines de ces approbations m’ont pris quelques minutes : “I’ll review it”, puis “review done, you can proceed” deux minutes plus tard. Un relecteur sécurité indépendant avait déjà parcouru chaque diff, et la PR listait les décisions à vérifier, alors j’ai lu les décisions, pas le code. C’est pour cela que l’organisation est conçue, mais cela veut aussi dire que la barrière humaine ne vaut que l’attention qu’on y met.
6. L’estimation, et pourquoi j’en doutais#
Voici ce que disait le modèle pour Horae, dans son cas probable :
| Équipe humaine | Un humain + 4 agents | |
|---|---|---|
| Effort | 218 jours-personne | 325 heures d’agent + 1 134 h de ma supervision |
| Calendrier | 22 semaines à 3 développeurs · 67 semaines seul | 76 semaines à 15 h/semaine · 38 semaines à plein temps |
Le modèle était soigneux et ses sources étaient bonnes : les horizons temporels de METR, l’étude METR de 2025 où des développeurs expérimentés étaient 19 % plus lents avec l’IA, les rapports de CodeRabbit et de Veracode sur les défauts du code écrit par l’IA. Ses hypothèses principales :
- La réussite au premier essai d’un agent chute vite avec la taille et le risque : 85 % pour une story S, 30 % pour une L, encore divisée par deux pour la sécurité.
- Chaque essai raté coûte une relecture humaine d’environ 15 % de l’effort humain, le double pour la sécurité.
- Après trois échecs, un humain reprend la story à 60 % de l’effort humain.
- Durée d’un agent : 0,75 h pour une story S, 2 h pour une M, 5 h pour une L.
Donc l’essentiel des 1 134 heures, c’était moi, en train de relire des diffs et de sauver des agents. La roadmap construite dessus allait du 2 novembre 2026 au 13 avril 2028.
7. Ce que disent les tableaux#
Horae : terminé en 15 jours#
Sur les 97 stories et tâches du backlog initial d’Horae, 89 sont terminées. Les 8 restantes sont 7 tâches réservées aux humains (comptes, réglages, appareils, la release elle-même) et une intégration qui demande une petite modification dans deux services que je fais tourner. Les agents ont aussi ouvert et fermé 41 tickets à eux en chemin.
| Jalon | Terminées | Prévu (début → cible) |
|---|---|---|
| M0 Fondations | 6 / 8 | nov. 2026 → déc. 2026 |
| M1 Squelette fonctionnel | 11 / 11 | déc. 2026 → févr. 2027 |
| M2 Étape LLM | 12 / 13 | févr. 2027 → avr. 2027 |
| M3 Dogfood | 39 / 42 | avr. 2027 → août 2027 |
| M4 Marketplace | 9 / 9 | août 2027 → oct. 2027 |
| M5 Isolation forte | 7 / 7 | oct. 2027 → janv. 2028 |
| M6 Services MCP existants | 2 / 3 | janv. 2028 → févr. 2028 |
| M7 Mail, école, maison | 10 / 10 | févr. 2028 → mars 2028 |
| M8 v0.1 publique | 3 / 5 | mars 2028 → avr. 2028 |
Tout ce qui reste ouvert est entre les mains d’un humain. La première story a démarré le 27 octobre, et la dernière tâche d’agent a été fusionnée le 11 novembre : 15 jours calendaires, dont 8 pendant lesquels les agents ont réellement tourné. Le plan disait 76 semaines. Même l’équipe de trois développeurs de l’estimation aurait eu besoin d’environ 18 semaines pour ces mêmes 89 stories (183 jours-personne).
Temps d’agent : un tiers à un sixième de l’estimation#
Les deux projets enregistrent la durée des agents dans les Actuals. Voici les stories qui ont à la fois une durée et une estimation :
| Stories chronométrées | Temps d’agent estimé | Temps d’agent mesuré | Rapport | |
|---|---|---|---|---|
| Horae | 42 | 116 h | 39 h | environ 3× moins |
| Angelia | 30 | 106 h | 18 h | environ 6× moins |
Sur Angelia, où le modèle est sur la carte, le schéma est le même à tous les niveaux : une story Opus a pris en moyenne 44 minutes contre 4,2 heures estimées, une story Sonnet 30 minutes contre 2,9 heures, et une story M 34 minutes contre 3,5 heures.
Horae a un trou que j’ai créé moi-même : quand je suis passé à une boucle plus légère pour économiser des tokens (section 8), les Actuals ont continué à dire quel agent et quel modèle avaient fait le travail, mais ont cessé d’enregistrer la durée. Résultat : 88 stories d’Horae n’ont pas de durée mesurée. Si vous copiez cette organisation, protégez la durée dans votre modèle d’Actuals ; c’est la première chose qui disparaît quand on optimise les coûts.
Reprises et supervision#
Aucune reprise humaine, sur les 123 Actuals qui l’enregistrent, sur les deux projets. Le modèle s’attendait à ce que les stories M ratent leur premier essai la plupart du temps et retombent sur moi. Ce n’est pas arrivé : le relecteur a trouvé les problèmes et le correcteur les a corrigés. Un premier essai raté est devenu une itération interne peu coûteuse, pas un sauvetage humain.
Pour les 89 stories d’Horae terminées, l’estimation prévoyait 684 heures de ma supervision, surtout pour relire des diffs. Je n’ai relu presque aucun diff. Pendant ces 15 jours, j’ai envoyé une quarantaine de messages à la session principale, la plupart d’une ligne (“continue”, “Start M2”, “review done, you can proceed”), répondu à sept notes de conception, accepté les ADR et le format des skills, pris une poignée de décisions (“Relax it (option 2)”, “Yes, container only”) et approuvé neuf PR de sécurité. Je ne l’ai pas chronométré, donc je ne vais pas inventer un chiffre, mais on est très loin de 684 heures. Le reste de mon temps est allé en amont, dans les sessions de planification et la validation des tickets, et en aval, dans le déploiement de la section 10.
Pourquoi le modèle se trompait#
Le modèle n’était pas bâclé. Il était construit sur des chiffres de 2025, et il plaçait l’humain au mauvais endroit.
- Les données ont vieilli vite. La mise à jour de METR place le temps de doublement de la longueur des tâches que savent mener les modèles de pointe à environ 89 jours pour les modèles depuis 2024, et Anthropic parle d’un doublement « environ tous les quatre mois, contre tous les sept mois auparavant ». Une estimation faite en octobre à partir d’études du début 2025 est calibrée sur des modèles qui ont deux ou trois doublements de retard.
- Il supposait qu’un humain relit chaque essai. Dans ce workflow, c’est un agent indépendant qui relit, et moi je relis les décisions. C’est aussi la direction que prennent les grandes équipes : Anthropic écrit que « la relecture de code humaine est devenue un nouveau goulot », avec plus de 80 % de son code fusionné désormais écrit par Claude. L’équipe .NET de Microsoft, après dix mois avec l’agent de code Copilot, désigne elle aussi la relecture comme le goulot.
- La « réussite au premier essai » était la mauvaise unité. Elle mesure si le premier diff est fusionnable. Avec un relecteur et un correcteur dans la boucle, ce qui compte, c’est si la boucle converge sans humain. 123 sur 123 l’ont fait.
Ce que le modèle dit encore de juste#
Je ne veux pas remplacer un chiffre faux par un autre, alors voici les limites honnêtes :
- L’essentiel n’a pas encore fait ses preuves à l’usage. Le cœur d’Horae et les plugins Obsidian, calendrier et ntfy tournent maintenant sur mon serveur (section 10). Les plugins mail, école, Home Assistant et Google n’ont jamais touché un vrai compte ; le protocole ÉcoleDirecte a été écrit à partir de documentation communautaire.
- Les défauts ne disparaissent pas. Les études trouvent toujours plus de problèmes dans les PR écrites par l’IA (1,7 fois plus de problèmes majeurs pour CodeRabbit, 44 % des tâches avec une vulnérabilité à risque pour Veracode, plus d’instabilité pour DORA). Mes centaines de remarques disent la même chose : le premier jet est souvent faux. Ce qui a changé, c’est qui le rattrape.
- Le temps en amont et en aval est réel. Écrire et valider les tickets m’a pris plus longtemps qu’il n’en a fallu aux agents pour livrer des jalons entiers. Le déploiement m’a pris deux soirées. L’équipe .NET a vu la partie en amont elle aussi : le taux de réussite de leur agent est passé de 38 % à 69 % après de meilleures instructions, et ils concluent que « la préparation compte plus que le modèle ».
- Le modèle n’a pas chiffré deux nouvelles limites : le quota d’utilisation et la facture de tokens. Section suivante.
L’estimation avait donc raison de dire que je suis le goulot. Elle se trompait sur le genre de travail que j’allais faire. Elle me comptait comme relecteur de code. J’ai travaillé comme product owner, comme architecte qui répond à des questions, comme approbateur, et enfin comme opérateur.
8. Arrêts, quota et facture de tokens#
Voici une chose qu’aucune estimation ne mentionne : le travail s’arrête. Pas parce que quelque chose casse, mais parce que l’humain n’est pas là, ou parce que le quota d’utilisation est épuisé.
Horae a fermé des stories sur 9 jours entre le 27 octobre et le 12 novembre. Entre les deux : les nuits, mes journées de travail, quatre arrêts pour limite d’utilisation, et deux longues pauses, les 30 et 31 octobre et du 2 au 7 novembre. La seconde, c’était le quota hebdomadaire et l’autre projet : du 1er au 7 novembre je faisais tourner Angelia, puis de nouveau Horae à partir du 8 novembre. Deux tableaux partagent un seul humain et un seul quota.
Ce que les arrêts m’ont appris :
- Le tableau est la sauvegarde. Quand tout s’arrête, rien n’est perdu : chaque carte dit où elle en est, chaque PR garde ses questions, chaque story terminée a ses Actuals. Une semaine plus tard, “Continue” a suffi pour reprendre Horae.
- Demander un jalon à la fois, c’est ce qui rend les arrêts peu coûteux. Chaque arrêt est tombé entre deux lots ou au milieu d’un petit lot.
- Un arrêt au milieu d’une story a un coût. Quand une limite d’utilisation tombe, l’agent principal arrête volontairement ses agents en cours au lieu de brûler ce qui reste du quota, et il note où en était chacun (branche, chemin du worktree, ce qui restait à faire). C’est cette note qui rend une reprise possible.
- L’agent principal doit relire le tableau entre les stories. Une fois, j’ai répondu à une note de conception et remis la carte en Ready, et trois heures plus tard l’agent principal la listait encore comme « en attente de vos réponses » : il travaillait à partir de ses propres notes, pas du tableau.
La facture de tokens#
Le 8 novembre, après le troisième arrêt pour limite d’utilisation, j’ai demandé à l’agent principal d’analyser où partaient les tokens. La réponse était claire :
- Trois agents par story (construire, relire, corriger) relisaient chacun l’essentiel des mêmes docs et du même code : environ 600 000 à 1 million de tokens par story.
- Jusqu’à 7 stories en parallèle provoquaient des conflits de fusion et trois collisions sur les numéros de décisions, chacune coûtant des tours supplémentaires.
- Chaque remarque mineure avait droit à une passe de correction, et les petites modifications partaient chez des agents.
La nouvelle « boucle légère » :
- Un seul agent par story par défaut : il implémente, relit son propre diff à l’aide d’une checklist, corrige, ouvre la PR et attend la CI. Sonnet par défaut, Opus pour la sécurité ou le contrat central.
- Un relecteur indépendant seulement pour les stories de sécurité ou de contrat central, limité au diff, qui remonte les remarques élevées et moyennes, et les corrige lui-même.
- Les remarques mineures deviennent des tickets de suivi.
- Au plus deux stories en cours.
- L’agent principal fait lui-même les fusions, les renumérotations et les petites modifications.
Les trois stories suivantes ont utilisé environ 80 000, 108 000 et 220 000 tokens. C’est trois à dix fois moins cher, et c’est la boucle qui a terminé M3 à M7. Le travail de sécurité a gardé son relecteur indépendant, et c’est de là que viennent les remarques sérieuses de la section 4. Le prix à payer, ce sont les données de durée, comme je l’ai dit plus haut.
9. Un second tableau : Angelia#
Le 30 octobre, j’ai demandé à Claude de reprendre ce que nous avions fait sur horae-dev et de construire “a full board agent + human development oriented to work together”, où les agents décident quand un humain est nécessaire et où le modèle est choisi selon la complexité. En environ 45 minutes, il a mis en place cinq dépôts et 129 tickets sur l’Angelia Roadmap.

C’est similaire à Horae, mais pas identique :
| Horae | Angelia | |
|---|---|---|
| Dépôts | 15 | 5 |
| Tickets au départ | 130 | 129 |
| Choix du modèle | l’agent principal choisit story par story | un champ Complexity pilote un champ Model sur chaque carte : Low → Haiku, Medium → Sonnet, High et Very high → Opus ; je peux le modifier |
| Quand demander à un humain | le champ Executor, plus le jugement de l’agent | des déclencheurs explicites dans AGENTS.md : un contrat public, un choix de sécurité, une nouvelle dépendance, une spécification ambiguë, ou le même contrôle de CI qui échoue trois fois |
| Escalade | rien d’écrit | trois échecs de CI ou deux fois le temps estimé → un nouvel essai avec le modèle au-dessus → puis un humain |
| Niveau de détail des spécifications | chaque story détaillée dès le départ | Phases 0 et 1 détaillées (agent-ready) ; les Phases 2 et 3 sont 27 ébauches (needs-spec), détaillées juste avant de démarrer |
| Première phase | les fondations | un spike avec des benchmarks et un go/no-go humain |
| Où tournent les agents | une session Claude Code locale | un fil coordinateur et des agents dans le cloud ; mon Mac pour les écritures sur le tableau et les benchmarks |
| Vues | 6 | 8, avec en plus un tableau Human needed et un Model planner |
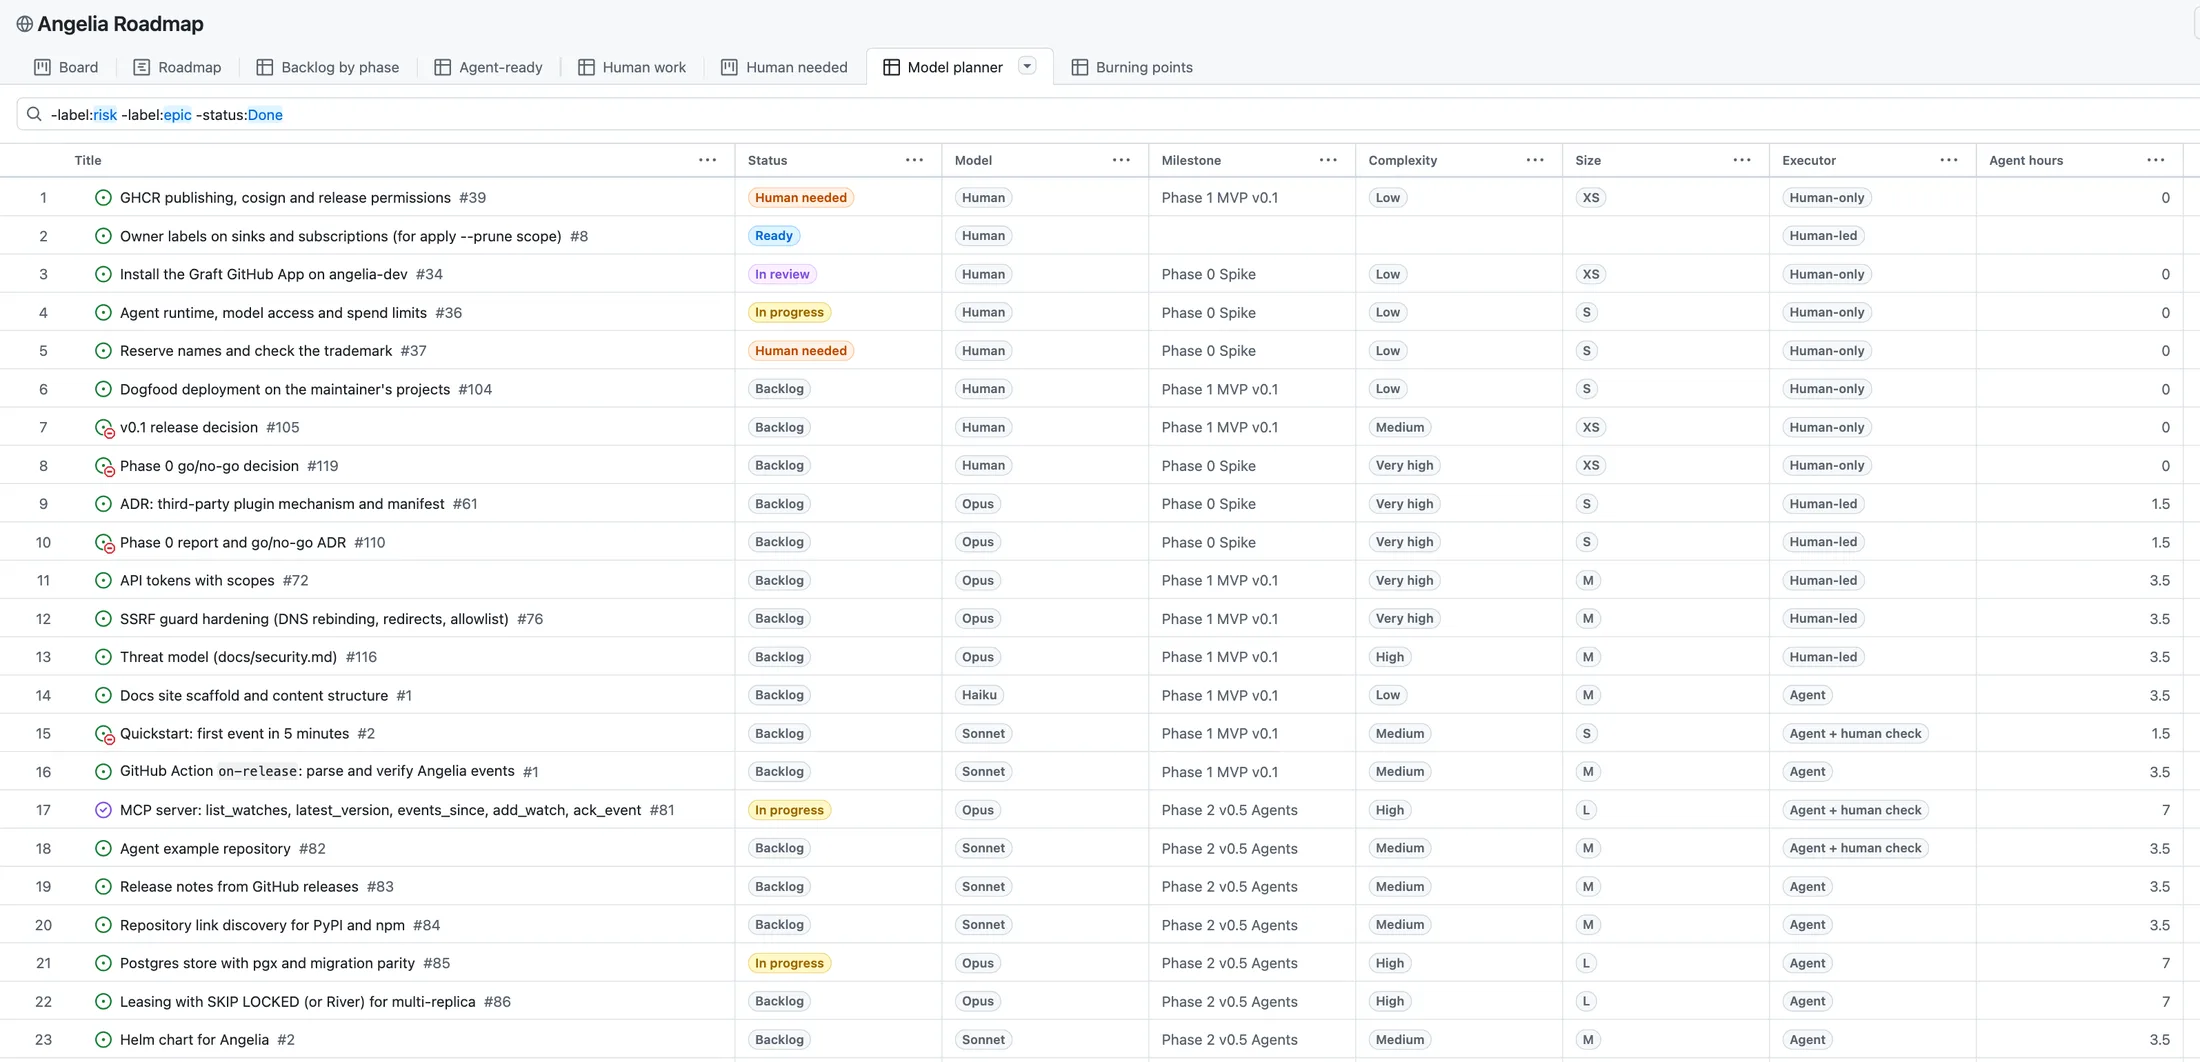
Ce qui s’est passé#
Angelia a démarré le 1er novembre avec un seul message : regarde le tableau, agis comme coordinateur, construis chaque story Ready avec le modèle indiqué sur sa carte, fais relire par un autre agent, corrige, et fusionne quand la CI est verte. 35 stories fermées ce premier jour. Au 13 novembre :
- 83 stories terminées : 55 des 95 du backlog initial, plus 28 ajoutées par les agents. La Phase 0 en est à 32 sur 38, la Phase 1 à 21 sur 30, et la Phase 2 a démarré.
- Releases : v0.1.0 taguée le 10 novembre et v0.1.2 publiée le 12 novembre. La roadmap prévoyait le MVP v0.1 pour mars 2027.
- Des benchmarks sur du vrai matériel : les benchmarks du spike ont tourné sur mon Mac, dont un qui surveille 2 000 dépôts GitHub avec un seul token. Une exécution réelle de 6,5 heures a été interrompue par un redémarrage de Claude Code et a produit un rapport partiel.
Et trois choses ne se sont pas passées comme prévu :
- Le tableau a dérivé. Le coordinateur ne pouvait pas écrire lui-même dans le projet, alors il a relayé 64 demandes de mise à jour du tableau à une session d’appoint sur mon Mac. Le 3 novembre, j’ai écrit : “there is nothing on the board to approve. Where the PR/Issues concerned are?” La correction a été de mettre chaque PR sur le tableau comme carte à part entière, c’est pourquoi la colonne Done compte tickets et PR. L’agent qui fait le travail doit pouvoir mettre à jour le tableau directement, sinon le tableau cesse d’être la vérité.
- La release est arrivée avant le go/no-go. La v0.1 est sortie, mais le rapport de la Phase 0 et la décision go/no-go (#110, #119) sont encore en Backlog. Les agents sont allés plus vite que ma paperasse ; la décision formelle doit rattraper son retard.
- L’estimation n’a pas été recalibrée. La grille d’Angelia dit toujours qu’une story M prend 3,5 heures d’agent. Elle a pris 34 minutes en moyenne. Les données d’Horae étaient là ; j’aurais dû les injecter.
Les spécifications juste à temps ont fonctionné comme prévu : les ébauches des phases ultérieures ne sont détaillées que maintenant, après que le spike a répondu aux grandes questions. Et le modèle sur la carte a rendu le coût visible avant chaque exécution : parmi les stories chronométrées, 15 ont tourné sur Opus, 14 sur Sonnet et 1 sur Haiku.
10. Le dernier kilomètre est humain#
Le 12 novembre, j’ai demandé à l’agent principal d’Horae : “What is the status of the horae-dev project? Are we able to finish and start to test?” Il a fait tourner Horae en local sur une copie neuve en quelques minutes. Puis je lui ai demandé de le déployer sur mon serveur à la maison, où Coolify, authentik, un tunnel Cloudflare, ntfy et Uptime Kuma tournaient déjà.
Cela a pris deux soirées, et c’est là que la CI verte a rencontré la réalité :
- L’image de conteneur sur GHCR était privée, donc le serveur ne pouvait pas la récupérer. GitHub n’a pas d’API pour changer cela ; j’ai dû cliquer moi-même.
- Cloudflare bloquait le contrôle de santé de l’assistant LiveSync parce qu’il s’identifiait comme
Python-urllib, et l’assistant interprétait le 403 comme de mauvais identifiants. - Coolify a créé un fichier de configuration monté vide et en lecture seule.
- La base LiveSync était verrouillée sur mes deux appareils, donc le serveur était refusé comme nouvel appareil.
- Toutes les installations de plugins échouaient : les plugins prenaient le SDK depuis un commit git, et l’installateur d’Horae refuse à juste titre les sources sans hash. La correction a été de publier le SDK sur PyPI, ce qui m’a demandé de configurer le trusted publisher.
- Les packs ne pouvaient pas du tout être installés : l’installateur essayait de construire un environnement Python pour un plugin qui ne livre que des fichiers. C’était un vrai bug, corrigé dans #201.
- Mon Obsidian sur ordinateur a cessé de se synchroniser à cause d’un problème DNS sur le Mac.
Chacun de ces problèmes a pris quelques minutes à un agent pour être diagnostiqué, une fois ma part faite : me connecter à Coolify et authentik dans le panneau de navigateur, taper les secrets, ajouter le nom d’hôte du tunnel, configurer PyPI, déverrouiller des choses dans Obsidian, coller des commandes dans le terminal du conteneur, et regarder mon téléphone.
À 21:24 le 13 novembre, j’ai écrit deux mots dans la session : “Phone rang.” Une tâche que j’avais écrite dans Obsidian sur mon ordinateur s’était synchronisée sur le serveur, Horae l’avait trouvée, et ntfy avait envoyé le rappel sur mon iPhone. Le brief du matin est le prochain, en attente de #201.
Les agents ont fait des semaines de travail en quelques jours. Le premier vrai déploiement a quand même eu besoin d’un humain pour chaque compte, secret, réglage et appareil, et il a trouvé des bugs qu’aucune relecture et aucune exécution de CI n’avaient vus.
11. Équipe à deux pizzas ou équipe sandwich ?#
L’estimation comparait « un humain + des agents » à « trois développeurs ». Je pense que la comparaison la plus intéressante porte sur la forme de l’équipe.
L’équipe à deux pizzas d’Amazon (assez petite pour être nourrie avec deux pizzas, soit six à dix personnes) a été pensée pour limiter la coordination. Même ainsi, huit personnes ont 28 canaux de communication entre elles (n(n−1)/2). Matt Ström-Awn écrit que l’idée s’est transformée en « équipes à deux sandwichs » : « le même principe, mais avec une équipe de deux personnes ». En juillet, Business Insider a recueilli le même signal chez des dirigeants de la tech : le field CTO de Cursor estime que « deux pizzas, c’est trop de pizza », le PDG de Coinbase parle d’« équipes d’une personne ».
Un tableau comme celui-ci est un moyeu, pas un maillage. Un humain parle à un agent principal, l’agent principal parle aux agents de travail, et ceux-ci ne se parlent jamais entre eux. Avec quatre agents, cela fait quatre canaux, pas 28. Ce n’est pas un détail : la recherche sur la coopération entre agents trouve que des agents qui se coordonnent entre eux font nettement moins bien qu’un agent seul, donc le moyeu est aussi la bonne forme pour les agents. L’analyse des tokens d’Horae dit la même chose du côté des coûts : plus d’agents en parallèle, c’était plus de conflits, pas plus de vitesse.
Ce que j’en retiens :
- L’unité de débit, ce sont maintenant les décisions par jour, pas les lignes de code par jour. La capacité de décision d’une personne est le plafond, et il y a désormais un second plafond : le quota d’utilisation.
- Une équipe à deux pizzas devient plusieurs équipes sandwich, chacune responsable d’un produit avec son propre tableau. C’est littéralement ce que j’ai fait avec Horae et Angelia : deux tableaux, un humain, chacun avec ses propres agents. Mais ils ne tournent pas en parallèle comme deux équipes le feraient : ils partagent mon attention et mon quota, alors en pratique j’ai alterné.
- Une équipe sandwich de deux personnes est probablement le bon équilibre. Deux personnes doublent la capacité de décision pour un seul canal de plus, le tableau continue d’avancer quand l’une des deux est occupée, et une seconde personne rend les approbations de sécurité de la section 5 beaucoup moins formelles.
- Les équipes à deux pizzas gagnent encore là où le travail est irréductiblement humain et parallèle : revues de sécurité, astreintes, connaissance du métier, échanges avec les utilisateurs, déploiements sur une vraie infrastructure, et le facteur bus. Une équipe sandwich avec des agents a un facteur bus de un ou deux.
L’étude de terrain de Microsoft sur Claude Code et Copilot CLI a mesuré environ 24 % de PR fusionnées en plus chez les adoptants, dans une organisation qui a gardé la forme de ses équipes. C’est un vrai gain, mais rien à voir avec ce qu’on observe quand le processus est reconstruit autour des agents. Je soupçonne que l’essentiel de la différence tient à la forme de l’équipe et au processus, pas au modèle.
12. Le mettre en place chez vous#
Si vous voulez essayer sur votre propre projet, voici le minimum qui l’a fait fonctionner, avec ce qu’Angelia et la facture de tokens ont ajouté :
- Écrivez le backlog avec l’agent, validez-le vous-même. Des critères d’acceptation sur chaque story. Ne détaillez que la prochaine phase ou les deux suivantes ; gardez le reste sous forme d’ébauches.
- Ajoutez un champ Executor (Agent, Agent + human check, Human-led, Human-only) et une vue Agent-ready. Les agents doivent savoir quoi laisser de côté.
- Mettez le modèle sur la carte : un champ Complexity et un Model suggéré que vous pouvez modifier.
- Décrivez les colonnes. « Ready = spécification complète », « Human needed = bloqué sur le mainteneur ». Les descriptions sont le protocole.
- Écrivez quand un agent doit s’arrêter et demander : contrats publics, choix de sécurité, nouvelles dépendances, spécifications ambiguës, échecs de CI répétés.
- Mettez une estimation et une section Actuals dans chaque story, et faites de la durée une ligne obligatoire. Recalibrez après 15 stories, et reportez le calibrage sur votre projet suivant.
- Commencez avec un seul agent par story et une auto-relecture sur checklist ; ajoutez un relecteur indépendant pour la sécurité et les contrats publics. Celui qui écrit n’approuve jamais ceux-là.
- Faites de la CI la porte d’entrée, et gardez au plus deux stories en cours.
- Mettez-vous d’accord sur le protocole Human needed : questions numérotées dans la PR, réponses sur la PR, carte remise en Ready. Faites en sorte que l’agent principal relise le tableau entre les stories, et laissez-le mettre à jour le tableau lui-même.
- Demandez un jalon à la fois, et attendez-vous à des arrêts.
- Déployez tôt. Une vraie instance sur une vraie infrastructure trouve ce que les relectures et la CI ne trouvent pas, et elle a besoin de vous.
13. Pour conclure#
L’estimation disait que je serais le goulot, et je le suis. Mais les heures que j’y passe ne sont pas dans les diffs. Elles sont dans les tickets, avant que le code existe, dans les questions auxquelles les agents ne peuvent pas, et ne doivent pas, répondre, dans la décision d’appuyer sur « continue », et dans les comptes, les secrets et les appareils du premier vrai déploiement. Tout ce qui se passe entre ces moments prend désormais quelques minutes, ou quelques jours pour un projet entier.
Écrivez bien vos tickets. Laissez le tableau piloter. Gardez les décisions humaines.
Liens#
- 🗂️ Horae Roadmap : le tableau public, avec toutes ses vues
- 📦 horae-dev/horae : le code,
docs/ESTIMATION.mdetdocs/ROADMAP.md - 🗂️ Angelia Roadmap et angelia-dev/angelia : le second tableau, avec
docs/ESTIMATION.md,AGENTS.mdet la release v0.1.2 - 🎬 La vidéo en pleine page, faite avec canvas-video-skill
- 📖 Six semaines en une nuit : l’expérience précédente, avec Graft
Sources : METR, Time Horizon 1.1 (janv. 2026) · METR, uplift update (févr. 2026) · Anthropic, When AI builds itself (mis à jour en sept. 2026) · Murphy-Hill, Butler et Savelieva, les agents de code en ligne de commande chez Microsoft (juil. 2026) · Équipe .NET, dix mois avec l’agent de code Copilot (mars 2026) · CodeRabbit, code IA contre code humain (déc. 2025) · Rapport GenAI 2026 de Veracode · Matt Ström-Awn, High-agency strategy · Business Insider, la fin des équipes à deux pizzas (juil. 2026) · Résultats de CooperBench