J’ai demandé à un agent de bloquer deux heures de concentration dans mon agenda pour demain. Ça a marché. Il lui a fallu 4 tours, 114 000 tokens, 14 secondes et 0,19 $. Puis j’ai redemandé, avec exactement les mêmes mots et le même agenda, et il a réservé un autre créneau. Trois exécutions, trois réponses : 13:00, 14:00, 13:00.
Le script que le même agent a écrit pour la même tâche réserve 12:30. À chaque fois. Gratuitement.
Cet article parle de cette différence. Pas de « l’IA, c’est mal » (je l’utilise tous les jours et la plupart de mes projets récents ont été écrits avec Claude Code), mais d’une habitude que je vois grandir autour de moi, et chez moi : nous remplaçons une automatisation bon marché, déterministe et écrite une seule fois par des conversations chères, non déterministes et payées à chaque fois. La meilleure approche, c’est d’utiliser l’IA pour construire l’automatisation, puis de la sortir de la boucle.
1. De « fais-le » à « demande à un agent de le faire »#
Pendant longtemps, le travail répétitif passait par trois étapes. D’abord on clique. Puis, quand on a cliqué assez de fois sur la même chose, on écrit un script, un tableau de bord, un cron, une petite application. Le script est ennuyeux, il fait une seule chose, et il ne coûte rien à exécuter.
Il y a maintenant une troisième option, et elle est très tentante : on demande. « Trouve un créneau pour nous six la semaine prochaine. » « Comment ça s’est passé hier ? » « Bloque-moi deux heures demain. » L’agent lit les agendas, interroge la base de données, fait les calculs et vous écrit un joli paragraphe.
C’est dans cette direction que pousse le secteur. Dans une enquête de l’IEEE publiée en novembre 2025, 52 % des responsables technologiques s’attendaient à ce que l’IA agentique atteigne une adoption grand public, ou presque, en 2026 comme « assistant personnel, planificateur ou gestionnaire d’agenda familial », en tête de liste. C’est une prévision, pas un usage mesuré, mais elle dit où va l’argent. Google a ajouté à Calendar des suggestions d’horaires de réunion par Gemini, alors que la simple grille « Trouver un créneau » faisait déjà l’essentiel du travail.
Rien de mal à tout ça pour une question ponctuelle. Le problème commence quand la même question revient chaque matin.
2. La facture : des tokens moins chers, des factures plus grosses#
Le prix des tokens baisse chaque année. Les factures, non. Une tâche agentique demande de nombreux appels au modèle là où un chat en demande un seul, et chaque tour renvoie un contexte qui grossit. Des fournisseurs estiment 10 à 30 appels par tâche, que les boucles et les nouvelles tentatives multiplient encore (estimations de fournisseurs, mais mes propres mesures plus bas arrivent au même endroit).
Certaines entreprises l’ont découvert à leurs dépens en 2026 :
- Uber. En avril, The Information a rapporté que le CTO, Praveen Neppalli Naga, avait déclaré que le budget IA de toute l’année était épuisé quelques mois après son début : « the budget I thought I would need is blown away already ». Le montant n’a jamais été communiqué. En juin, Bloomberg a rapporté, avec la confirmation d’un porte-parole, un plafond de 1 500 $ par mois de tokens par outil de code agentique et par employé, avec la possibilité de demander davantage.
- Le tokenmaxxing. Meta avait un classement interne de la consommation de tokens (« Claudeonomics »), avec plus de 85 000 employés et environ 60 000 milliards de tokens en 30 jours. Certains laissaient tourner des agents pendant des heures pour grimper. Il a été fermé en quelques jours (Meta a invoqué des fuites de données vers l’extérieur, pas la triche). Chez Amazon, un classement non officiel a été mis hors ligne et l’entreprise a précisé que le nombre de tokens ne compterait pas dans les évaluations. Salesforce n’avait pas de classement, mais a fixé des objectifs minimums de dépense hebdomadaire sur Claude Code et Cursor, avant de critiquer publiquement le tokenmaxxing.
- Le problème de la mesure. Dans le LeadDev AI Impact Report 2026, 58 % des répondants disent que leur organisation mesure l’impact de l’IA par la consommation de tokens, et 57 % disent que cette mesure ne fonctionne pas. Seuls 19 % pensent que le tokenmaxxing est efficace.
Quand l’indicateur est « les tokens dépensés », poser la même question tous les jours ressemble à de la productivité.
3. L’autre facture : nous#
Il y a un second coût, plus difficile à mesurer, et je veux être prudent parce qu’il est facile de l’exagérer.
Une étude de Microsoft Research et Carnegie Mellon (CHI 2025, 319 travailleurs du savoir, 936 exemples réels) a constaté que, dans la plupart des exemples, les personnes avaient le sentiment que l’IA générative réduisait l’effort de réflexion critique, et qu’une plus grande confiance dans l’IA était associée à moins de réflexion critique. Tout est déclaratif. (Vous verrez circuler un chiffre de « 62 % ». Il n’est pas dans l’article.) L’étude du MIT Media Lab « Your Brain on ChatGPT » parle de « dette cognitive » à partir d’EEG sur 54 participants, mais c’est une prépublication et seules 18 personnes ont fait la dernière session.
Je ne construis donc pas l’argument là-dessus. Mais je reconnais la sensation : quand la réponse est à un prompt de distance, je ne sais plus comment le chiffre est calculé. Un script que vous avez écrit (ou relu) est une définition que vous comprenez. Un paragraphe qui change chaque matin, non.
4. Je l’ai mesuré#
Je n’ai trouvé personne qui ait chiffré « poser la même question tous les jours ». Il y a de bons articles d’opinion : TechTarget sur pourquoi un tableau de bord parcouru en 30 secondes vaut mieux qu’un chat, incident.io sur un LLM qui « fait une supposition » sur la définition de vos indicateurs et donne un chiffre différent selon les jours. Mais pas de mesures. Alors j’en ai fait.
Le dispositif#
Trois tâches du quotidien, avec des données de test générées (aucun vrai agenda, aucune donnée d’entreprise) :
- Bloqueur de concentration. « Bloque 2 heures de concentration demain. » Un agenda, des heures de travail, des réunions existantes.
- Question KPI. « Comment ça s’est passé hier ? » Une base SQLite avec 90 jours de commandes, d’inscriptions et d’incidents, où hier a été une mauvaise journée, exprès.
- Recherche de créneau. Six personnes sur quatre fuseaux horaires, deux semaines de réunions, et le changement d’heure du 25 octobre au milieu.
Chaque tâche est passée par claude -p --output-format json (Claude Code 2.1.284, Claude Sonnet 5.5) dans un espace de travail propre et vide, avec seulement les données de test, de trois façons :
- ask : l’agent fait la tâche, comme vous le feriez chaque matin ;
- build : l’agent écrit un script pour la tâche, une seule fois ;
- residual : le petit appel au modèle qui reste après le script, s’il y en a un. Pour le tableau KPI, un prompt d’environ 100 tokens seulement quand un indicateur sort de 3σ. Pour la recherche de créneau, un appel pour peser les préférences souples (« Chen préfère le matin »).
14 exécutions au total, 1,52 $ au prix catalogue.
Les chiffres#
| Tâche | Demander à l’agent, par exécution (cache froid) | Lui faire écrire le script, une fois | Ce qui reste pour un modèle ensuite |
|---|---|---|---|
| Bloquer 2 h de concentration | 0,185 $, 114k tokens, 4 tours, 14 s | environ 0,23 $ | rien |
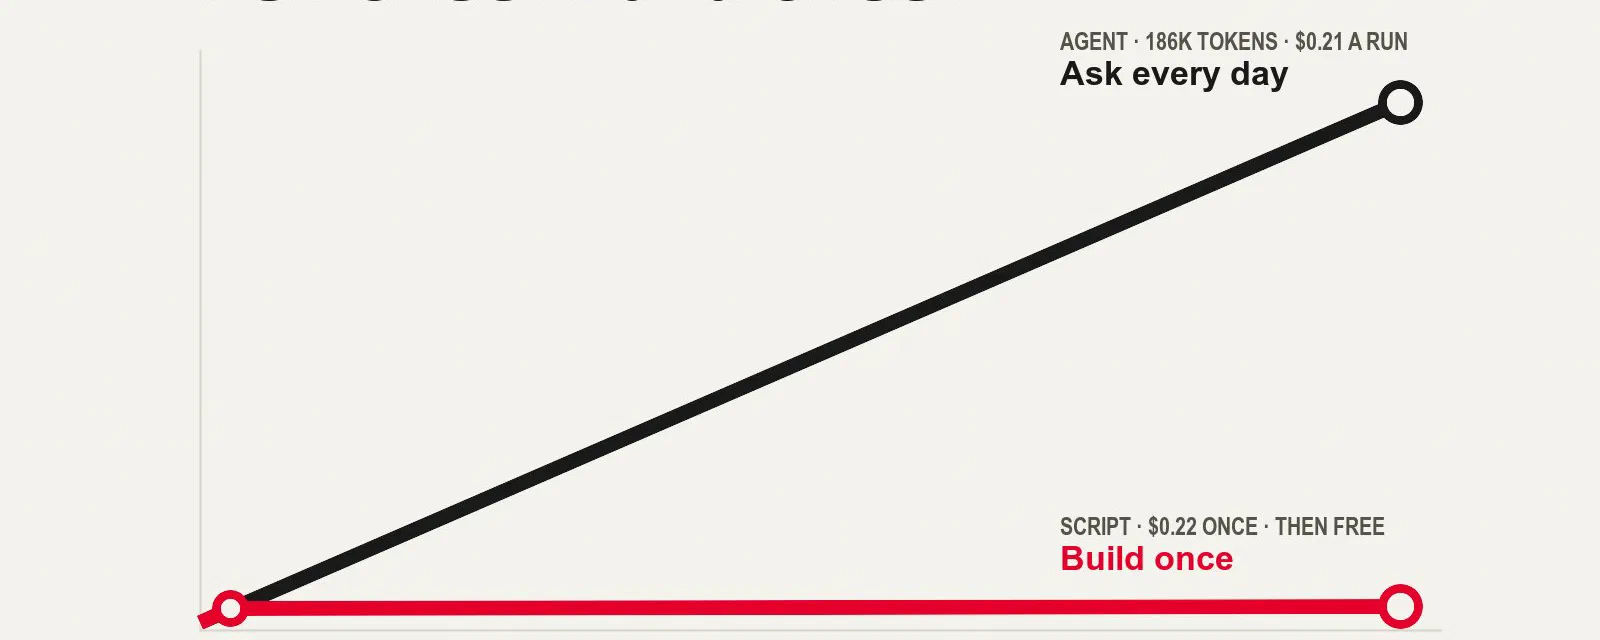
| « Comment ça s’est passé hier ? » | 0,208 $, 186k tokens, 5–6 tours, 24 s | environ 0,22 $ | 0,013 $ (3k tokens), seulement les jours d’anomalie |
| 6 personnes, 4 fuseaux, trouver un créneau | 0,254 $, 266k tokens, 7–8 tours, 38 s | environ 0,22 $ | 0,022 $ (4k tokens) par réunion |
Les « tokens de contexte » sont l’entrée plus les lectures de cache : ce que le modèle traite réellement. « Froid » veut dire la première exécution de l’heure, qui doit écrire environ 32k tokens de contexte Claude Code dans le cache de prompt. Une question posée une fois par jour paie le prix froid chaque jour. Répétée dans l’heure, la même question coûte environ trois fois moins (0,06 à 0,12 $), mais ce n’est pas comme ça que fonctionne une question quotidienne.
Ce que je retiens de ce tableau :
1. Construire coûte à peu près une question. Écrire le script a coûté 0,22 à 0,23 $, autant que de poser la question une fois. Dès le deuxième jour, le script est gagnant. Il n’y a pas de « ça ne vaut pas la peine d’automatiser » pour une tâche quotidienne.
2. Les réponses changent. C’est la surprise. Les trois exécutions identiques du bloqueur ont réservé 13:00, 14:00 et 13:00. Le script réserve 12:30 à chaque fois. Les trois exécutions de « comment ça s’est passé hier ? » ont chacune choisi leur propre titre : « les commandes payées ont baissé d’environ moitié », « commandes en baisse d’environ 37 % », « environ 40 % sous la normale ». Les trois se défendent. Aucune n’est la même. Et les trois ont rapporté un chiffre d’affaires incluant les commandes échouées (2 879 €), là où le tableau de bord rapporte le chiffre d’affaires payé (2 159 €). C’est le « chiffre différent selon les jours » d’incident.io, mesuré.
3. L’agent avait raison sur la tâche difficile. Je veux être juste. Les trois exécutions de recherche de créneau ont trouvé les six mêmes créneaux valides que le script, malgré le changement d’heure. L’agent ne se trompe pas. Il est juste 12 fois plus cher que le script plus un petit appel, et il paie ce prix à chaque fois.
4. L’essentiel de la facture, c’est le harnais. Envoyer « réponds ok » à Claude Code avec ses outils activés coûte 34 499 tokens de contexte (0,138 $ sur Sonnet). C’est le prompt système, les définitions des outils, l’environnement. Mes appels résiduels, outils désactivés (--tools ""), coûtent 3 000 à 4 000 tokens. Quand vous « demandez simplement » à un agent, l’essentiel de ce que vous payez n’est pas votre question. (J’ai déjà écrit sur ce coût fixe, pour les serveurs MCP et MCP face à une CLI : une CLI que le modèle connaît déjà coûte 0 token de schéma, un serveur MCP natif environ 3 000 par prompt.)
5. Relisez ce qu’il construit. Le script de recherche de créneau écrit par l’agent a trouvé sept créneaux, pas six : il avance par pas de 15 minutes au lieu de 30. Pas un bug, un autre choix. Mais c’est exactement pour ça qu’on relit le script une fois. Vous le relisez une fois, au lieu de faire confiance à un nouveau paragraphe chaque matin.
Sur un an#
Prenons la question KPI, posée par une équipe de 20 personnes chaque jour ouvré. Ça fait 4 400 exécutions par an. En tokens seulement, sur Sonnet, demander coûte environ 850 $. Le tableau de bord plus les appels sur anomalie coûtent environ 0,36 $.
Mais les tokens ne sont pas le vrai coût, alors comptons les personnes à 60 $ de l’heure (mon estimation, changez-la). Le tableau demande environ une heure de relecture et deux heures de maintenance par an : environ 180 $. Demander, une fois comptées les 25 secondes que chacun attend la réponse, monte à environ 2 700 $. Ce sont mes calculs à partir des exécutions mesurées, pas des mesures sur une vraie équipe.
J’ai fait un petit calculateur pour que vous puissiez mettre vos propres chiffres : Ask once or build once? Le calculateur (en anglais). Les préréglages sont les exécutions mesurées ci-dessus. Changez la taille de l’équipe, le modèle, le taux horaire, et cochez « count waiting and review time » pour voir où les deux courbes se croisent.
5. Là où l’IA mérite ses tokens#
Rien de tout ça ne veut dire « arrêtez de demander ». Certaines tâches méritent un agent à chaque fois :
- Nouvelles : vous ne l’avez jamais fait, et vous ne le referez pas. Lire 40 contrats une fois pour trouver la clause inhabituelle.
- Désordonnées : les entrées changent de forme à chaque fois. Une cause racine à travers trois systèmes que vous n’avez jamais corrélés.
- Exploratoires : le premier regard sur un jeu de données, avant de savoir quelle est la bonne question.
- Du jugement en prose : expliquer une anomalie à un humain, peser « Chen préfère le matin » contre « Dana est en congé vendredi ».
La recherche de créneau est l’exemple honnête. L’agent a eu juste, les trois fois. La question n’est pas de savoir s’il en est capable, mais s’il doit le faire à chaque fois. Les fuseaux horaires, les disponibilités et les heures de travail, c’est de l’arithmétique. Les préférences souples, c’est du jugement. Séparez-les, et le modèle ne reçoit que les 4 000 tokens dont il a besoin.
6. Le geste qui manque : utiliser l’IA pour sortir l’IA de la boucle#
C’est l’habitude que j’essaie de prendre : quand je remarque que je pose de nouveau la même question, je demande à l’agent une dernière fois, mais le script.
C’est aussi ce que découvrent ceux qui construisent ces outils :
- Dans « Code execution with MCP », Anthropic montre qu’en laissant l’agent écrire du code qui utilise les outils, au lieu de les appeler un par un, un workflow est passé de 150 000 tokens à 2 000, soit 98,7 % d’économie.
- Le « Code Mode » de Cloudflare expose toute son API en deux outils et environ 1 000 tokens, contre 1,17 million pour un serveur MCP classique équivalent.
- Tomasz Tunguz écrit que 65 % des nœuds des workflows de son agent tournent en code sans IA, sur 14 de ses workflows en production.
- Aleksei Spinov a mesuré un scraping de 12 pages à environ 0,165 $ via une boucle d’agent, et 0,014 $ avec un crawler déterministe. Michael Tuszynski fait tourner plus de 30 tâches planifiées et seules trois utilisent un agent.
Mon propre cas : ai-email-assistant#
Le projet que j’ai publié la semaine dernière, ai-email-assistant, applique cette idée du début à la fin, alors je le prends comme exemple.
Construit par l’IA. Les 15 commits sont co-écrits par Claude Opus 5.5, en une soirée. Environ 2 000 lignes de Python simple, sans dépendance à l’exécution, 125 tests hors ligne. J’ai relu le code ; je ne l’ai pas tapé.
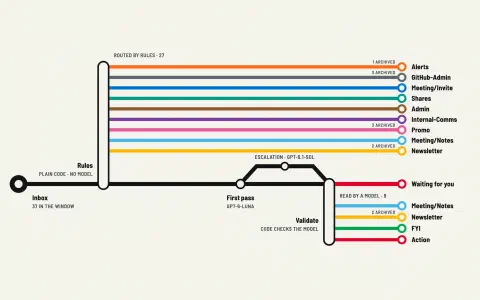
Exécuté par du code. Toutes les heures, les jours ouvrés, un job launchd applique les règles Gmail (la première qui correspond gagne), les balayages, un cache du jour et la validation de chaque réponse du modèle. Les échéances sont calculées par le code. Le journal d’annulation, c’est du code. Si les règles et le cache classent tout, aucun modèle n’est appelé.
Le modèle reçoit les restes. Seuls les mails qu’aucune règle ne sait classer vont à Claude Haiku 5.5, par lots, avec les métadonnées et un extrait de 240 caractères. Seul ce dont Haiku n’est pas sûr va à Sonnet. Et même les skills IA livrées avec le projet ont un seul rôle : proposer des règles déterministes. L’IA écrit les règles une fois, du code simple les applique toutes les heures.
Qu’est-ce que ça change ? Voici mon estimation, construite à partir du surcoût mesuré du projet (pas d’un mois d’utilisation réelle, que je n’ai pas encore) : une session d’agent à chaque exécution sur un modèle de la classe Sonnet paierait au moins les ~17k tokens de contexte de la CLI toutes les heures, environ 11,60 $ par mois, même avec une boîte vide. L’approche hybride coûte entre 0 et environ 2,50 $ par mois. L’essentiel de l’économie ne vient pas d’appels moins chers, mais des exécutions qui ne font aucun appel.
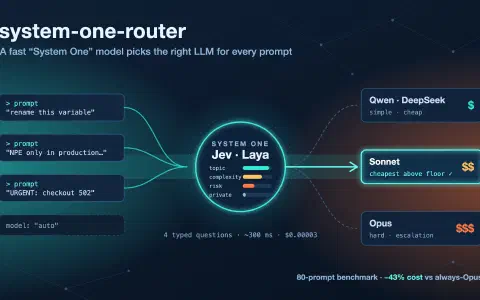
On retrouve le même schéma dans mes autres projets : system-one-router choisit un modèle avec un modèle de décision typé et de l’arithmétique, au lieu de demander à un LLM de router (la référence « LLM comme routeur » coûtait environ 4,6 fois plus par décision, pour une précision similaire), et leanproxy fait la recherche, la projection et la troncature dans le code avant que quoi que ce soit n’arrive dans le contexte. C’est aussi ce autour de quoi tournaient mes articles précédents sur un RAG local pour les assistants de code et un harnais d’outils pour les agents.
7. La règle : demander une fois, construire une fois, exécuter pour toujours#
Voici la checklist que j’utilise maintenant. Transformez un prompt en code (un script, un tableau de bord, une règle, un cron) quand au moins deux de ces affirmations sont vraies :
- J’ai posé essentiellement la même question 3 fois ou plus.
- Les entrées viennent des mêmes sources à chaque fois (même base, mêmes agendas, même boîte mail).
- La bonne réponse est définissable : un indicateur, une règle, un format, un seuil.
- J’ai besoin de la même réponse à chaque fois, pour la cohérence, la comparaison dans le temps ou l’audit.
- Ça tourne sur un planning ou un déclencheur, pas sur un coup de tête.
- D’autres personnes ont aussi besoin du résultat.
Gardez-le comme prompt quand la tâche est nouvelle, ambiguë, transversale ou vraiment ponctuelle.
Et quand vous le construisez, donnez chaque partie de la tâche au bon travailleur :
| Partie de la tâche | Qui s’en charge |
|---|---|
| Récupérer, filtrer, joindre, calculer, gérer les fuseaux | le code |
| Seuils, plannings, « est-ce normal ? » | le code |
| Expliquer une anomalie, peser des préférences souples, écrire pour un humain | un modèle, avec quelques centaines de tokens de contexte préparés par le code |
| Écrire et mettre à jour le code lui-même | un modèle, une fois, puis vous relisez |
Trouvez vos propres prompts répétés#
J’ai écrit un petit script qui lit votre historique local de Claude Code et regroupe les prompts que vous posez encore et encore, sans appel à un modèle. Sur le mien, il a trouvé 253 prompts humains, dont 13 % dans des groupes répétés sur deux jours ou plus. Le plus gros groupe, 28 fois, était un prompt type « relis ce changement pour trouver des vulnérabilités » déclenché automatiquement. Claude Code ne garde que les transcriptions récentes, donc ça couvre quelques semaines, pas un an. Mais ça m’a suffi pour voir lesquels auraient déjà dû être des scripts.
8. Limites honnêtes#
- Trois tâches, des données synthétiques, un seul modèle. Les données de test sont inventées et générées. Les vrais agendas et les vraies bases sont plus désordonnés, ce qui rend généralement l’agent plus cher, pas moins.
- De petits échantillons. Trois exécutions par « ask », une par « build ». Assez pour montrer la variance, pas assez pour des statistiques.
- Prix catalogue du 15 octobre 2026. Les abonnements, les remises et le traitement par lots changent les dollars, pas les rapports. Vérifiez-les avant de les citer.
- Les chiffres mensuels d’ai-email-assistant sont des estimations. Les seules données sur une vraie boîte viennent d’un seul essai à blanc sur une boîte personnelle calme. Une semaine de vrais journaux d’usage sur une boîte chargée donnerait un bien meilleur chiffre.
- Le coût annuel de l’équipe dépend de mes hypothèses : 20 personnes, 220 jours ouvrés, 60 $ de l’heure, 25 secondes d’attente. Le calculateur vous permet de toutes les remplacer.
- Les scripts ont aussi un coût. Ils cassent quand une API change, et quelqu’un doit s’en occuper. J’ai compté deux heures de maintenance par an ; chez vous, ça peut être différent.
9. Pour conclure#
L’IA est un fantastique compilateur d’intentions en outils. Dites-lui ce que vous voulez, relisez ce qu’elle écrit, et vous obtenez un script qui répond à la même question de la même façon, pour toujours, gratuitement. C’est la meilleure utilisation des tokens que j’ai trouvée cette année.
Alors voici ma suggestion : traitez un prompt répété comme un « code smell ». La troisième fois que vous tapez la même question, demandez à l’agent une dernière fois, mais l’outil. Ensuite, essayez le calculateur avec vos propres chiffres, et dites-moi où vos courbes se croisent.