Les agents font maintenant une grande partie de mon travail. Ils ouvrent des pull requests pendant que je dors, ils écrivent les tests, mettent à jour la documentation, réparent la CI. La plupart du temps, le résultat est bon. Mais « la plupart du temps » n’est pas le niveau attendu pour un dépôt public construit au-dessus de mes comptes bancaires.
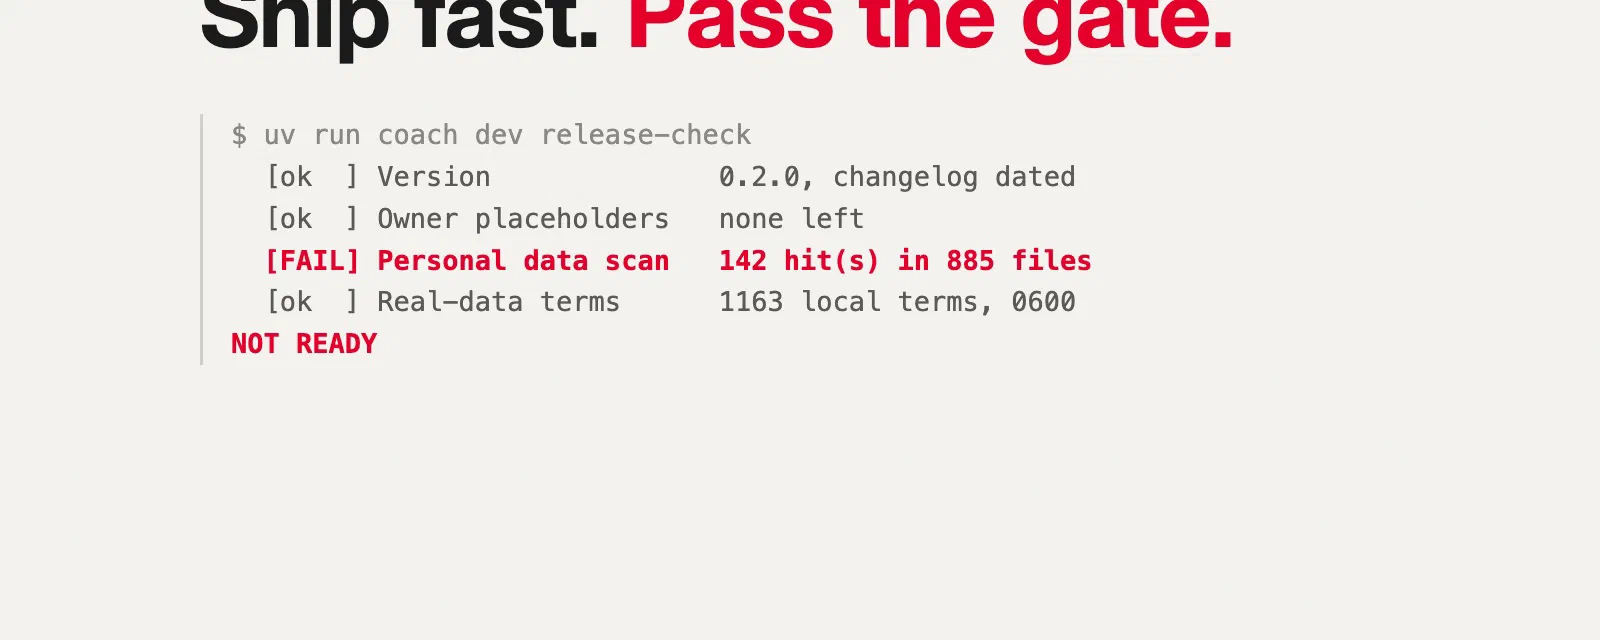
Ce week-end, avant de taguer ai-finance-coach 1.0.0, j’ai lancé une commande :
uv run coach dev release-checkElle a répondu NOT READY, avec 142 résultats dans le scan des données personnelles. La plupart étaient du bruit (j’y reviens plus bas), mais pas tous. Dans un dépôt où la CI était verte sur chaque pull request fusionnée, elle a trouvé :
- mon prénom dans les tests SSO, dans un test de formulaire web et dans deux documents ;
- le nom d’un employeur dans un identifiant de test ;
- l’un de mes propres montants dans le test de fiscalité locative, et un autre dans les données synthétiques de démo.
Personne ne les a mis là exprès. C’est justement le problème. Cet article parle du contrôle qui les a trouvés et, plus généralement, de la façon d’obliger les agents à passer le même contrôle à chaque fois qu’ils livrent quelque chose.
1. D’où viennent les fuites#
ai-finance-coach synchronise les comptes bancaires du foyer via PSD2 et garde tout dans une base locale chiffrée (je l’ai présenté ici). Pour savoir si un changement casse quelque chose, les tests synthétiques ne suffisent pas : les vrais libellés de mes banques sont plus désordonnés que tout ce que je peux inventer. Je valide donc souvent une pull request sur de vraies données, sur une copie jetable de la base (coach backup, puis coach restore dans un dossier temporaire).
C’est une bonne pratique pour le code. C’est une mauvaise pratique pour le dépôt, parce que les vraies données sont maintenant dans le contexte de l’agent. Et un agent qui écrit un test prend l’exemple le plus concret qu’il a vu. Dans un projet qui tourne sur vos données bancaires, l’exemple le plus concret, c’est le vôtre : le nom dans la réponse SSO, le commerçant qui a cassé le parseur, le montant exact de l’échéance du prêt.
Ça ne s’arrête pas aux tests. Les endroits où j’en ai trouvé, ou que j’ai dû protéger :
- les tests et les fixtures : une valeur « réaliste » copiée d’une vraie exécution ;
- la documentation et le changelog : un exemple un peu trop vrai ;
- les données de démo : un générateur où un montant inventé tombait par hasard sur un vrai ;
- les fichiers d’outils :
.claude/settings.jsoncontient des chemins absolus avec votre dossier personnel ; - l’espace de travail des agents eux-mêmes : Claude Code garde ses worktrees dans
.claude/worktrees/, des copies complètes du dépôt avec leurs propres fichiers de configuration.
2. Pourquoi la CI ne le voit pas#
La CI était verte sur chacune de ces pull requests. Elle n’avait aucune raison de ne pas l’être :
- La CI ne sait pas ce qui est personnel. Un scanner de secrets trouve une clé d’API ou un bloc de clé privée. Il ne sait pas que « Quenby » est la ville où vous habitez, ni que 1 357,91 est votre mensualité de prêt.
- On ne peut pas donner la liste à la CI. La liste de ce qui identifie votre foyer est elle-même le fichier le plus sensible que vous ayez. On ne peut pas la committer, et un hash n’aide pas : le hash d’un prénom se retrouve en quelques secondes avec un dictionnaire.
- Les relecteurs ne le voient pas non plus. Un nom dans une fixture de test ressemble à n’importe quel autre nom de test. Quand on relit des centaines de pull requests d’agents, on lit la logique, pas les valeurs d’exemple.
Le contrôle doit donc tourner là où se trouve la liste : sur ma machine. Et il doit tourner à chaque fois, ce qui veut dire que je ne peux pas compter sur ma mémoire.
3. Une seule commande pour toutes les vérifications obligatoires#
La première décision a été d’arrêter d’avoir une checklist dans la tête. Tout ce qui doit être vrai avant une release est un script, avec un seul code de sortie : coach dev release-check (src/coach/release.py, documenté dans docs/release.md).
coach dev release-check (coach 0.2.0, ~/Projects/ai-finance-coach)
  [ok  ] LICENSE file              LICENSE
  [ok  ] Owner placeholders        no licence / contact / repository placeholder left
  [ok  ] Version                   0.2.0, changelog dated 2026-10-06
  [ok  ] Web app build             built (5 asset reference(s) present)
  [FAIL] Personal data scan        142 hit(s) in 885 files (publishable + sdist): .github/CODEOWNERS:2  [real-data:machine#1163]; CODE_OF_CONDUCT.md:17  [real-data:machine#1163]; ...
  [ok  ] Real-data terms           the local term file was used (1163 terms)
  [ok  ] Package metadata          ai-finance-coach 0.2.0, python >=3.11
  [ok  ] Wheel contents            the built web app, the configuration example and the import profiles are packaged
  [ok  ] Shipped templates         memory skeleton present
  [ok  ] Project URLs              set
  [ok  ] Documentation             9 required documents present
  [ok  ] .gitignore                personal-data paths are ignored
  [ok  ] Docker files (static)     Dockerfile, docker-compose.yml and .dockerignore pass the policy (not built here)
  [ok  ] CI workflow               runs pytest, the web tests, ruff and release-check
  [FAIL] Python tests              exit 1: FAILED tests/test_hygiene.py::test_with_the_owners_local_term_file_the_repository_is_clean_too
  [ok  ] Lint (ruff)               passed
  [ok  ] Web tests (vitest)        passed
  [ok  ] Web type check            passed

NOT READY: 2 check(s) failed. See docs/release.md.
C’est la vraie sortie de l’exécution dont je parlais au début. Les corrections sont parties dans la pull request de la 1.0.0, et c’est cette même commande qui doit afficher READY avant un tag.
Trois règles la rendent utile plutôt que décorative :
- Chaque vérification est
ok,failouskip, et un skip n’est jamais un succès.--skip-testsexiste pour aller plus vite, mais l’exécution dit alors qu’elle ne vaut pas pour une release. Un fichier de termes absent est un échec, pas un passage silencieux : un scan sans la liste ne prouve rien sur votre foyer. - Elle vérifie aussi les choses ennuyeuses. Version dans
pyproject.toml= version dans le code = première section datée du changelog. Plus aucun marqueurTODO(license). L’application web construite, et pas plus ancienne que ses sources. Les vérifications ennuyeuses sont celles qu’un agent saute quand il a « presque fini ». - Elle n’envoie rien nulle part. Elle ne lance que des outils locaux, donc on peut la lancer sans hésiter sur la machine qui contient les données.
4. Le scan des données personnelles, en deux couches#
La vérification intéressante, c’est le scan des données personnelles (src/coach/hygiene.py). Il a deux couches.
Des règles structurelles, dans le dépôt. Elles ne contiennent rien sur personne, donc elles peuvent être publiques et tourner partout, CI comprise : un bloc de clé privée, une clé d’API, un chemin de dossier personnel (/Users/<name>/) qui n’est pas un exemple évident, un IBAN avec une clé de contrôle valide (les exemples et les tests utilisent des IBAN invalides), une adresse e-mail hors des domaines d’exemple réservés.
Les termes réels, hors du dépôt. Tout ce qui identifie mon foyer vit dans un fichier local, ~/.ai-finance-coach/hygiene-terms.txt, construit à partir de ma propre base et de ma mémoire :
$ uv run coach dev hygiene --build-terms
wrote 1163 term(s) to ~/.ai-finance-coach/hygiene-terms.txt (mode 0600; never commit or share it). Terms per category:
  name         20
  employer     3
  place        19
  school       1
  account      14
  id           22
  counterparty 19
  merchant     955
  amount       108
  machine      2
Des noms, des employeurs, des villes, des écoles, des libellés de comptes, des morceaux d’IBAN, les personnes à qui j’envoie de l’argent, les commerçants qui se distinguent, les montants récurrents exacts, les chiffres des prêts, et le nom d’utilisateur et le nom d’hôte de la machine. Les détails qui rendent un tel fichier acceptable :
- il est écrit en 0600 dès le premier octet et ignoré par git ;
- le scan refuse un fichier de termes situé dans le dépôt, il ne peut donc pas être committé par erreur ;
- la commande affiche des compteurs, jamais un terme ;
- un résultat n’affiche jamais le texte trouvé, seulement
fichier:ligneavec la catégorie et le numéro du terme, commeCODE_OF_CONDUCT.md:17 [real-data:machine#1163]plus haut. Le rapport lui-même peut être collé dans une issue ou lu par un agent ; - la recherche ignore la casse, les accents, la ponctuation et les espaces, et trouve un montant écrit
1234.56,1 234,56ou1234,56.
Les commerçants génériques (une chaîne de supermarchés, un libellé de banque) sont exclus exprès : ils sont publics, et les signaler ne ferait que du bruit.
5. Scanner ce qui est vraiment publié#
La première exécution complète sur ma machine a échoué pour une raison inattendue : le scan est entré dans .claude/worktrees/, où Claude Code garde une copie du dépôt par session. Chaque copie avait son propre docs/release.md avec les marqueurs à remplacer et son propre .claude/settings.json avec mon dossier personnel. 4 211 fichiers scannés, trois vérifications en rouge, tout ça à cause de l’espace de travail des agents.
Ces fichiers ne sont pas publiés : ils sont ignorés par git, ou ils appartiennent à un autre checkout. La correction a été de définir précisément ce qui est « publiable » :
- ce que git publierait : le scan applique lui-même
.gitignore(la dernière règle gagne, négations, parents exclus), donc la règle est la même que le dossier soit un dépôt ou non ; - jamais un autre checkout : un dossier sous la racine qui contient son propre
.gitest un worktree, un clone imbriqué ou un sous-module, et il est ignoré ; - plus ce que vous livrez vraiment : la liste des fichiers du sdist, et le contenu du wheel et du sdist dans
dist/quand ils existent. Un fichier peut être ignoré par git et finir quand même dans un paquet.
Après ça, 885 fichiers. C’est la vraie surface, et le contrôle la regarde en entier.
6. Obliger tout le monde à passer le contrôle, agents compris#
Un contrôle qui dépend de la mémoire de quelqu’un, c’est une suggestion. ai-finance-coach le met à quatre endroits, du moins cher au plus strict.
1. Les instructions de l’agent. CLAUDE.md dit quelles variantes un agent peut lancer seul sans risque (coach dev hygiene --ci, coach dev release-check --skip-tests --skip-web --ci), et ce qu’il ne doit jamais faire : construire les termes à partir de la vraie base, ou lire, afficher, déplacer ou chercher dans le fichier de termes. Le modèle de permissions le confirme avec des règles de refus (Read(**/hygiene-terms*), Bash(*hygiene-terms*)), et un test échoue si l’une d’elles disparaît.
2. La suite de tests. Le scan est un test pytest (tests/test_hygiene.py). Les agents lancent la suite de tests avant d’ouvrir une pull request (la checklist de contribution le demande), donc ils lancent le scan sans qu’on le leur demande. Les règles structurelles tournent partout ; sur ma machine, où le fichier de termes existe, la règle des données réelles tourne aussi. Les tests eux-mêmes n’utilisent que des valeurs inventées (le foyer de test, c’est la famille Zorbax, qui habite à Quenby-sur-Loze), et les chaînes à détecter sont construites à l’exécution, pour que le fichier de test ne contienne jamais ce qu’il cherche.
3. La CI. Un job release-check lance release-check --ci après les jobs de tests. --ci saute la règle des données réelles, parce que la CI n’a pas la liste, et le dit dans la sortie au lieu de faire semblant.
4. Le workflow de release. Les tags ne sont pas poussés à la main. Le workflow Tag a release prend une seule entrée, une case à cocher : « I ran uv run coach dev release-check (no –ci, no skips) on this commit and it printed READY ». Il vérifie ensuite que les trois versions concordent, que le tag n’existe pas, et que chaque job de CI est vert sur ce commit précis. Ce n’est qu’à ce moment qu’il pousse le tag et construit la release, qui relance le contrôle sur les archives construites.
La case à cocher est une déclaration humaine, pas une preuve, et ça me va. C’est la seule étape qui a besoin de la liste privée, donc c’est la seule étape qui reste chez moi.
Si vous voulez une version plus stricte du point 1, les hooks de Claude Code peuvent transformer l’instruction en blocage. Ce n’est pas dans ai-finance-coach aujourd’hui, mais la recette générique est courte. Un hook PreToolUse sur Bash qui refuse un push, un tag ou une release tant que le contrôle n’est pas vert :
#!/usr/bin/env bash
# .claude/hooks/release-gate.sh: no push, tag or release while the gate is red
cmd=$(jq -r '.tool_input.command // ""')
case "$cmd" in
  *"git push"*|*"git tag"*|*"gh release"*)
    if ! uv run coach dev release-check --skip-tests --skip-web > "${TMPDIR:-/tmp}/release-check.log" 2>&1; then
      echo "release-check is NOT READY: read $TMPDIR/release-check.log and fix it before delivering." >&2
      exit 2   # exit 2 blocks the tool call and sends the message back to the agent
    fi ;;
esac
exit 0
{
"hooks": {
"PreToolUse": [
{ "matcher": "Bash", "hooks": [ { "type": "command", "command": "\"$CLAUDE_PROJECT_DIR\"/.claude/hooks/release-gate.sh" } ] }
]
}
}L’agent ne peut alors plus livrer sans passer le contrôle, et le message lui explique pourquoi. Un hook git pre-push fait la même chose pour les humains.
7. Le contrôle est du code aussi, et il se trompe#
Revenons aux 142 résultats. La plupart venaient d’un seul terme : mon nom d’utilisateur, qui est aussi mon identifiant GitHub. Il correspondait à chaque URL du dépôt, à CODEOWNERS, à la LICENSE et au README. La correction : --build-terms exclut maintenant un nom de machine qui correspond au propriétaire du dépôt dans les URL du projet. Ce nom est public par ma propre décision.
Ensuite, une couleur CSS (#0d1422) et un identifiant (housing-5050) correspondaient à deux de mes vrais montants. La correction : un nombre collé à un mot fait partie d’un identifiant, ce n’est pas un montant.
Et cette correction était trop large. Une revue de sécurité automatique sur le commit a signalé que 17.43EUR ou EUR17.43, un montant avec la devise collée, était maintenant ignoré aussi. Un faux négatif dans un scanner de fuites, c’est le pire genre de bug : rien n’échoue, et les données partent. Une devise à côté d’un nombre compte de nouveau comme un montant, avec des tests pour les deux formes.
Trois leçons de cette soirée :
- Testez le contrôle comme n’importe quel autre code, avec des données inventées qui couvrent chaque règle, chaque faux positif corrigé et chaque faux négatif que vous pourriez introduire.
- Un contrôle bruyant finit ignoré. 142 résultats dont la plupart viennent d’un seul faux positif, c’est comme ça qu’on apprend à sauter une vérification. Corrigez le bruit vite.
- Faites relire le relecteur. Le faux négatif a été trouvé par une deuxième passe automatique, pas par moi.
8. Ce que le scan ne peut pas savoir#
La liste de termes connaît des noms, des lieux et des montants. Elle ne connaît pas une situation qui n’est dans aucun terme : combien d’enfants vous avez, un problème de santé mentionné en passant dans le backlog, le travail que vous n’avez jamais déclaré dans l’application. L’étape 6 de la procédure de release reste donc humaine : relire encore une fois le diff du README et du backlog, en cherchant tout ce qui est personnel et qu’aucune liste ne peut attraper.
Le contrôle enlève la partie mécanique, pour que la partie humaine reçoive l’attention dont elle a besoin.
9. La recette, sans la finance#
Rien de tout ça n’est propre aux données bancaires. Si vos agents travaillent avec de vraies données, des données clients, les noms internes de votre entreprise, vos propres données de santé ou d’entraînement, la même recette s’applique :
- Scriptez chaque vérification obligatoire dans une seule commande, avec un seul code de sortie.
ok,fail,skip; un skip n’est pas un succès. - Coupez le scan en deux : les règles génériques dans le dépôt, la liste des termes privés dans un fichier local que le dépôt refuse de contenir.
- N’affichez jamais ce que vous avez trouvé, seulement où et quelle catégorie. Le rapport peut alors circuler sans risque, vers un agent, une issue, un log de CI.
- Scannez ce qui est livré : ce que git publie plus vos paquets, et jamais les worktrees des agents.
- Mettez le contrôle partout : dans les instructions et les permissions de l’agent, dans la suite de tests, dans la CI, et comme étape obligatoire du workflow de release. Un hook si vous voulez un vrai blocage.
- Gardez une étape humaine pour la partie qui a besoin de la liste privée, ou du jugement.
- Testez le contrôle, et corrigez son bruit avant que les gens apprennent à l’ignorer.
Les agents ont rendu la production de code bon marché. Ils n’ont pas rendu bon marché le fait de dépublier des données : une fois dans un historique git public, elles sont dans chaque clone et chaque miroir. Quelques centaines de lignes de vérifications, lancées à chaque fois, coûtent beaucoup moins cher.
Le code est dans le dépôt ai-finance-coach (MIT) : src/coach/release.py, src/coach/hygiene.py et docs/release.md sont un bon point de départ si vous voulez reprendre l’idée.