Il 28 settembre ho pubblicato ai-running-coach, nove giorni dopo. Copriva tutto fino alla PR #122: la dashboard, le metriche per il trail, i controlli di sicurezza e il coach in tasca grazie a Claude Code Remote Control.
Cinque giorni dopo, il repository conta altre 27 pull request mergiate (dalla #123 alla #162), 88 commit e circa 64.000 righe nuove, in gran parte test e documentazione. In questo articolo le passo in rassegna una per una: a cosa servono e come funzionano sotto il cofano.
Una nota sugli screenshot. Li ho fatti tutti apposta per questo articolo, su un’istanza vera dell’app che gira in una sandbox. Siccome non volevo pubblicare i miei dati di salute, l’istanza usa il workspace demo del progetto: “Camille”, un profilo di atleta fittizio che prepara un trail di 42 km, generato dallo stesso codice usato dai test. La dashboard è in francese (la lingua di default del progetto). Dalla sandbox non si raggiungevano i server delle tile della mappa, quindi la mappa GPS più sotto è mostrata nella modalità offline dell’app: la traccia senza tile di sfondo.
0. Si parte dal video#
Il modo più semplice per farsi un’idea del progetto è il trailer. Non è un file video. Ogni fotogramma è disegnato in JavaScript su un canvas, quindi gira direttamente qui nella pagina:
Premi Play (con l’audio acceso). La narrazione è disponibile in inglese o in francese (non in italiano) e si può cambiare dal player; si possono anche attivare i sottotitoli o saltare a un capitolo sul profilo altimetrico. Aprilo a pagina intera o guarda tutti gli episodi.
Ci sono arrivato in tre passi:
- PR #128: una presentazione di 80 secondi. Ogni fotogramma è una funzione pura
render(t)del tempo trascorso, disegnata su un canvas 16:9. Niente file video e niente build. I font (Inter, Sora, JetBrains Mono) sono inclusi con le loro licenze OFL, così la pagina non fa nessuna richiesta a servizi esterni. Se serve un MP4,scripts/render_video.pylo genera fotogramma per fotogramma con Chrome headless e ffmpeg. - PR #157: «Il Sentiero» (Le Sentier), una serie di 12 episodi narrati più un trailer. C’è un episodio per ogni funzionalità, a metà strada tra una demo e la documentazione, e ognuno è messo in scena come una gara di trail. Si apre con un pettorale, i capitoli sono ristori che si possono cliccare su un profilo altimetrico, e un arco d’arrivo porta alla pagina di documentazione corrispondente. Tutti gli episodi condividono un unico motore (player, capitoli, sottotitoli, funzioni di disegno). La narrazione viene generata offline a partire da un copione, con un lessico di pronuncia (IPA) perché la voce dica correttamente “HRV” e “/today”, e insieme vengono generati i sottotitoli WebVTT. Gli screenshot negli episodi sono catture vere della dashboard sul workspace demo (31 in tutto), e le scene di chat riproducono una conversazione scritta in anticipo tramite un backend finto, quindi nessun LLM viene chiamato.
- PR #161: voci migliori. La prima narrazione usava Kokoro, che gira completamente offline ma suonava parecchio robotica.
video_narration.pyora accetta diversi motori (kokoro,azure,edge,kyutai,chatterbox), e la serie è stata rinarrata con le voci neurali multilingue di Microsoft (Remy in francese, Andrew in inglese).
Per rispondere alla domanda ovvia: sì, visto che è HTML e JavaScript e non un file video, posso inserire il player direttamente nell’articolo con un iframe che punta al sito di documentazione del progetto. E resta allineato con la documentazione: quando lì un episodio viene aggiornato, questa pagina mostra la versione nuova.
1. Parlare con il coach dalla dashboard#
Nell’ultimo articolo ho spiegato perché il mio telefono parla con il coach tramite Remote Control: un’interfaccia fatta in casa non può usare un abbonamento Claude Pro/Max. Vale ancora. Però a volte voglio solo scrivere una domanda nella dashboard che ho già aperta. Così ora nella dashboard c’è una pagina Coach (PR #130, la più grossa del lotto con circa 15.000 righe).
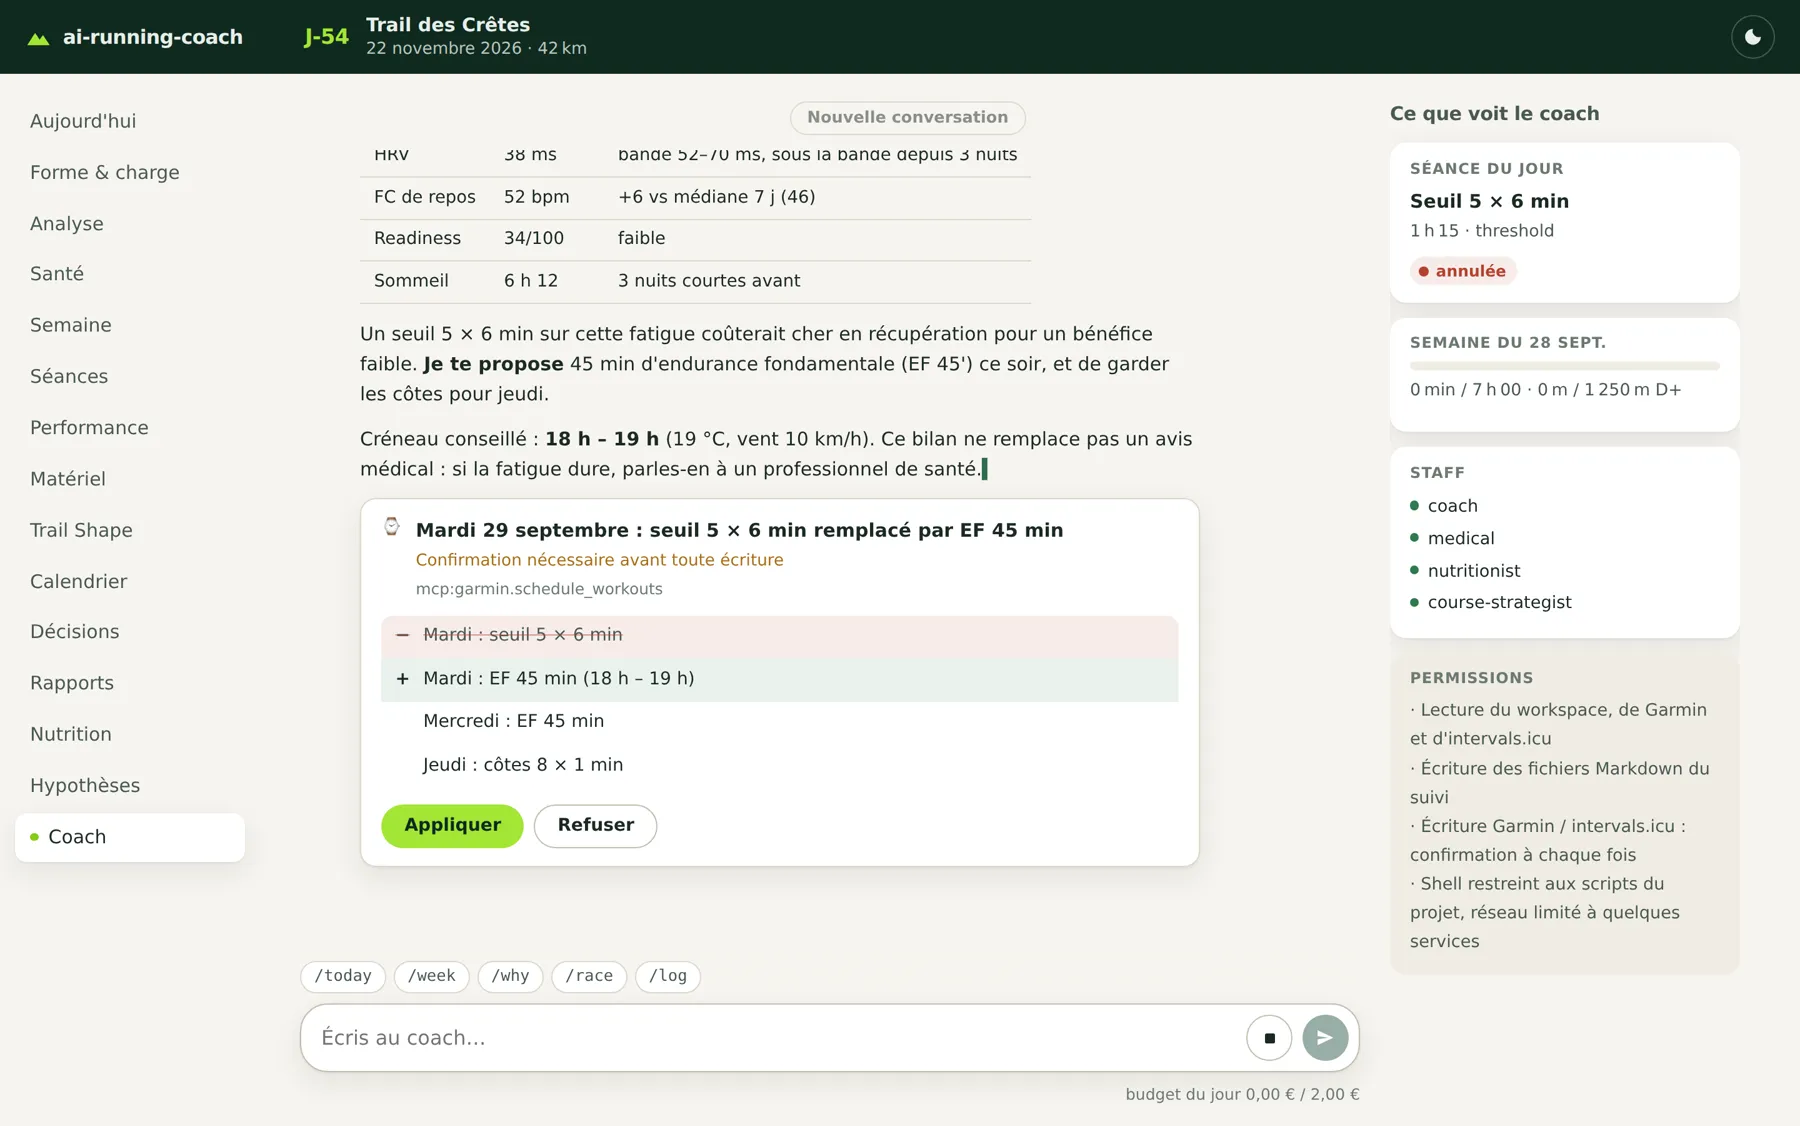
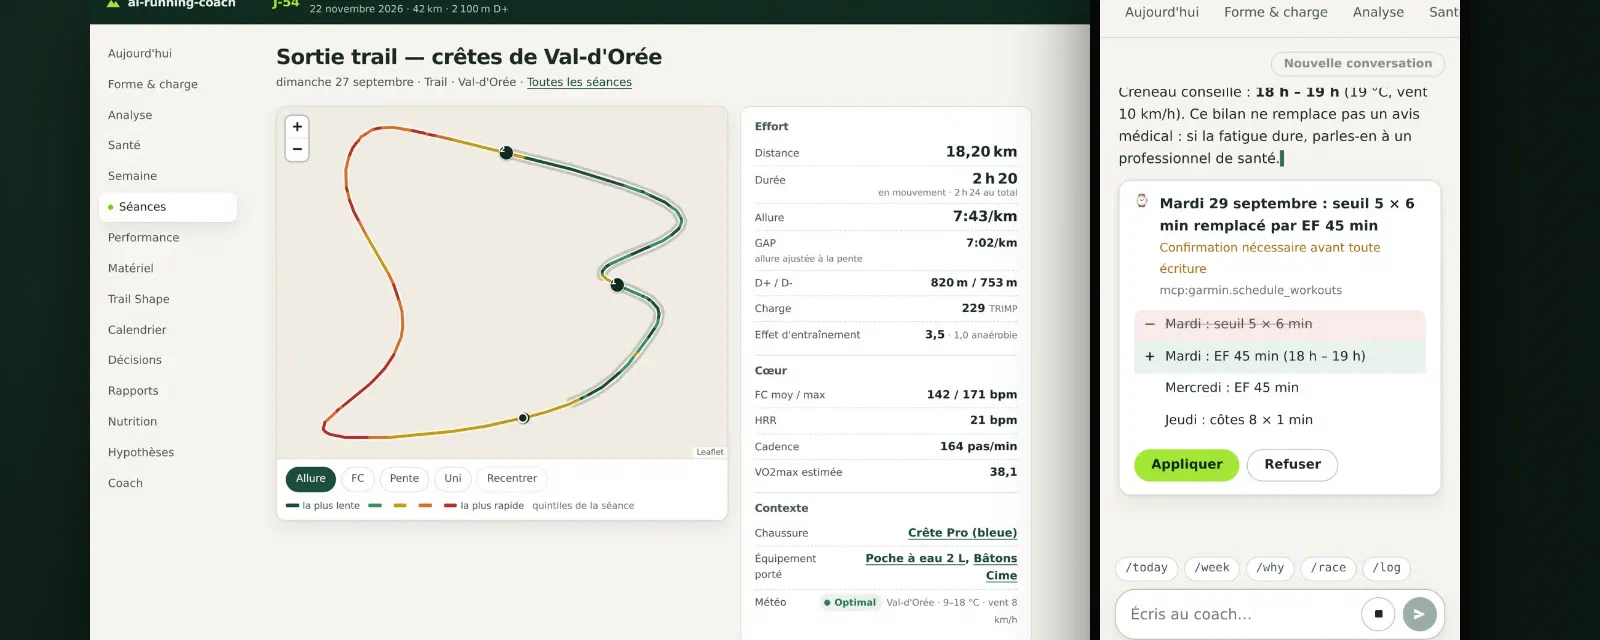
L’atleta dice di sentirsi senza energie prima di una seduta a soglia. Il coach controlla HRV, FC a riposo, readiness e meteo, propone di sostituire la seduta, e aspetta. Su Garmin non viene scritto nulla finché non si preme “Appliquer” (Applica).
Come funziona:
- È un servizio separato. La dashboard resta in sola lettura e non vede mai una chiave API. Un processo dedicato,
scripts/arc_chat.py, gira sulla macchina del coach ed è l’unica parte che scrive nel workspace. - Stessi agenti, stessi file. Usa gli stessi agenti, le stesse skill, lo stesso server MCP di Garmin e gli stessi file Markdown di una sessione nell’IDE. La chat non aggiunge una nuova fonte di verità.
- Due backend. Si può usare il Claude Agent SDK (il motore dietro Claude Code, modello di default
claude-sonnet-5-5) oppure un server OpenCode con qualsiasi API compatibile OpenAI, per esempio OpenRouter. - Ogni scrittura su Garmin o Intervals.icu richiede la tua approvazione. Una scheda mostra il prima/dopo e si accetta o si rifiuta, sulla pagina o dalla notifica push. Un’approvazione vale una sola volta: una seconda chiamata identica mostra una nuova scheda.
- Una politica dei permessi rigida. La shell è limitata agli script del progetto, con le opzioni verificate rispetto all’
argparsedi ogni script. Un test di lint fallisce se una skill chiama uno script che la politica non conosce, così la politica non può allontanarsi dalle skill. - Budget. Un contatore mostra il costo della conversazione, c’è un tetto giornaliero, e ogni turno si riserva il proprio budget (1 € di default) così anche un’approvazione arrivata tardi può andare fino in fondo.
- Tutto è tracciato. Ogni chiamata a uno strumento compare in una traccia numerata e richiudibile, e resta visibile solo la risposta finale.
Ho provato otto modelli su OpenRouter, su un workspace vero con Garmin in sola lettura, con tre richieste reali e controlli automatici (/log, un check mattutino, /week). DeepSeek v4.1 Flash è arrivato primo: ha ottenuto il punteggio migliore ed era il più economico, con circa 0,80 € per un mese tipico di utilizzo. Claude Sonnet è il più adatto per le decisioni delicate, ma costa di più (circa 30 € al mese, stimati). Il confronto completo è nella documentazione della chat.

Sul telefono la pagina si riduce alla conversazione, e la scheda di approvazione resta a portata di pollice.
Due interventi successivi l’hanno resa pratica da mettere in produzione: la PR #156 fa girare la chat in un container suo accanto alla dashboard, dietro lo stesso Traefik con SSO (/api/chat dietro single sign-on, /api/chat/approve con un token, solo POST, con rate limit), e il /coach-doctor del progetto ora verifica che il servizio di chat sia raggiungibile e in salute.
2. La pagina della seduta ha una mappa GPS#
L’ingestione dei FIT salva le coordinate GPS fin dall’inizio, ma niente le mostrava. La PR #160 ha ricostruito la pagina della seduta attorno a una mappa:

La seduta demo: 18,2 km e 820 m di dislivello positivo. La traccia è colorata per quintile di passo (si può colorare anche per FC o pendenza), e i marcatori numerati sono le salite individuate. Questa è la modalità offline, senza tile di sfondo.
- La mappa usa Leaflet (incluso nel repository, non caricato da una CDN) con le tile di OpenTopoMap. Il server delle tile si configura in
[dashboard].map_tiles. Lasciandolo vuoto si passa alla modalità offline, e solo quell’host viene aggiunto alla Content-Security-Policy. - La traccia si può colorare per passo, FC o pendenza, e le salite sono evidenziate.
- Sotto la mappa c’è un profilo altitudine / FC / passo / cadenza, collegato alla mappa da un cursore condiviso: ci si sposta lungo il profilo e il marcatore si muove sulla mappa.
- Una nuova route,
/api/activity/<id>/track, è l’unica API che espone le coordinate. Tutto il resto rimane senza dati di posizione. - La pagina mostra anche le sensazioni della seduta (RPE, carboidrati, liquidi, i dolori segnalati quel giorno), le dinamiche di corsa, l’attrezzatura usata, e il blocco energia descritto nella prossima sezione.

3. Un secondo parere sulle calorie#
Garmin dà un numero di calorie per ogni seduta. È una stima, e quando il sensore ottico della FC va per conto suo può sbagliare di parecchio. La PR #123 aggiunge un modello energetico indipendente, costruito in cinque passi:
- Il motore (
scripts/arc_energy.py, funzioni pure). In corsa usa l’equazione RE3 (Looney, Hoogkamer & Kram, 2025), che ricava la potenza metabolica da velocità e pendenza. In camminata usa il polinomio della camminata di Minetti (2002). Da fermi conta solo il metabolismo in piedi. Integra campione per campione sui dati FIT normalizzati e non colma mai un buco. Validato su 7 sedute vere: entro ±0,6 % dal calcolo di riferimento, e dal 3 al 6 % sopra Garmin. - Indicizzazione. Una tabella derivata
activity_energy, costruita per corsa, trail, escursionismo e camminata. Il peso viene preso alla data della seduta (file salute, poi nutrizione, poi profilo), e ogni fallimento viene segnalato con un motivo esplicito (no_weight,no_samples…). - Piani gara. Lo stratega di gara ora stima l’energia per ogni tratto del percorso (kcal, kcal/h, cumulata), con il tuo peso il giorno della gara più il peso dello zaino, e la mette accanto al piano di rifornimento.
- Dashboard. Ogni seduta mostra Garmin contro modello, lo scarto e una suddivisione (piano / salita / discesa / camminata / fermo). La vista Analisi segue lo scarto nel tempo:

- Calibrazione personale. Quando ci sono almeno 15 sedute in una categoria strada o trail (nelle ultime 26 settimane), il progetto calcola il rapporto mediano Garmin/modello. Il fattore è limitato tra 0,8 e 1,2, e viene applicato solo alle previsioni, mai alle sedute passate.
La regola a cui tengo di più: Garmin resta il riferimento ovunque (nutrizione, report). Il modello è solo un controllo (uno scarto oltre il 15 % di solito vuol dire un sensore cardio difettoso o una seduta etichettata con lo sport sbagliato) e uno strumento di previsione per una gara che deve ancora arrivare. Dopo ogni seduta, il coach aggiunge una riga come “Energia: Garmin 1.420 · modello 1.167 (−17,8 %)” e, quando lo scarto è grande, suggerisce le cause plausibili.

4. Un armadietto per l’attrezzatura: scarpe, materiale, sincronizzazione Garmin e ispezioni con foto#
È la funzionalità più grossa della settimana. È arrivata in sette PR, una per ogni issue GitHub.
Scarpe con una vera storia (PR #136). Nel profilo, un paio ora può avere un chilometraggio di partenza (départ 120 km, per scarpe comprate usate o già usate prima di iniziare con il progetto). Il coach prevede quando mandarle in pensione in base all’uso degli ultimi 28 giorni, segnala i paia vicini alla soglia, manda l’avviso di soglia superata una sola volta (identificato dalla seduta che l’ha superata, così una nuova sincronizzazione non lo ripete), e suggerisce quale paio mettere quando ne hai due o più in rotazione.
Sincronizzazione dell’attrezzatura Garmin (PR #137). Garmin Connect sa già quali scarpe hai usato. Il coach ora lo legge con get_gear e get_activity_gear. Collegare un paio a una seduta su Garmin (add_gear_to_activity) è una scrittura, quindi chiede sempre prima conferma. Quando le tue note e Garmin non sono d’accordo, vince quello che hai scritto tu.
Recuperare lo storico (PR #146). scripts/garmin_gear_backfill.py fa una chiamata get_gear_activities per ogni paio per attribuire tutto lo storico alle scarpe giuste. Di default è un dry run: senza --apply non cambia nulla. È idempotente e non conta mai due volte il chilometraggio di partenza.
Non solo scarpe (PR #140). Una nuova sezione ### Matériel (attrezzatura) copre bastoncini, gilet da corsa, soft flask, frontali, fasce cardio, giacche… Ogni oggetto può avere soglie tipizzate: km, ore, sedute, giorni, settimane, mesi. Si possono raggruppare gli oggetti in kit (il kit “trail lungo”), e dire “kit trail lungo” dopo un’uscita li attribuisce tutti in un colpo. Prima di una gara, lo stratega confronta la lista del materiale obbligatorio con il tuo inventario: mancante, da verificare (corrisponde solo la categoria), mai usato in allenamento (“niente di nuovo il giorno della gara”) oppure in allerta. Non si inventa mai un oggetto.
Ispezioni con foto (PR #141 e #150). Ogni ~200 km, il coach propone (non impone mai) un’ispezione di un paio. Si scattano cinque foto: le due suole in piano, una vista laterale, una posteriore, la tomaia, e una moneta o un righello per la scala. Si mettono in gear/photos/ o si indica il percorso, e si scrive /inspection. La skill gear-inspection restituisce:
- un verdetto 🟢🟡🟠🔴 spiegato visivamente (gomma e tasselli, intersuola, contrafforte del tallone, tomaia);
- un confronto esplicito con l’ispezione precedente dello stesso paio, che è il segnale più affidabile;
- indizi sull’appoggio a partire dalle zone di usura (tallone posterolaterale → appoggio di tallone, e così via), sempre formulati come indizi e mai come diagnosi;
- un’asimmetria sinistra/destra confrontata con lo storico degli infortuni, e un passaggio di consegne all’agente medico se è attivo;
- un riepilogo della carriera quando un paio va in pensione.
Le foto vengono rinominate e non vengono mai sovrascritte o cancellate. I file HEIC vengono segnalati come non supportati invece di essere ignorati in silenzio.
Una vista dedicata (PR #148). Tutto questo sta in una nuova vista Matériel (Attrezzatura), con un riepilogo “da fare” in alto e una pagina per ogni oggetto (riepilogo della carriera, km al mese, sedute, ispezioni).
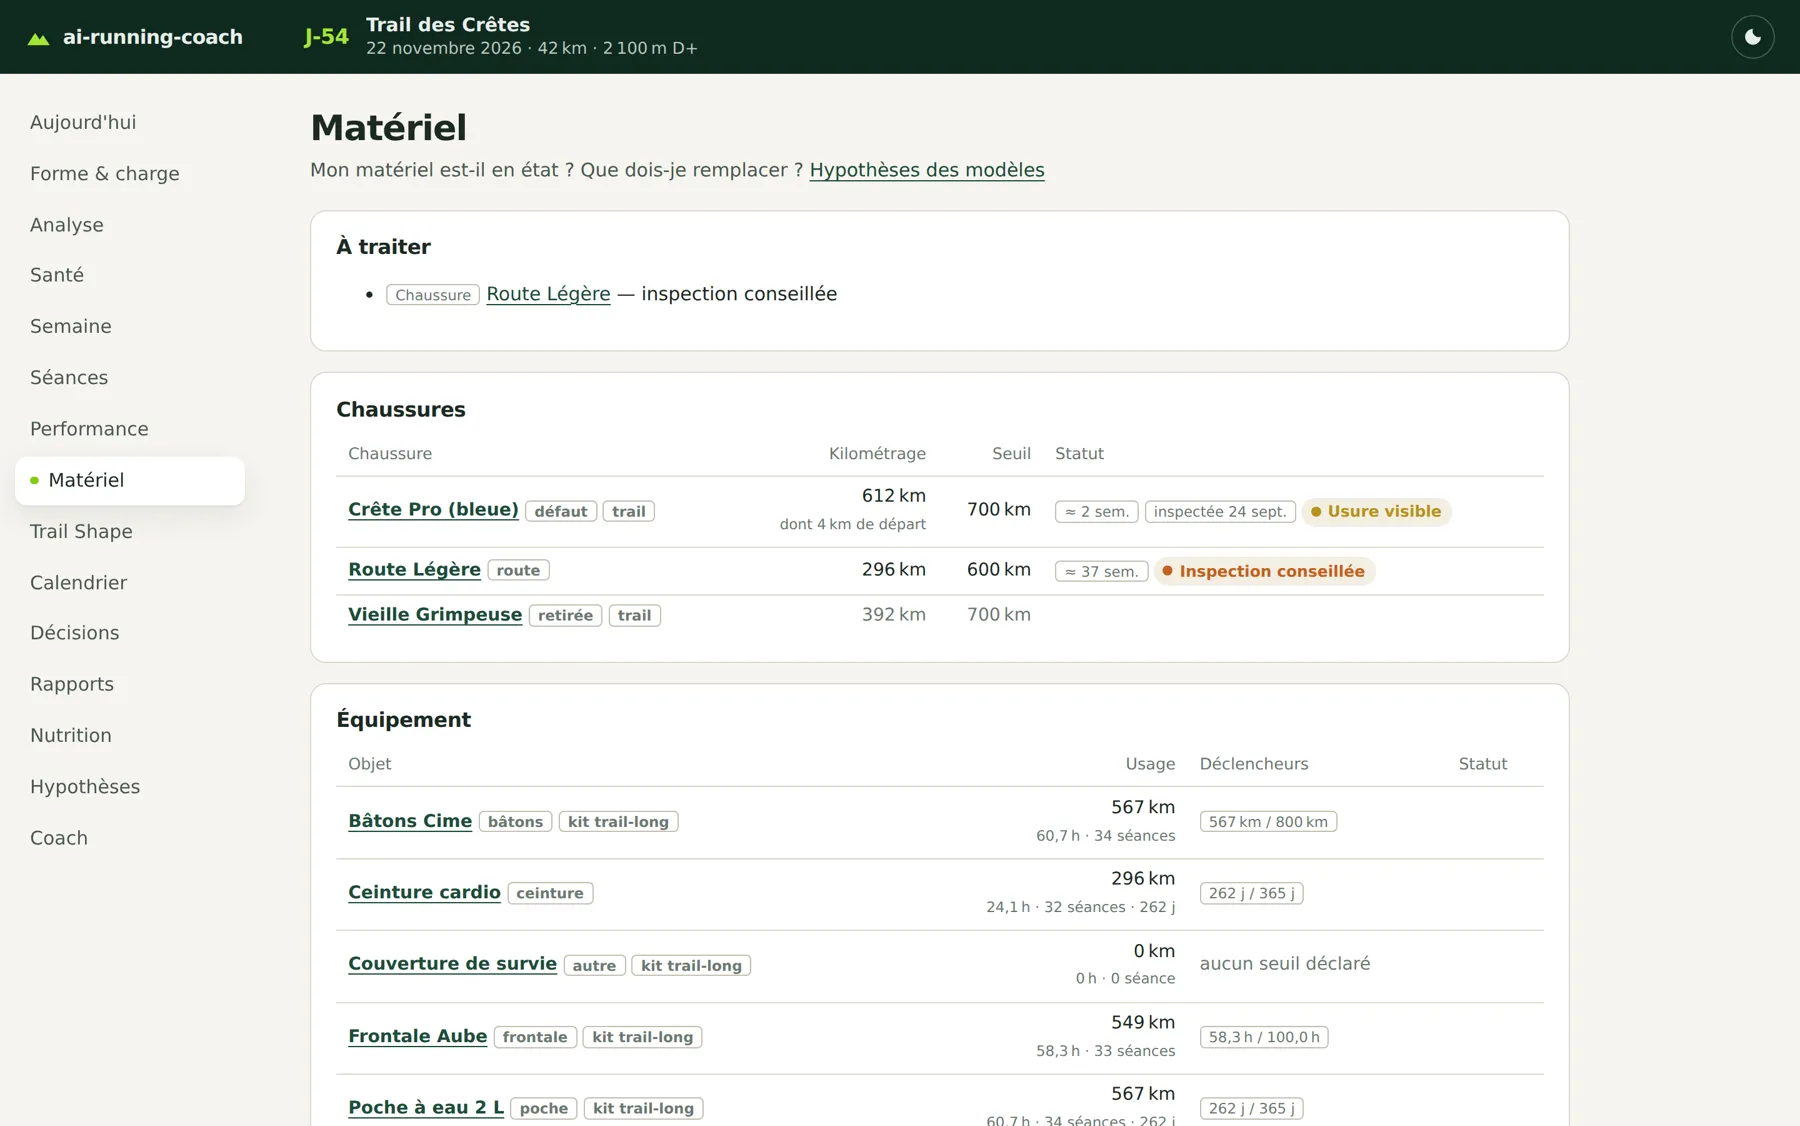
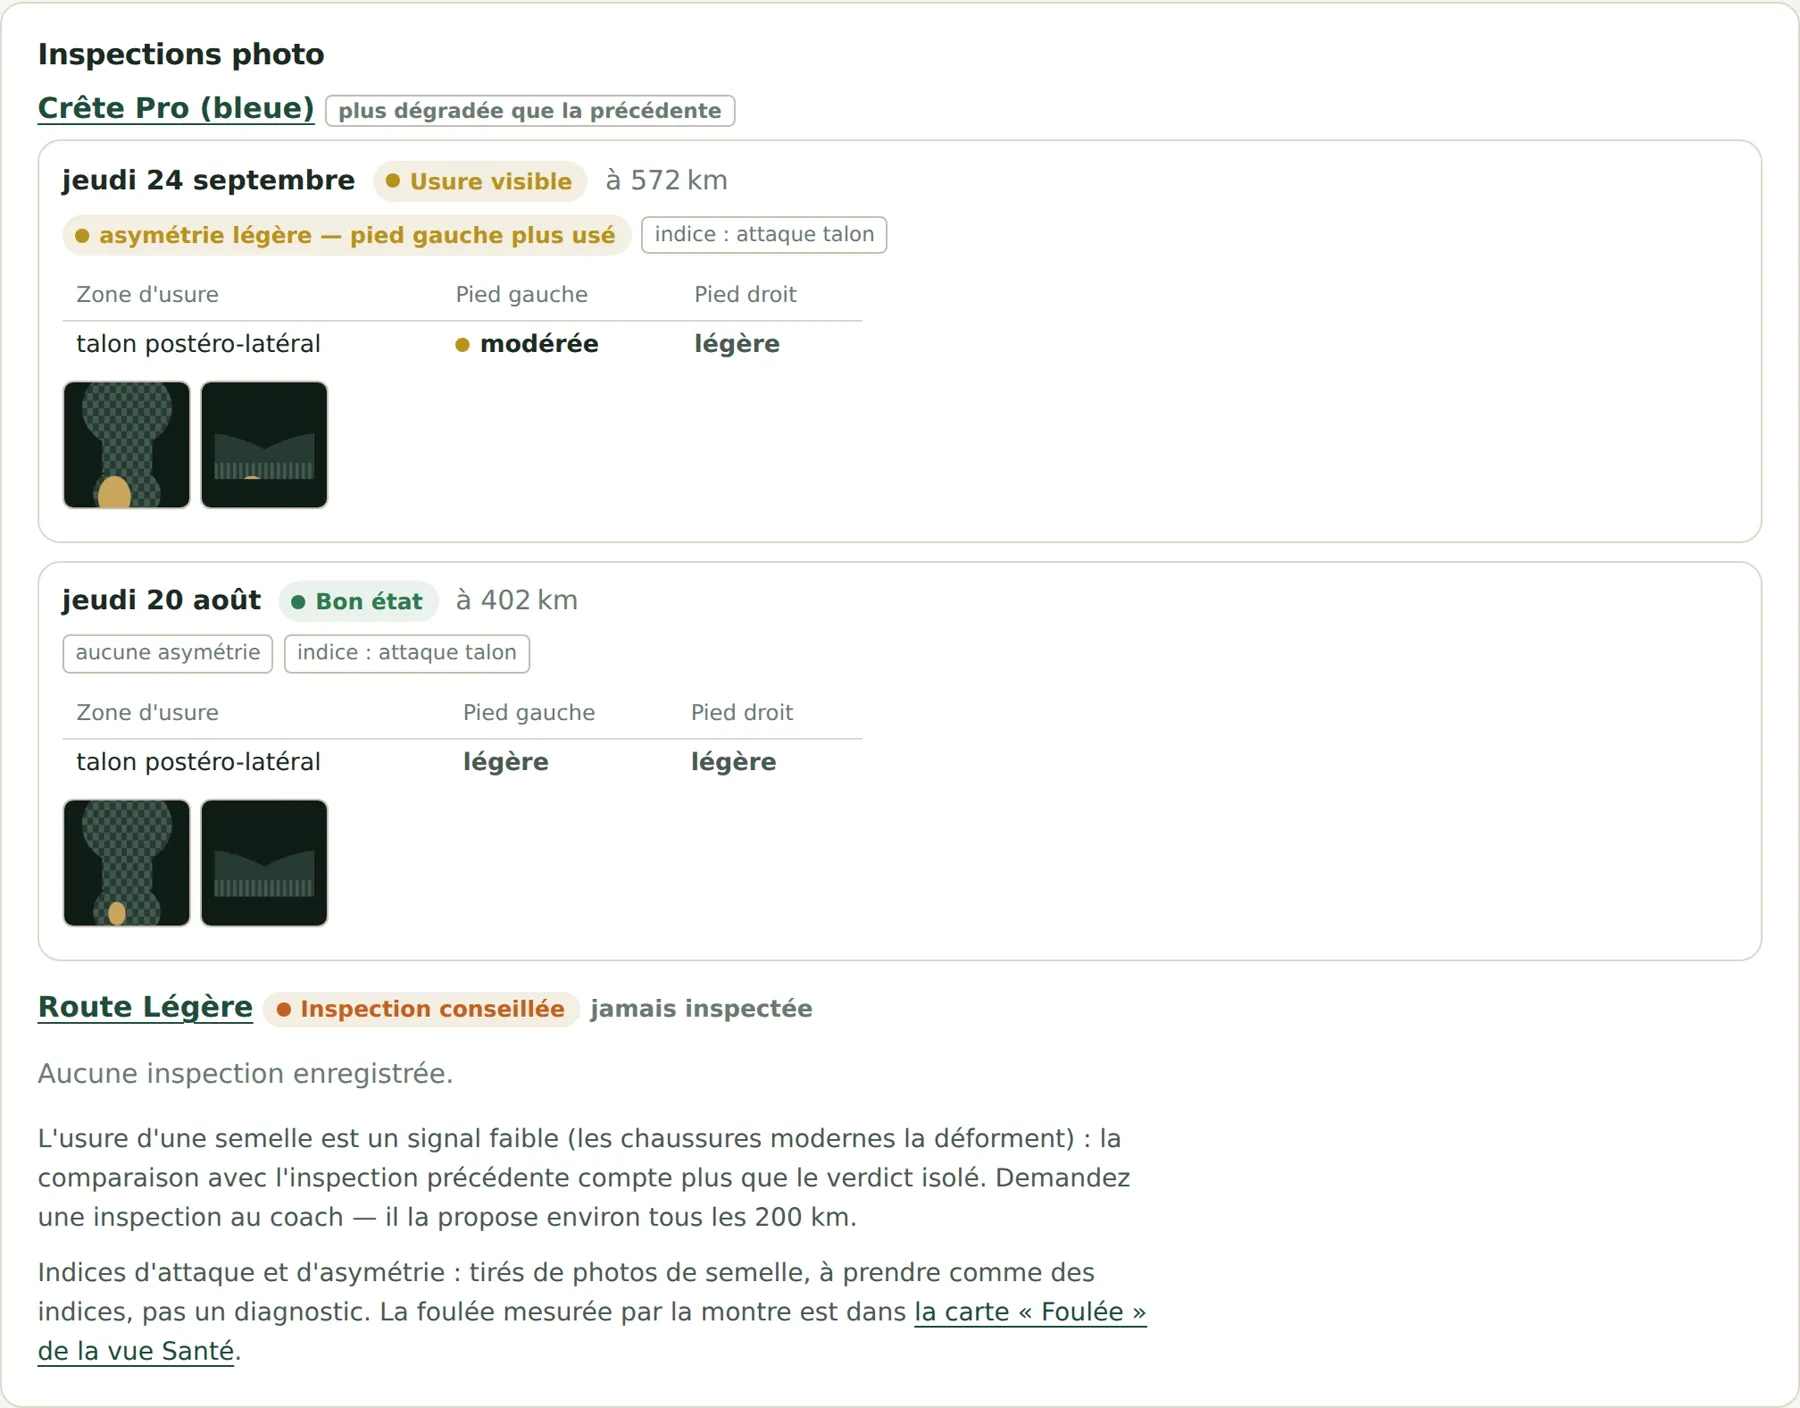
Il workspace demo usa immagini generate, non foto vere di scarpe.
5. Dinamiche di corsa: quello che misura l’orologio e quello che suggeriscono le suole#
Se l’orologio o la fascia cardio registrano le dinamiche di corsa, i file FIT contengono tempo di contatto al suolo, bilanciamento del contatto al suolo, oscillazione verticale, rapporto verticale e lunghezza del passo. La PR #152 li estrae (con download_fit.py --refresh-dynamics per rileggere offline i FIT che hai già) e aggiunge una scheda Falcata (Foulée) alla vista Salute:

La scheda fa una cosa che mi piace molto: separa quello che è misurato da quello che è dedotto. Gli indizi delle ispezioni fotografiche sono elencati sotto le misure, e quando non concordano (“usura asimmetrica, ma il bilanciamento misurato è entro 0,6 punti dal 50 %”), la scheda lo dice e vince la misura. Non cambia mai il carico di allenamento né il piano.
6. Convivere con uno storico lungo#
Dopo qualche mese, alcune pagine stavano diventando troppo lunghe o troppo lente:
- La dashboard era lenta alla prima richiesta (circa 5 s, e di nuovo dopo 30 s di inattività), perché la reindicizzazione girava dentro la richiesta e ogni metrica FIT veniva ricalcolata anche quando non era cambiato nulla. La PR #126 ha spostato l’indicizzazione in un thread in background, ha aggiunto un’impronta per saltare i passaggi senza modifiche e una cache per seduta, gzip ed ETag. Sui dati reali (694 file, 118 FIT), un passaggio senza modifiche è sceso da 5 s a 0,2 s, e uno con modifiche da 8,9 s a 0,44 s, con tabelle identiche a un ricalcolo completo.
- Sedute (PR #154): ricerca per nome o luogo (senza badare agli accenti), filtri per sport e anno, totali per il filtro attivo, raggruppamento per mese con i relativi totali, 50 per pagina, e lo stato salvato nell’URL. Facendo questo lavoro ho scoperto che
/api/activitiesera limitata a 500 e troncava in silenzio gli storici lunghi. Ora il limite è 10.000.

- Ipotesi: l’elenco delle ipotesi dei modelli in fondo alla pagina Performance è diventato una vista a sé, con 94 ipotesi raggruppate per modello, un modello alla volta, una ricerca globale e link contestuali da ogni grafico (“come viene calcolato?”).

7. Un secondo contributo esterno: @rdlh#
Dopo Giovanni la settimana scorsa, una seconda persona ha mandato delle pull request: @rdlh, che usa il progetto con Intervals.icu come fonte dati. Non è la mia configurazione, e infatti ha fatto emergere bug veri:
- PR #142: download dei FIT da Intervals.icu. Con
--source intervals, il coach ora può scaricare e analizzare anche i file FIT, quindi tutte le metriche per il trail (GAP, disaccoppiamento, VAM, tenuta) funzionano senza Garmin. Un import da Strava o un inserimento manuale senza file FIT viene segnalato come non disponibile, non come errore, così la sincronizzazione automatica non lancia falsi allarmi. - PR #138: altitudine bloccata a 0,0 m. Alcuni orologi scrivono esattamente 0,0 m quando l’altimetro non ha una lettura, anche a metà di un’uscita a 800 m (è saltato fuori con un Apple Watch sincronizzato tramite Intervals.icu). Ogni bordo di questi buchi produceva una “salita” di diverse centinaia di metri in pochi secondi (oltre 100.000 m/h!), che mandava all’aria GAP e disaccoppiamento. Le sequenze a 0,0 m vicine a una lettura valida distante almeno 20 m ora vengono trattate come mancanti. Uno 0 m vero, al livello del mare, viene mantenuto.
- PR #139: il tempo in zona era sovrastimato. Ogni intervallo da 5 secondi contava come 5 secondi pieni, anche intorno a una pausa o alla fine di un’uscita. Ora ogni intervallo registra i secondi che copre davvero.
- PR #124:
/coach-setupmostrava le etichette delle risposte troncate e disallineate con Python < 3.11, perché il parser TOML di riserva divideva gli array sulle virgole, comprese quelle dentro le stringhe.
Le pull request di @rdlh dicono tutte la stessa cosa: “codice scritto da Claude (Claude Code), rivisto e validato da rdlh”. È esattamente il modo in cui lavoro anch’io su questo progetto. Grazie! 🙏
8. Dietro le quinte#
- Revisione di sicurezza (PR #144). La sincronizzazione automatica ora è più blindata: Python può eseguire solo gli script del motore (niente più
python3 -c), la scrittura inscripts/,skills/,.claude/e.mcp.jsonè negata, e gli strumenti Garmin che scrivono (allenamenti, percorsi) sono esclusi dall’esecuzione automatica.garmin_mcpè fissato a un commit, e sono state chiuse due fughe di configurazione (un file.bakche conteneva il topic ntfy, e la configurazione utente che finiva nell’immagine Docker). - Claude nella CI (PR #129 e #143). Ogni PR riceve una revisione da Claude Code, e si può chiedere aiuto a
@claudenei commenti. Entrambi i workflow vengono saltati per i fork e per chi non è collaboratore, invece di fallire. - Release (PR #162). Si può creare su richiesta un tag SemVer (patch / minor / major), viene pubblicata automaticamente una release GitHub con le note generate, e le PR ricevono un’etichetta in base al prefisso del titolo (
feat,fix,docs,test). - La PR #125 ha sistemato un problema silenzioso: sulla macchina del coach, sotto SSH e cron, il download dei FIT non trovava l’ambiente Python di Garmin, quindi la sincronizzazione giornaliera saltava i campioni FIT senza dire niente.
E adesso?#
Due di queste funzionalità cambiano il posto che il progetto occupa nella giornata: l’armadietto dell’attrezzatura, che trasforma “queste scarpe sono da buttare?” in un numero e in uno storico di foto, e la chat, per i momenti in cui si è alla scrivania invece che sul divano con il telefono. E i video sono la risposta migliore che ho a “ma quindi, cosa fa concretamente?”.
Per provarlo:
git clone https://github.com/mmornati/ai-running-coach.git
cd ai-running-coach
./install.sh # oppure --preset coach-server- 🎬 Video: mmornati.github.io/ai-running-coach/videos
- 📖 Documentazione: mmornati.github.io/ai-running-coach
- 💻 GitHub: github.com/mmornati/ai-running-coach
Issue, idee e pull request sono benvenute. Due persone hanno già mostrato come si fa! E come sempre, è uno strumento per aiutarti a prepararti: non sostituisce il parere di un medico.