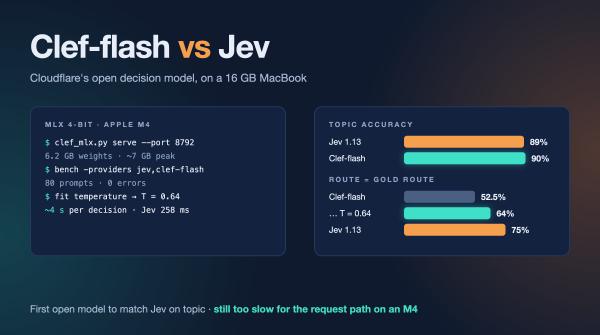
Tre giorni dopo l’annuncio di Cloudflare, Clef-flash ha affrontato lo stesso benchmark da 80 prompt di Jev, Laya, Von e Kev. 90% di accuratezza sull’argomento, una temperatura di confidenza che lo porta al livello di Jev sulla calibrazione, e un problema che nessuna temperatura può risolvere su un portatile.
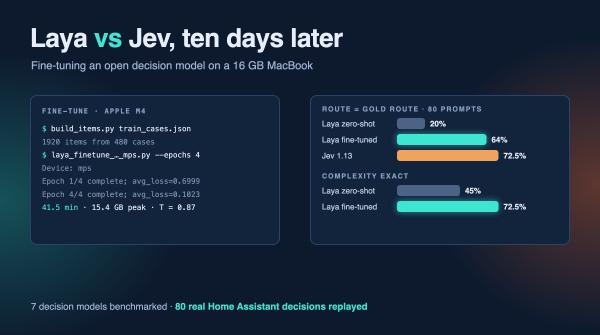
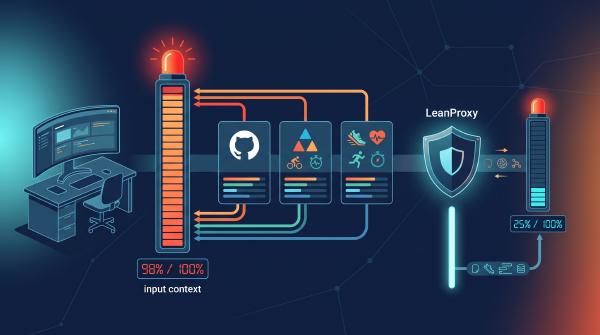
Laya dice “fammi il fine-tuning”, e l’ho fatto, su un MacBook da 16 GB. Ecco la ricetta, quanto ci vuole, cosa cambia sul benchmark da 80 prompt, e perché la mia casa gira ancora su Jev.
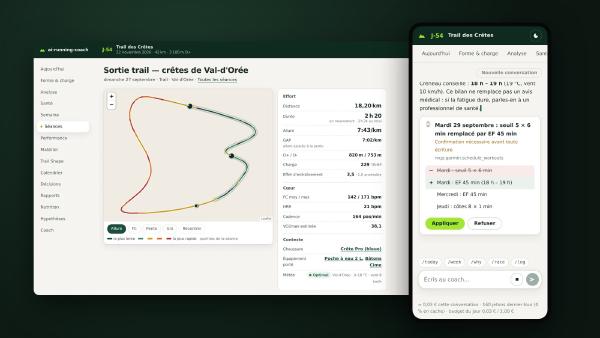
Una chat con il coach dentro la dashboard, una mappa GPS su ogni seduta, un modello delle calorie che controlla i numeri di Garmin, un vero armadietto per l’attrezzatura con ispezioni fotografiche, le dinamiche di corsa, un secondo contributo esterno, e “Il Sentiero”, una serie di video disegnata in JavaScript che puoi guardare direttamente qui.
Una dashboard, un bel po’ di metriche nuove, dei controlli capaci di dire di no, e un coach che gira su una macchina Linux a casa e mi risponde dal telefono. Ecco cosa è cambiato in ai-running-coach dopo l’ultra, e perché la sincronizzazione automatica usa cron e non una routine di Claude.
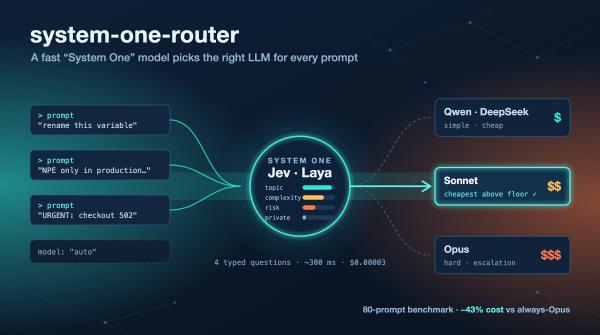
Il mio primo router di modelli lasciava a un LLM il compito di leggere un file di prompt e scegliere un agente. Questo fa quattro domande tipizzate a un modello decisionale “System One”, calcola il punteggio dei modelli con semplice aritmetica, e pubblica un benchmark per dimostrare che funziona (e per mostrare dove non funziona).