Ho chiuso l’articolo di ieri dicendo che i modelli decisionali aperti avevano raggiunto Jev sull’argomento, ma non ancora su complessità e rischio. Non mi aspettavo che il candidato successivo arrivasse nella stessa settimana, e tanto meno da Cloudflare.
Questo è il quarto articolo di una serie. Se arrivate qui adesso:
- system-one-router: un gateway in Go che fa quattro domande tipizzate a un modello decisionale “System One” su ogni prompt (argomento, complessità, rischio, dati privati) e sceglie l’LLM più economico in grado di rispondere, con un benchmark da 80 prompt;
- Jev in Home Assistant e il suo seguito: lo stesso tipo di modello che giudica le automazioni di casa mia;
- Laya contro Jev, dieci giorni dopo: nuovi modelli aperti (Von, Kev), una temperatura di confidenza e un fine-tuning di Laya sul mio MacBook.
Questo è più breve: un nuovo modello, lo stesso benchmark, lo stesso portatile.
Clef e Clef-flash in breve#
Il 1° ottobre Cloudflare ha annunciato Clef e Clef-flash, due “modelli decisionali” della stessa famiglia di Jev e Laya. Non scrivono testo. Gli si dà una domanda e uno schema (scegli una di queste opzioni, dai un punteggio, sì o no) e restituiscono una probabilità per ogni risposta ammessa. La proposta di Cloudflare è esattamente il caso d’uso di questa serie: routing, classificazione, scelta degli strumenti, smistamento, tutte quelle piccole decisioni che un agente prende prima di fare qualcosa di costoso.
Cosa c’è dentro:
- Clef si basa su un Qwen 3.8-27B congelato; Clef-flash su un Qwen 3.5-9B congelato. Entrambi aggiungono adattatori low-rank e una testa di schema congiunta: invece di generare la risposta token per token, il modello legge il prompt una volta, lascia che ogni opzione valida “guardi” il contesto rilevante e assegna un punteggio a tutte le opzioni in parallelo. Per questo l’output è sempre una delle risposte ammesse, con una probabilità, ed è veloce sull’hardware giusto.
- 64k token di contesto (il doppio dei 32k di Jev) e un encoder visivo, quindi classificano anche immagini.
- Pesi aperti con licenza Apache 2.0 su Hugging Face (Cloudflare/clef, Cloudflare/clef-flash), e ospitati su Workers AI come
@cf/cloudflare/clefe@cf/cloudflare/clef-flash. - Compatibili con l’API di Jev. Per me è la riga importante: system-one-router parla già quel formato, quindi aggiungere Clef-flash al benchmark ha voluto dire aggiungere un URL, non un adattatore.
I numeri di Cloudflare sono ambiziosi. Nel loro test di latenza su 43 valutazioni, Clef-flash risponde in 38,8 ms di mediana (122 ms al p95), Clef in 209 ms e Jev in 524 ms. Sulla qualità, riportano Clef-flash davanti a Jev nei benchmark di chiamata di strumenti e di intento (BFCL 98,8% contro 95,8%, API-Bank 93,1% contro 88,2%), e Clef davanti su BANKING77 e CLINC150, mentre Jev resta in testa su un paio (When2Call, BRIGHT). La loro tabella include anche Kev-9B e Laya, il che è apprezzabile. L’annuncio arriva insieme a un servizio di fine-tuning con reinforcement learning, prima con il supporto diretto dei loro ingegneri e poi self-service.
Questi sono i benchmark di Cloudflare, sui server di Cloudflare. I miei sono meno affascinanti: 80 prompt di routing e un MacBook M4 da 16 GB.
Gira sul mio Mac?#
Prima domanda: uno dei due modelli ci sta in memoria? Risposta breve: Clef-flash a 4 bit sì. Clef no.
| Variante | Download | Memoria di picco | Su un M4 da 16 GB? |
|---|---|---|---|
| Clef-flash, precisione piena (bf16) | ~19 GB | > 16 GB | No |
mlx-community/clef-flash-4bit | 6,2 GB | 7,0 – 8,6 GB | Sì (16 GB è il suo minimo dichiarato) |
| Clef-flash 8 bit | 10,7 GB | 11,4 – 13 GB | Rischioso: macOS concede alla GPU solo il 70–75% della RAM |
| Clef 27B, 4 o 8 bit | 16 – 30 GB | 17 – 33 GB | No, serve un Mac da 32 GB o più |
C’è una trappola, ed è meglio conoscerla prima di scaricare qualsiasi cosa. La testa decisionale che produce le risposte sta in un file separato (joint_head.safetensors). Le versioni GGUF che si trovano per Ollama o LM Studio caricano il Qwen di base senza di essa, e la pagina del modello MLX avverte che producono testo senza senso. La conversione a 4 bit di mlx-community è quella che include la testa e uno script di caricamento, clef_mlx.py, con dentro un piccolo server /v1/systemone. Altre due conversioni MLX avevano un caricatore più corto, senza server.
Come per Laya e Kev, ho letto il caricatore per intero prima di eseguirlo (786 righe, nessun codice remoto, solo safetensors) e ho saltato la cartella __pycache__ che il repository pubblica anche. Poi:
uv venv -p 3.12 clef-venv && uv pip install -p clef-venv/bin/python "mlx==0.32.3" "mlx-lm>=0.32,<0.33" \
  "mlx-vlm>=0.7.4,<0.8" huggingface_hub pillow
SNAP=$(clef-venv/bin/python -c "from huggingface_hub import snapshot_download as d; \
  print(d('mlx-community/clef-flash-4bit', ignore_patterns=['__pycache__/*']))")
clef-venv/bin/python $SNAP/clef_mlx.py serve --model $SNAP --name clef-flash --port 8792 --quiet
Un primo ticket di prova è finito in technical con confidenza 0,94. Lato benchmark, la modifica è un nuovo provider clef-flash e un’opzione -clef-url in cmd/bench, una dozzina di righe. Clef-flash ha lo stesso limite di 6.000 caratteri di stato di Jev, Von e Kev, quindi il confronto è equo.
Il benchmark: 80 prompt, Jev rilanciato la stessa sera#
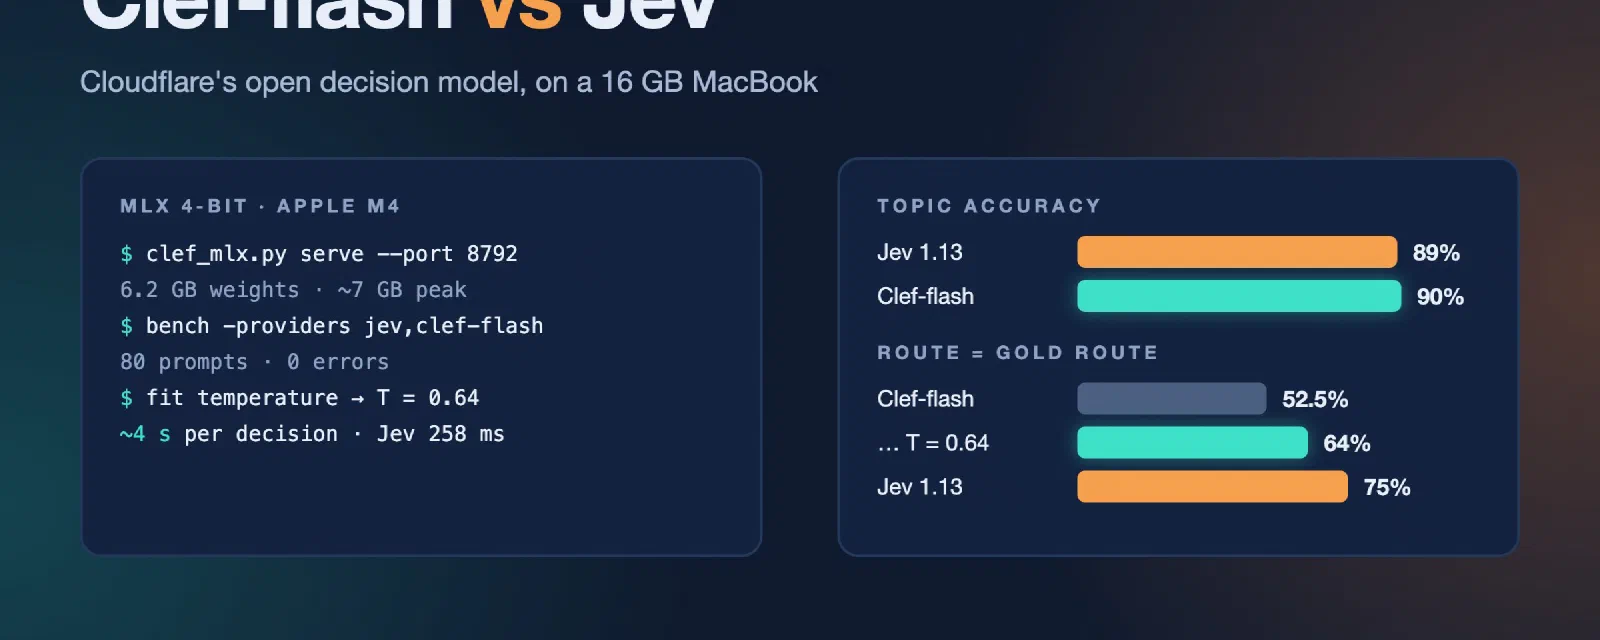
Gli stessi 80 prompt etichettati degli articoli precedenti, lo stesso router, la stessa configurazione. Jev è stato rilanciato nella stessa sessione come riferimento, quindi i suoi numeri si spostano un po’ rispetto alla tabella di ieri (75% di route identiche a quella di riferimento invece di 72%; è il rumore di un modello remoto su 80 prompt).
Questo è il riepilogo del report HTML generato dal benchmark:
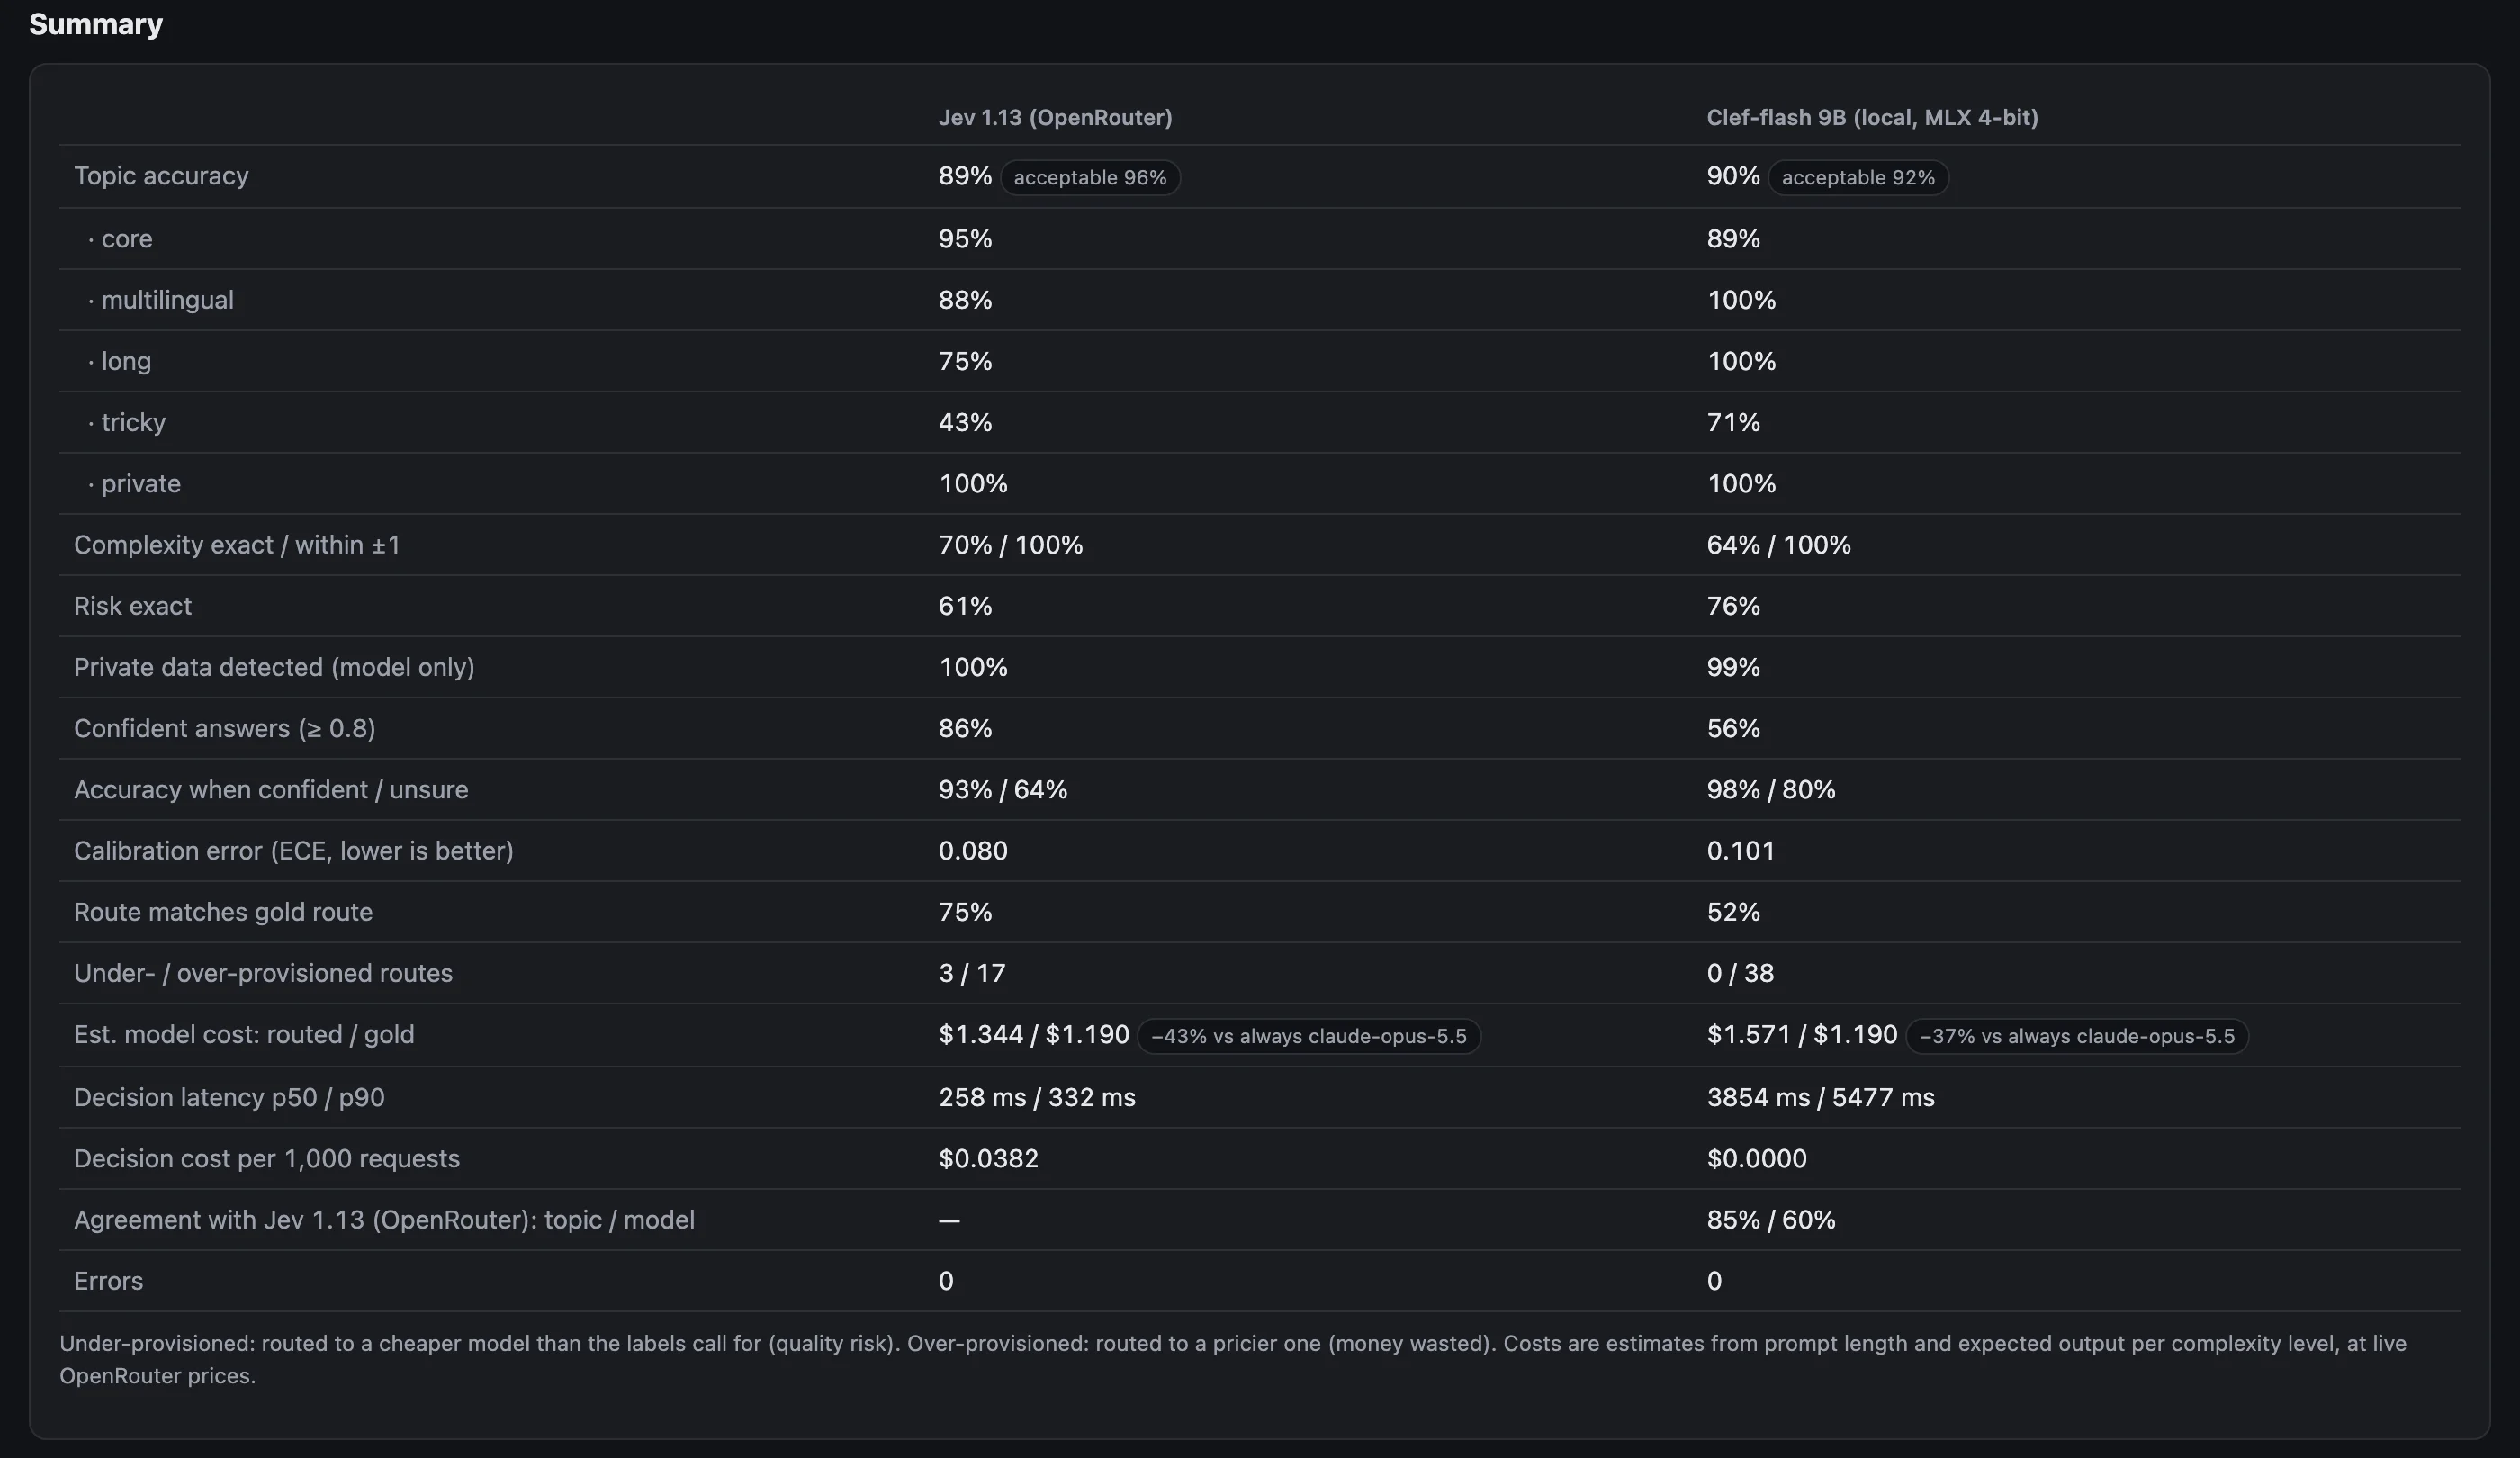
Gli stessi numeri in tabella:
| Jev 1.13 | Clef-flash 9B, MLX 4 bit | |
|---|---|---|
| Accuratezza sull’argomento | 89% | 90% |
| Argomento: core / multilingue / lunghi / trabocchetto | 95% / 88% / 75% / 43% | 89% / 100% / 100% / 71% |
| Complessità esatta / entro ±1 | 70% / 100% | 64% / 100% |
| Rischio esatto | 61% | 76% |
| Risposte sicure (≥ 0,8) | 86% (93% giuste) | 56% (98% giuste) |
| Errore di calibrazione (più basso è meglio) | 0,080 | 0,101 |
| Stessa route del riferimento | 75% | 52,5% |
| Modello più economico / più caro del riferimento | 3 / 17 | 0 / 38 |
| Costo modelli stimato (riferimento $1,19, sempre Opus $2,35) | $1,34 | $1,57 |
| Latenza di decisione p50 / p90 | 258 / 332 ms | 3.854 / 5.477 ms |
| Costo di decisione per 1.000 richieste | $0,04 | $0 |
Tre cose saltano all’occhio.
È il primo modello aperto che eguaglia Jev sull’argomento. 90% contro 89%. Laya era al 59%, Kev-0.8B all'81%. Ed è migliore di Jev proprio dove Jev è debole: 71% sui prompt “trabocchetto” (Jev 43%), 100% su quelli lunghi e multilingue. Sul rischio batte Jev di 15 punti, cosa a cui nessun altro modello zero-shot si era avvicinato. Clef-flash è d’accordo con Jev sull’argomento l'85% delle volte.
È preciso ma prudente. Solo il 56% delle sue risposte supera la soglia di confidenza di 0,8 del router. Quando è sicuro, ha ragione il 98% delle volte, meglio del 93% di Jev. Ma il mio router tratta una risposta incerta come un motivo per andare sul sicuro: alza la complessità e manda il prompt a un modello più grande. Risultato: 38 prompt finiscono su un modello più caro del necessario. Il lato positivo è che non ha mai mandato un prompt a un modello più debole del riferimento. Se proprio bisogna sbagliare, questa è la direzione giusta.
Si vede nella barra “dove andrebbero le richieste”: meno prompt sul Qwen economico, più su Sonnet e Opus.

È lento, su questo Mac. 3,9 secondi di mediana per decisione, contro i 258 ms di Jev, che gira in remoto. Ci torno più sotto.
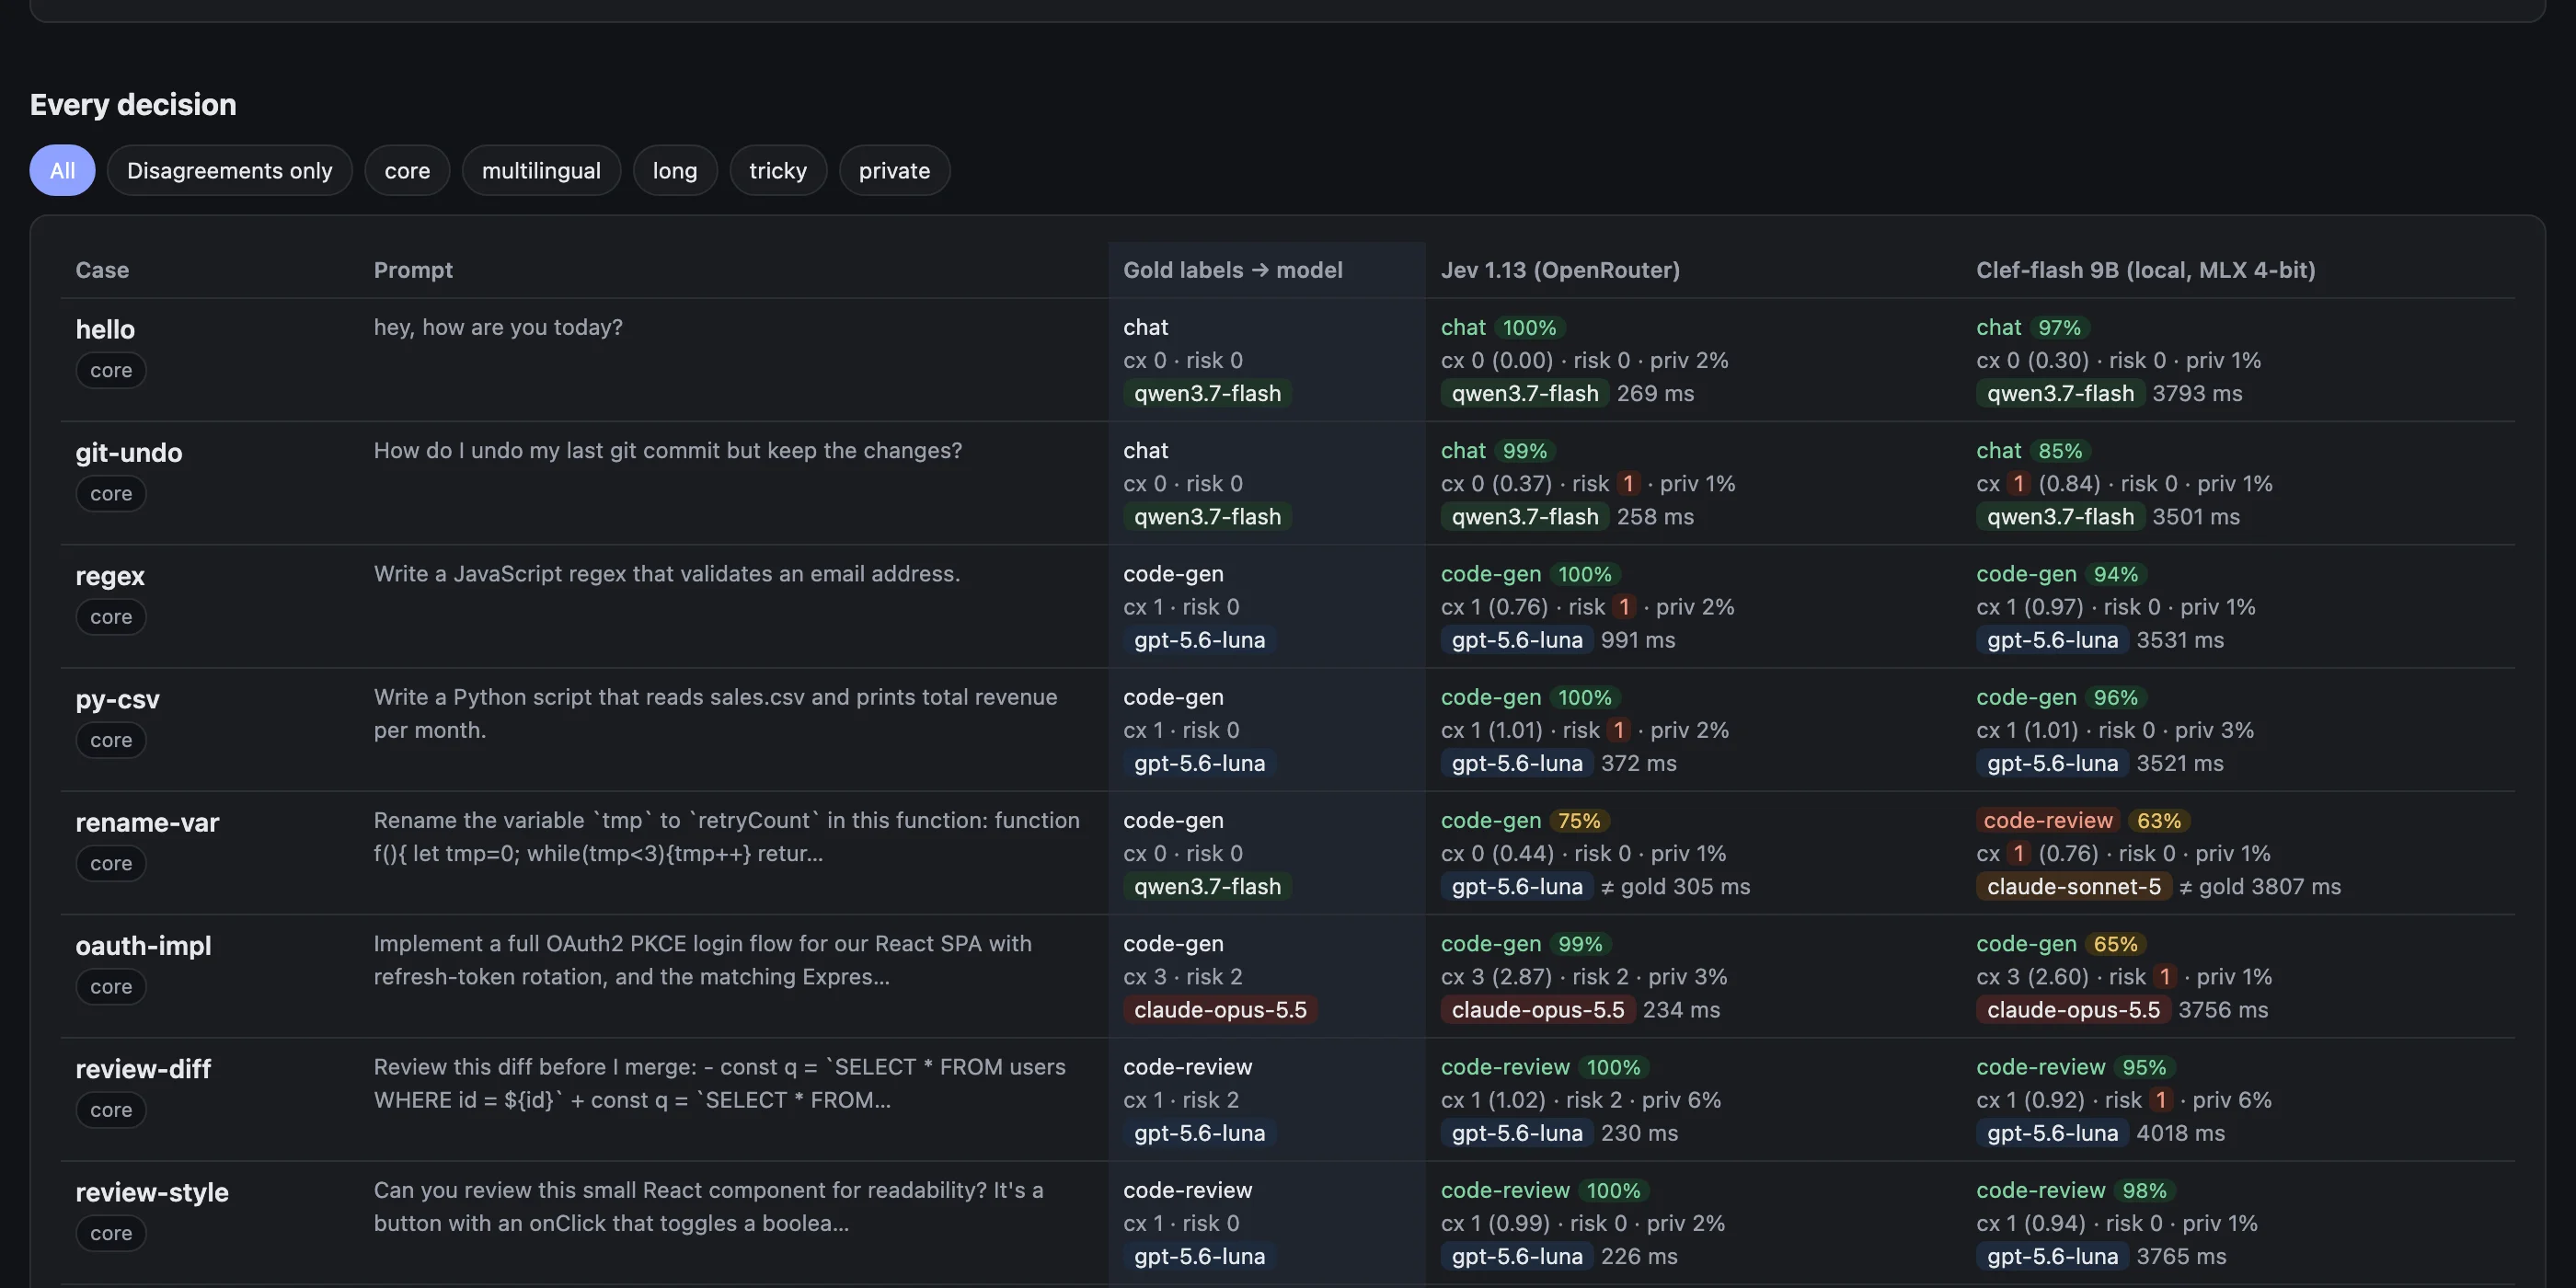
La tabella prompt per prompt del report mostra com’è questa prudenza nella pratica. Su rename-var (“rinomina la variabile tmp in retryCount in questa funzione”), l’etichetta di riferimento è code-gen, complessità 0, verso il modello più economico. Jev risponde code-gen al 75% e lo manda a gpt-5.6-luna. Clef-flash risponde code-review al 63% e, non essendo sicuro, lo manda a Claude Sonnet. Non sbagliato, ma caro per una rinomina.
Il trucco della temperatura, di nuovo#
Nell’articolo precedente avevo aggiunto una temperature opzionale per provider: dividere i logit per T prima del softmax. Non cambia mai la risposta vincente, solo quanto il modello sembra sicuro. Aveva sistemato la calibrazione di Kev, e non aveva aiutato Von.
Clef-flash sembrava il candidato perfetto: risposte giuste date con troppa poca confidenza. Stesso metodo di prima: minimizzare la log-loss su metà dei prompt, misurare sull’altra metà, 20 suddivisioni casuali. Il valore è stabile: T = 0,64 di mediana, tra 0,55 e 0,70 per la metà centrale delle suddivisioni. Sui prompt tenuti da parte, le risposte sicure passano dal 56% all'81%, e il 95% di quelle è giusto.
Poi il passaggio completo sugli 80 prompt con -temperature clef-flash=0.64:
| Clef-flash | Clef-flash, T = 0,64 | Jev 1.13 | |
|---|---|---|---|
| Accuratezza sull’argomento | 90% | 90% (invariata) | 89% |
| Risposte sicure (≥ 0,8) | 56% (98% giuste) | 78% (98% giuste) | 86% (93% giuste) |
| Errore di calibrazione | 0,101 | 0,072 | 0,080 |
| Stessa route del riferimento | 52,5% | 64% | 75% |
| Modello più economico / più caro del riferimento | 0 / 38 | 2 / 27 | 3 / 17 |
| Costo modelli stimato (riferimento $1,19) | $1,57 | $1,42 | $1,34 |
Con un solo numero, Clef-flash è ora calibrato bene quanto Jev (0,072 contro 0,080), e le route coincidono con il riferimento il 64% delle volte invece del 52,5%. Il sovradimensionamento scende da 38 a 27 prompt, con solo 2 nella direzione opposta. Come ieri, ricordate che 80 prompt sono pochi: prendete 0,64 come punto di partenza, non come valore ottimizzato.
Il divario rimanente con Jev è soprattutto la complessità: 64% esatta contro il 70% di Jev. È la stessa lezione di tutti i modelli aperti visti finora: l’argomento è risolto, e “cosa vuol dire complessità 2 nella mia configurazione” nessuna temperatura può insegnarlo.
Perché 4 secondi se Cloudflare dice 39 ms?#
Perché i numeri non misurano la stessa cosa, e la differenza viene soprattutto dall’hardware.
- Una richiesta del router è di circa 750 token: quattro domande e 19 opzioni, più il prompt. Sull’M4 la GPU impiega circa 3,6 secondi solo per leggere (il “prefill”) tutto quel testo con un modello da 9B. Una piccola richiesta da 128 token richiede comunque 0,57 s.
- La pagina del modello MLX riporta circa 0,3 s per decisione con prompt da 1k token, misurati su un M5 Max, una GPU molto più grande.
- I 39 ms di Cloudflare sono misurati sui loro server di inferenza, su Workers AI.
- E onestamente il Mac non era al massimo: durante il test aveva già 8 GB di swap per colpa di altre applicazioni.
Quindi non è un verdetto su Clef-flash, è un verdetto su un modello da 9B su un M4 base. Per confronto, Kev-0.8B rispondeva in 371 ms sulla stessa macchina, ma è dieci volte più piccolo e molto meno preciso.
Una piccola lezione lungo la strada: il primo passaggio con T = 0,64 è fallito a metà, con 49 richieste su 80 in errore. Il server Clef girava come attività in background con un limite di 30 minuti, ed è stato fermato nel mezzo del test. Ho cancellato quel report, riavviato il server con un limite più lungo e rifatto il passaggio pulito, con zero errori. Se un benchmark all’improvviso sembra brutto, guardate il numero di errori prima di leggere l’accuratezza.
Una domanda aperta: su cosa è stato addestrato?#
Nell’articolo precedente avevo tenuto solo i modelli che dichiarano di non essere stati addestrati sugli output di Jev, perché i termini di TypeSafe vietano la distillazione. La scheda di Clef-flash non dice nulla in un senso o nell’altro. Il blog di Cloudflare descrive dataset sintetici interni (ordine dei campi, prompt e strutture di schema permutati) sopra Qwen, e niente fa pensare che siano stati usati output di Jev, ma la scheda non lo scrive esplicitamente. Ho incluso il modello e segnalato la questione nella documentazione del benchmark invece di escluderlo. Se qualcuno di Cloudflare passa di qui, una riga sulla scheda del modello chiuderebbe la questione.
Dove ha senso usarlo#
- Nel percorso delle richieste, sul mio M4: no. Quattro secondi prima di ogni chiamata a un LLM non sono accettabili per un router il cui compito è far risparmiare tempo e denaro.
- Su un Mac più veloce, o su Workers AI: molto probabilmente sì. È il modello aperto più preciso che abbia testato, è calibrato con T = 0,64, legge 64k token ed è Apache 2.0. Con Workers AI è perfino un’alternativa ospitata a Jev, con un gemello a pesi aperti che si può far girare in proprio.
- Offline, già da oggi. system-one-router ha una modalità
shadowe uno strumentocmd/refitche non hanno bisogno di una risposta in tempo reale. Rietichettare di notte il traffico del giorno prima con Clef-flash è un ottimo uso di un modello lento ma preciso. - Per la casa: questa volta non ho rifatto il replay di Home Assistant. I 64k token di contesto di Clef-flash eliminano il problema che aveva escluso Laya (le mie richieste sono da 1.000 a 1.900 token), ma su un mini PC N100 un modello da 9B sarebbe molto più lento che sull’M4. Se lo provo lì, sarà tramite Workers AI, non in locale.
Cosa mi porto a casa#
- Controllate i file, non solo il nome del modello. Un modello decisionale è una base più una testa. Un GGUF che carica solo la base girerà, e risponderà a caso.
- L’accuratezza non è tutto per un router. Clef-flash batte Jev su argomento e rischio, eppure instrada peggio, perché un modello prudente fa spendere il router.
- La temperatura continua a ripagare. Kev, il Laya fine-tunato e ora Clef-flash: un numero adattato, e la calibrazione passa da “troppo timido” a “buono quanto Jev”.
- La latenza dichiarata da un fornitore è misurata sull’hardware del fornitore. 39 ms da Cloudflare, 0,3 s su un M5 Max, 3,9 s sul mio M4. Sono vere tutte e tre.
- Guardate il numero di errori prima dell’accuratezza. Un test fallito sembra esattamente un modello scarso.
Le modifiche al codice e il resoconto completo sono in mmornati/system-one-router#11, con le istruzioni di installazione in docs/benchmark.md. Il report pubblicato mostra ancora il test a sette provider dell’articolo precedente; aggiungerò Clef-flash al prossimo passaggio completo. Se fate girare Clef-flash su un Mac più grande, o Clef su Workers AI, mi piacerebbe molto vedere i vostri numeri di latenza nei commenti.
Come è stato fatto#
Stesso metodo del resto della serie: una sessione di Claude Code con Opus 5.5. Ho chiesto se il nuovo modello di Cloudflare potesse girare su questo Mac; l’agente ha verificato l’hardware, confrontato le conversioni disponibili, individuato la trappola della testa mancante nei GGUF, letto il caricatore MLX prima di eseguirlo, aggiunto il provider, lanciato i benchmark, adattato la temperatura e aperto la pull request. La mia parte: scegliere la versione a 4 bit, chiedere l’adattamento della temperatura e decidere cosa tenere.