Un mese fa ho chiuso l’articolo su VegaML con la solita promessa: il prossimo candidato entra nel benchmark. Ma nel mondo “System One” un mese è lungo. Quindi questa volta non ho aspettato che un modello comparisse nel mio feed. Ho aperto una sessione di Claude Code sul repository di system-one-router e ho fatto una domanda semplice: c’è qualche nuovo modello System One da testare? Una nuova versione di Laya che valga un nuovo test?
Questo è il sesto articolo della serie. Se arrivate qui adesso:
- system-one-router: un gateway in Go che fa quattro domande tipizzate a un modello decisionale “System One” su ogni prompt (argomento, complessità, rischio, dati privati) e sceglie l’LLM più economico in grado di rispondere, con un benchmark da 80 prompt;
- Jev in Home Assistant e il suo seguito: lo stesso tipo di modello che giudica le automazioni di casa mia;
- Laya contro Jev, dieci giorni dopo: Von, Kev-0.8B, una temperatura di confidenza e un fine-tuning di Laya;
- Clef-flash contro Jev: il modello da 9B di Cloudflare, il primo modello aperto a eguagliare Jev sull’argomento;
- Laya 0.4.2 e VegaML: otto release di Laya con risposte identiche, e un modello decisionale che fa rotolare una pallina giù da una collina.
La risposta alla mia domanda: nessun nuovo modello Laya, ma è uscito Jev 1.14, e Kev-4B ora entra (a fatica) nel mio M4 da 16 GB. Sono i due test di questo articolo. Prima, però, un giro di quello che si è mosso in un mese, perché si è mosso parecchio, anche dove non serviva un benchmark.
Un mese di “System One”: cosa è cambiato#
Laya: 28 release, stessi pesi#
Laya è passato dalla 0.4.2 alla 0.4.30 tra l'11 ottobre e l'8 novembre: 28 release in quattro settimane. La prima cosa che ho controllato, come mi ero ripromesso nelle lezioni dell’ultimo articolo, sono stati i pesi. I tre file model.safetensors su Hugging Face (convaiinnovations/laya) sono ancora del 18 e 19 settembre. L’unico commit sull’Hub dal mio ultimo test è di stamattina, e aggiunge solo la citazione di un preprint in cima alla scheda del modello (DOI 10.20944/preprints202611.0781.v1). Quindi ora Laya è anche un articolo scientifico, il che fa piacere, ma i checkpoint sono quelli che ho già misurato tre volte.
Tre aggiornamenti di fila (0.3.6 → 0.3.24 → 0.4.2) hanno dato decisioni identiche su tutti gli 80 prompt. Con i pesi invariati, la 0.4.30 farebbe quasi certamente lo stesso, quindi non ho passato una serata a dimostrarlo. È il primo “no” di questo articolo, ed è un “no” utile.
Quello che è cambiato nel runtime, però, è interessante, anche se non sposta i miei numeri:
- Laya ora include VegaML.
Agent(vegaml=True)mette il motore fisico di VegaML dietro l’API di Laya, con delle policy addestrate sopra. I due modelli dello stesso autore stanno convergendo in un unico toolkit. - Una correzione al fine-tuning da conoscere. Nella 0.4.30, un’etichetta sì/no di riferimento pari a
1.0veniva addestrata comefalsenel percorso di VegaML. Ora le etichette vengono lette come nel fine-tuning di Laya stesso, un’etichetta non associata a nessuna domanda viene rifiutata, e un numero non finito restituito dal motore viene rifiutato prima che possa diventare una decisioneautosicura. Se avete adattato teste VegaML tramite Laya con booleani numerici, rifatelo. - Hook ovunque.
on_predict_start,on_predict_endeon_errorora girano anche sull’agente VegaML, come su tutte le altre superfici di Laya. - Video. I tempi dei frame ora indicano il frame da cui viene ogni risposta, e sono spariti alcuni crash sui clip senza durata.
Niente di tutto questo tocca i quattro checkpoint usati dal mio sidecar. Se rifarò il fine-tuning di Laya, sarà con la CLI ufficiale laya-train, e quello sarà il momento di aggiornare.
VegaML: dalla 0.8 alla 0.16.1, “un motore, qualsiasi lettore”#
VegaML si è mosso più velocemente di Laya: 0.8.0 → 0.16.1 in un mese. Il grosso cambiamento è vega-U: il motore fisico da 14M di parametri non è più legato a Qwen3.5. Lo si può agganciare a un altro modello linguistico (il “lettore”), dandogli da 100 a più di 1.000 testi del proprio dominio, senza riaddestrare nulla. Poi lo si calibra con i propri esempi etichettati. Ha anche guadagnato input audio e video, e delle policy addestrate.
È una direzione furba, ma VegaML era debole in zero-shot sulle mie domande di routing (51% sull’argomento). L’unico esperimento che varrebbe la pena di ripetere è quello delle teste few-shot, e per questo giro l’ho saltato.
Von è archiviato#
Il 19 ottobre, la scheda Hugging Face di Von è stata segnata come archiviata, e ora rimanda a d1-omni-600M di LiquidAI. Von 1.3 era, tra i modelli piccoli, quello aperto con più route identiche al riferimento senza alcun adattamento (48%), ma era troppo sicuro di sé. Resta nelle mie tabelle come riferimento, ma non avrà nuove versioni.
LiquidAI entra in gioco: la famiglia d1#
È il nuovo arrivato più serio del mese. LiquidAI ha pubblicato un’intera famiglia di modelli decisionali: d1-3B e d1-omni-600M il 5 ottobre, poi d1-2B e d1-Omni-2B il 24 ottobre. d1-2B è costruito su LFM3-VL-2B, legge testo, immagini e video, parla 16 lingue, e la scheda dichiara 5,7 ms per decisione su una H100, con un numero qualsiasi di domande su uno stesso stato in un’unica chiamata. Gira su Apple Silicon tramite Transformers.
Due riserve l’hanno tenuto fuori da questo giro: la licenza è la LFM Open License v1.0, non Apache-2.0, e la scheda non dice se gli output di Jev fossero nei dati di addestramento. Richiede anche un piccolo sidecar, come VegaML. È il primo candidato per il prossimo test.
Il resto del panorama#
- vllm-sr d3 (Apache-2.0): d3-mini, d3-flash e d3-turbo vanno forte nelle classifiche pubbliche sulle decisioni, ma d3-mini da solo (4,5B) arriva a un picco di 14,8 GiB in bf16 secondo la sua scheda. Non su un portatile da 16 GB.
- Clef e Clef-flash: nessun nuovo peso, solo risultati di valutazione aggiunti alle schede.
- autotrust JEV-*: i modelli “System One” più scaricati e con più like su Hugging Face, e addestrati sugli output di Jev. Stessa regola di prima: non faccio benchmark di Jev distillato, perché i termini di TypeSafe lo vietano.
- L’alluvione. Cercando su Hugging Face i tag
system-oneodecision-modelora escono decine di nuovi repository al giorno:zils-*,OneJev, fine-tuning*-jev-*, conversioni GGUF. La maggior parte ha zero download. A settembre i candidati si contavano sulle dita di due mani.
Jev 1.14#
E poi quello che per me conta di più, perché Jev è il mio provider in produzione: TypeSafe ha pubblicato Jev 1.14 su OpenRouter. typesafe/jev-1.13 è ancora disponibile, e ~typesafe/jev-latest ora punta alla 1.14. La novità principale è un nuovo tipo di domanda, box: si dà a Jev un’immagine, gli si chiede di trovare un oggetto, e risponde con i quattro lati di un riquadro (la 1.13 rifiuta la richiesta con un 400). Il contesto è di 262.144 token.
Il mio router non manda immagini, quindi il box non conta. La vera domanda è se argomento, complessità e rischio cambiano da una versione all’altra. E misurarlo costa poco: 80 prompt costano circa $0,04.
Test 1: Jev 1.14 contro 1.13#
config.yaml fissa typesafe/jev-1.13. Il benchmark ora accetta qualsiasi jev-<versione> come nome di provider, quindi le due versioni girano affiancate, sugli stessi prompt, la stessa sera, attraverso lo stesso router:
go run ./cmd/bench -providers jev-1.13,jev-1.14Un modello remoto non è perfettamente deterministico, quindi l’ho lanciato due volte per capire quanta parte della differenza sia solo rumore.
| Jev 1.13 (test 1 / test 2) | Jev 1.14 (test 1 / test 2) | |
|---|---|---|
| Accuratezza sull’argomento | 87,5% / 88,8% | 87,5% / 87,5% |
| Complessità esatta / entro ±1 | 70% / 71% · 100% | 69% / 69% · 100% |
| Rischio esatto | 60% / 60% | 65% / 66% |
| Risposte con confidenza ≥ 0,8 | 86% / 86% (93% giuste) | 81% / 80% (95–97% giuste) |
| Errore di calibrazione (ECE) | 0,088 / 0,099 | 0,072 / 0,059 |
| Route = riferimento | 71% / 74% | 71% / 70% |
| Modello più economico / più caro del riferimento | 5 / 18 · 3 / 18 | 3 / 20 · 3 / 21 |
| Costo stimato dei modelli (riferimento: $1,18) | $1,31 / $1,35 | $1,47 / $1,48 |
| Latenza di decisione p50 | 221 / 207 ms | 199 / 192 ms |
Le due versioni concordano sull’argomento per il 95–96% dei prompt e sul modello scelto per l'84–86%. Quindi non è un modello diverso, è un affinamento. E l’affinamento va in due direzioni contemporaneamente:
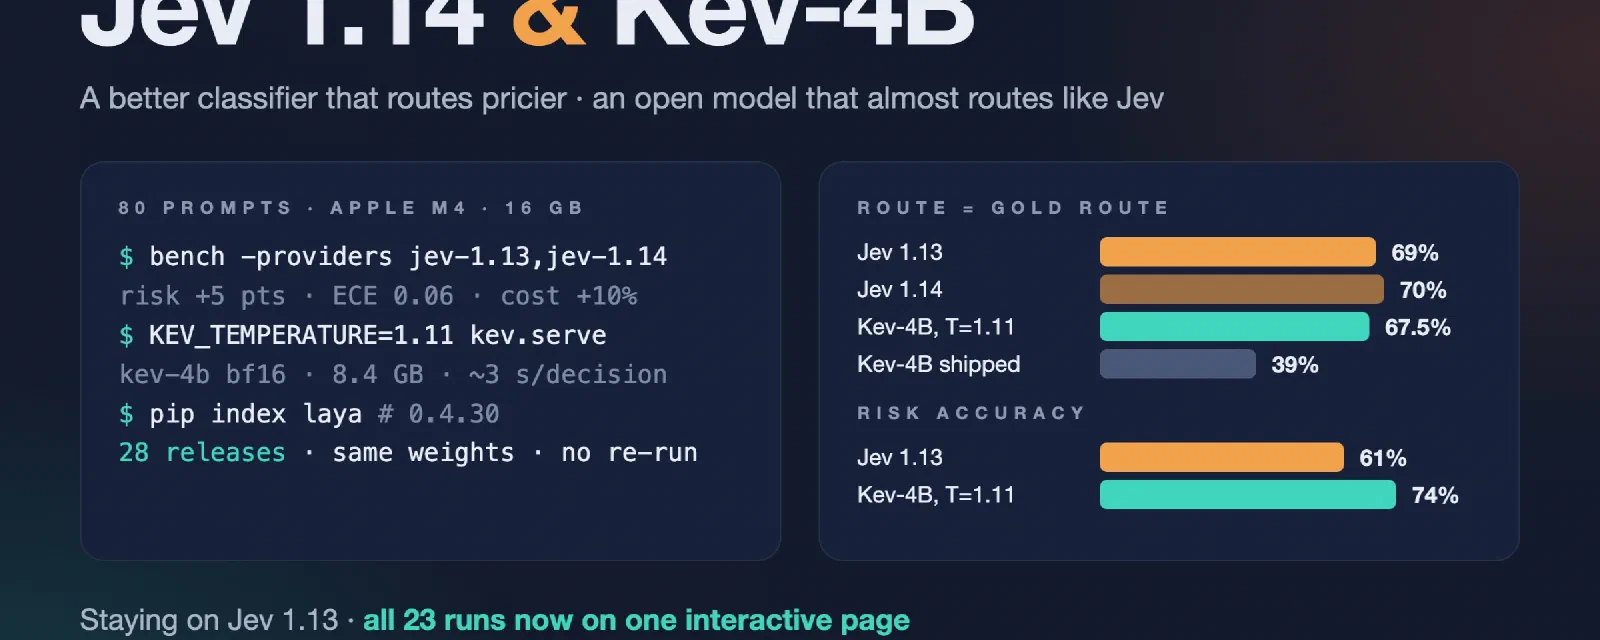
- La 1.14 è il classificatore migliore. +5 punti sul rischio in entrambi i test, un errore di calibrazione più basso in entrambi i test, e una risposta un po’ più veloce. Argomento e complessità non si muovono.
- Ma sceglie modelli più cari di circa il 10%. È sicura meno spesso (l'80–81% delle risposte supera la mia soglia di 0,8, contro l'86%), e quando non è sicura il mio router va sul sicuro e alza la soglia di qualità. Sposta anche qualche prompt dalla complessità 2 alla 3.
È solo la mia soglia a essere troppo severa per un modello meglio calibrato? Ho rilanciato entrambe le versioni con la soglia a 0,7 e a 0,6:
| Soglia di confidenza | Jev 1.13 costo / route = riferimento | Jev 1.14 costo / route = riferimento |
|---|---|---|
| 0,8 (attuale) | $1,31–1,35 / 71–74% | $1,47–1,48 / 70–71% |
| 0,7 | $1,32 / 75% | $1,44 / 70% |
| 0,6 | $1,28 / 76% | $1,43 / 72,5% |
No. La 1.14 resta più cara con qualsiasi soglia, e la 1.13 resta ogni volta più vicina al riferimento.
Poi, prompt per prompt: dove le due versioni scelgono un modello diverso? Su 13 prompt nel primo test e 11 nel secondo, e la 1.14 sceglie il modello più caro rispettivamente su 9 e 8 di questi. Le ragioni sono miste: complessità che sale da 2 a 3 (a volte a ragione, a volte no), confidenza sull’argomento che scende sotto la soglia (0,92 → 0,69, 0,82 → 0,59), un rischio da 1 a 2. Una dozzina di prompt su 80: è una tendenza, non una misura. Ma la tendenza è la stessa in entrambi i test.
Decisione: per ora resto sulla 1.13. Un punteggio di rischio migliore fa piacere, ma il mio router non paga per l’accuratezza sul rischio, paga per le route. Ricontrollerò la 1.14 quando cmd/refit avrà abbastanza dati reali sugli esiti per dire se la sua prudenza in più valeva la pena, perché magari quelle route più care erano quelle giuste.
Una scoperta collaterale sul rischio#
Guardando i punteggi di rischio, Claude ha notato che entrambe le versioni di Jev tendono a stare sopra le mie etichette: in media, il punteggio di rischio grezzo è circa 0,53 sopra la mia etichetta. Il router sottrae un risk_offset fisso di −0,3 prima di arrotondare. Con −0,5, l’accuratezza sul rischio salirebbe a circa l'80% per entrambe le versioni.
Non l’ho cambiato. Con −0,5, per il rischio 2 servirebbe un punteggio grezzo di esattamente 2,0: funziona su questi 80 prompt per come capitano a cadere i loro punteggi, ed è la definizione stessa di overfitting. Un dettaglio divertente: la prima analisi diceva che −0,5 era molto meglio di −0,4 e −0,6, il che sembrava sospetto. Il motivo era l’arrotondamento: Python arrotonda la metà al pari, Go arrotonda la metà lontano dallo zero. Ricontrollato con l’arrotondamento di Go, −0,5 resta il migliore, ma con meno margine.
Test 2: Kev-4B su un Mac da 16 GB#
Kev, di Jared Palmer, è una LoRA più una pointer head sopra un modello base Qwen3.5. Kev-0.8B era il miglior piccolo classificatore aperto sull’argomento della serie (81%, e 100% sui prompt multilingue), ma debole su complessità e rischio. Kev-4B è la taglia consigliata, e nella mia documentazione avevo scritto che serviva un Mac da 32 GB. La sessione ha trovato due modi per provarlo lo stesso: una conversione MLX a 4 bit da 3 GB di un altro autore, oppure il server di Kev stesso, che su Apple Silicon usa MLX in automatico.
Ho scelto il server di Kev, in bf16, perché parla direttamente il mio formato /v1/systemone, senza adattatori:
git clone https://github.com/jaredpalmer/kev.git && cd kev && uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --host 127.0.0.1 --port 8794
go run ./cmd/bench -providers jev,kev-4b
(Claude non è riuscito a clonare e installare Kev da solo: il controllo dei permessi ha bloccato l’esecuzione di codice esterno, che è esattamente quello che deve fare. L’installazione l’ho autorizzata io.)
“Ci sta” nel senso che gira: 8,4 GB di pesi in bf16 su una macchina da 16 GB che fa girare anche un browser, un IDE e un benchmark in Go. Il Mac è rimasto in swap per circa 4–6 GB tutto il tempo. La prima richiesta ha richiesto 143 secondi (caricamento più riscaldamento), poi 44 s, 6,9 s, 3,4 s… fino a circa 2,6–3 secondi per decisione una volta a regime.
Tre modi di leggere la confidenza di Kev#
Kev ha una sua calibrazione: una temperatura T = 2,41, adattata sul suo insieme di sviluppo. Sulle mie domande è decisamente troppo prudente. Quindi Kev-4B ha girato tre volte:
- Così com’è;
- Con la mia solita temperatura lato client, adattata come per gli altri modelli (minimizzare la log-loss su metà dei prompt, misurare sull’altra metà, 20 suddivisioni casuali). Lo script ha prima riprodotto il valore documentato di Kev-0.8B (0,46 contro 0,47), per assicurarsi che il metodo fosse lo stesso. Per Kev-4B ha dato T = 0,46;
- Con la temperatura dentro il server di Kev:
KEV_TEMPERATURE=1.11, cioè 2,41 × 0,46. Spiego la differenza più sotto.
| Jev 1.13 | Kev-0.8B | Kev-4B | Kev-4B, T = 0,46 | Kev-4B, KEV_TEMPERATURE=1.11 | |
|---|---|---|---|---|---|
| Accuratezza sull’argomento | 89% | 81% | 86% | 86% | 86% |
| Argomento: core / multilingue / lunghi / trabocchetto | 95% / 88% / 75% / 43% | 89% / 100% / 75% / 43% | uguale | uguale | |
| Complessità esatta / entro ±1 | 70% / 100% | 42% / 98% | 51% / 99% | uguale | 55% / 98% |
| Rischio esatto | 61% | 49% | 61% | 61% | 74% |
| Risposte con confidenza ≥ 0,8 | 85% (94% giuste) | 5% | 19% (100% giuste) | 74% (95% giuste) | 74% (95% giuste) |
| Errore di calibrazione (ECE) | 0,067 | 0,349 | 0,280 | 0,080 | 0,084 |
| Route = riferimento | 69% | 22% | 39% | 61% | 67,5% |
| Modello più economico / più caro del riferimento | 5 / 20 | 4 / 58 | 3 / 46 | 14 / 17 | 11 / 15 |
| Costo stimato dei modelli (riferimento: $1,18) | $1,33 | $1,16 | $1,13 | $0,70 | $0,87 |
| Latenza di decisione p50 / p90 | 211 / 278 ms | 371 ms | 2.565 / 12.510 ms | 2.699 / 3.308 ms | 2.979 / 6.386 ms |
Così com’è, Kev-4B è già un bel salto rispetto a Kev-0.8B: +5 punti sull’argomento, +12 sul rischio (alla pari con Jev), tutti i prompt multilingue giusti. Concorda con Jev sull’argomento il 90% delle volte. Ma solo il 19% delle risposte supera la soglia di 0,8 (e sono tutte giuste!), quindi il router non si fida e sovradimensiona 46 prompt. La stessa storia “giusto ma timido” di Kev-0.8B.
Con la mia temperatura (T = 0,46), il 74% delle risposte diventa sicuro, ancora giuste al 95%, l’ECE scende a 0,080 e le route uguali al riferimento saltano dal 39% al 61%. Ma succede una cosa nuova: il router ora sottodimensiona 14 prompt (Jev: 5). Il costo stimato scende a $0,70, sotto gli $1,18 del riferimento. Costare meno della risposta giusta non è una vittoria, è un rischio di qualità.
Perché? Guardate complessità e rischio. Kev-4B schiaccia le risposte verso il centro: 17 dei 21 prompt banali escono con complessità 1, 8 dei 10 prompt da esperti sotto il 3, e 15 dei 16 prompt ad alto rischio con rischio 1. Finché il router non si fidava dell’argomento, non contava, perché alzava comunque la soglia. Appena si fida dell’argomento, sono questi punteggi schiacciati al centro a decidere la soglia, e i prompt da esperti finiscono su modelli troppo economici.
La soluzione: mettere la temperatura dove stanno i punteggi#
Ecco il dettaglio che mi era sfuggito per un mese. La temperature del mio router riscala solo le risposte di tipo choice (l’argomento). Complessità e rischio sono score, quindi tenevano le distribuzioni piatte di Kev a T = 2,41, e una distribuzione piatta su 0–3 ha il valore atteso vicino al centro. Ecco lo schiacciamento.
Kev legge KEV_TEMPERATURE all’avvio, e la applica a tutte le risposte. Quindi ho riavviato il server con 2,41 × 0,46 = 1,11 e ho lanciato il benchmark senza temperatura lato client:
- Le risposte sull’argomento sono le stesse che con T = 0,46 (stesse probabilità, applicate in un punto diverso);
- Il rischio salta dal 61% al 74%, davanti al 61% di Jev: 8 dei 16 prompt ad alto rischio ora vengono letti come rischio 2 invece di 1;
- I prompt da esperti letti come complessità 3 passano da 2 su 10 a 6 su 10;
- Le route uguali al riferimento arrivano al 67,5% (Jev nella stessa sessione: 69%), con 11 prompt sottodimensionati invece di 14.
È il modello aperto che si è avvicinato di più a Jev nel routing in questa serie, e la prima volta che un modello aperto batte Jev sul rischio e quasi lo eguaglia sulle route allo stesso tempo (Clef-flash batteva Jev sul rischio, ma era al 64% di route).
Non è un valore ottimizzato, però: 0,46 è stato adattato solo sulle risposte sull’argomento. E la complessità resta il punto debole: i prompt banali vengono ancora letti come complessità 1 (16 su 21), ed è la maggior parte della distanza che resta da Jev.
Il rovescio della medaglia: tre secondi, e un timeout#
Il primo test con KEV_TEMPERATURE=1.11 ha perso quattro prompt (tre dei quali lunghi) per il timeout lato client di 60 secondi del benchmark, mentre il Mac era a circa 6 GB di swap. Visto che questo test misura la qualità delle decisioni, non la latenza, il benchmark ora dà 180 secondi a Kev-4B, e la tabella mostra il test ripetuto senza errori. Ma racconta la storia vera: 2,6–3 s di p50 e fino a 12,5 s di p90 non sono qualcosa da mettere davanti a ogni richiesta su questa macchina. La versione a 4 bit da 3 GB dovrebbe evitare lo swap. È la prossima cosa da provare.
Tutti i modelli finora#
Stessi 80 prompt, stesso router, serate diverse. La tabella completa, con tutte le metriche e una vista prompt per prompt, è sulla pagina dei risultati.
| Modello (M4 da 16 GB salvo se ospitato) | Argomento | Rischio | Route = riferimento | ECE | Latenza p50 |
|---|---|---|---|---|---|
| Jev 1.13 (ospitato, fissato) | 87,5–89% | 60–61% | 69–75% | 0,067–0,099 | 207–364 ms |
| Jev 1.14 (ospitato) | 87,5% | 65–66% | 70–71% | 0,059–0,072 | 192–199 ms |
| Clef-flash 9B 4 bit, T = 0,64 | 90% | 76% | 64% | 0,072 | 4.017 ms |
Kev-4B bf16, KEV_TEMPERATURE=1.11 | 86% | 74% | 67,5% | 0,084 | 2.979 ms |
| Laya fine-tunato (480 etichette), T = 0,87 | 85% | 69% | 64% | 0,082 | 319 ms |
| Kev-0.8B, T = 0,47 | 81% | 49% | 39% | 0,059 | 355 ms |
| Von 1.3 (archiviato) | 70% | 46% | 48% | 0,226 | 202 ms |
| Laya typed-decisions | 71% | 34% | 14% | 0,509 | 304 ms |
| VegaML 0.8B, few-shot (40 etichette), T = 0,72 | 65% | 64% | 42,5% | 0,138 | 862 ms |
| Laya inglese (0.3.6 = 0.3.24 = 0.4.2) | 59% | 31% | 21% | 0,171 | 282 ms |
| VegaML 0.8B, zero-shot, T = 0,60 | 51% | 54% | 20% | 0,092 | 1.337 ms |
Una pagina per tutto#
Finora l’unica vista interattiva era il report HTML di un singolo test, pubblicato sulle GitHub Pages del progetto, e mostrava ancora il test a sette provider di inizio ottobre. Ogni articolo aggiungeva un nuovo modello in una tabella markdown, e i risultati vivevano in file JSON sparsi in cinque worktree git.
Quindi, come avevo fatto per l’analisi del fotovoltaico, i risultati ora hanno una loro pagina su questo blog: /system-one-benchmark/. È costruita a partire dai file grezzi del benchmark (23 test, dal 2 ottobre al 9 novembre), con delle schede per:
- Classifica: tutti i modelli e le configurazioni, ordinabili per qualsiasi metrica, con un grafico argomento contro routing;
- Jev 1.14 contro 1.13: i quattro test, la variazione della soglia e i prompt su cui le due versioni scelgono modelli diversi;
- Kev-4B: le tre impostazioni di temperatura, con le matrici di confusione di complessità e rischio che mostrano lo “schiacciamento”;
- Temperature: cosa ha fatto una temperatura adattata per ciascun modello;
- Esploratore dei prompt: gli 80 prompt con le loro etichette, e due test qualsiasi affiancati, con le risposte sbagliate evidenziate;
- Ecosistema: la cronologia della serie e dei modelli che ho controllato ma non testato.
Dove ha senso usarli#
- Jev 1.14: risposte migliori, route più care. Resto sulla 1.13 finché i dati sugli esiti non diranno altrimenti. Attenzione:
jev-latestpunta già alla 1.14, quindi fissate la versione se vi interessa la stabilità dei costi. - Kev-4B: il miglior modello aperto per il mio router, sulla carta. 86% sull’argomento, 74% sul rischio, 67,5% di route uguali al riferimento, Apache-2.0, multilingue. Su un Mac da 16 GB, a 3 secondi per decisione, è uno strumento per l’elaborazione batch, non da mettere nel percorso delle richieste. Su un Mac da 32 GB o una piccola GPU, è il primo modello aperto che proverei seriamente in produzione.
- Laya: nessun nuovo test necessario. Il runtime continua a migliorare, e sta diventando un toolkit (con VegaML dentro). Per me, il prossimo passo con Laya è un fine-tuning con
laya-train. - Prossimi candidati: d1-2B di LiquidAI (dopo aver letto la licenza), Kev-4B a 4 bit, e forse di nuovo le teste few-shot di VegaML sul nuovo motore vega-U.
Lezioni imparate#
- Controllate prima i pesi, di nuovo. 28 release di Laya, e una chiamata di due righe all’API di Hugging Face mi ha detto che non c’era niente da misurare. Mi ha risparmiato una serata.
- Lanciate due volte un modello remoto. Jev 1.13 si è spostato di 2,5 punti sulle route uguali al riferimento tra due test a dieci minuti di distanza. Senza il secondo test, non avrei potuto dire se le differenze della 1.14 erano reali.
- Un classificatore migliore non è un router più economico. La 1.14 vince su rischio e calibrazione, e costa comunque il 10% in più, perché il comportamento del router dipende da quanto spesso il modello è sicuro, non solo da quanto ha ragione.
- Mettete la temperatura dove sta l’incertezza. Una temperatura lato client applicata solo alle risposte di tipo choice ha sistemato solo l’argomento, e ha fatto sottodimensionare Kev-4B. La stessa temperatura, applicata dal server a tutte le risposte, ha sistemato anche il rischio. Il punto in cui si calibra conta quanto il valore.
- “Più economico del riferimento” è un bug, non una funzionalità. Un costo di routing sotto quello della route di riferimento vuol dire che alcuni prompt hanno ricevuto un modello troppo debole per loro.
- I modelli limitati dalla memoria richiedono benchmark pazienti. Lo swap ha trasformato un modello da 3 secondi in uno da 12 secondi al p90, con quattro timeout. Misurate la qualità con timeout generosi, e la latenza a parte.
- L’ecosistema sta esplodendo. Da una manciata di nomi a settembre a decine di repository al giorno. Un benchmark fisso, con le mie etichette, è l’unico modo che ho trovato per non farmi travolgere.
Il codice e il resoconto completo sono in mmornati/system-one-router#13, con le istruzioni in docs/benchmark.md. Se fate girare Kev-4B su un Mac più grande, o la versione a 4 bit, mi piacerebbe molto vedere la vostra latenza nei commenti.
Come è stato fatto#
Una sessione di Claude Code con Opus 5.5 sul repository di system-one-router. Gli ho chiesto se ci fosse un nuovo modello System One o una nuova versione di Laya da testare, mantenendo lo stesso benchmark. Ha controllato PyPI, Hugging Face e OpenRouter, confrontato le date dei pesi di Laya, letto le schede di una dozzina di candidati, ed è tornato con una lista ordinata: prima Jev 1.14 e Kev-4B, poi LiquidAI d1, gli altri scartati con le loro ragioni. Ho scelto “Jev 1.14 + Kev-4B”. Ha aggiunto i provider al benchmark, lanciato Jev due volte, fatto variare la soglia, trovato la trappola dell’arrotondamento tra Python e Go, e scritto la documentazione. Per Kev-4B ha chiesto prima di clonare e installare codice esterno, poi ha fatto girare le tre configurazioni e suggerito la temperatura lato server, che ho avviato io. Per questo articolo, una seconda sessione ha letto quella trascrizione e i file grezzi dei risultati, scritto il testo e costruito la pagina dei risultati. La mia parte è stata scegliere cosa testare, e avviare i server.