Il mio articolo precedente raccontava come ho collegato Jev, il modello decisionale di TypeSafe, a Home Assistant per rispondere alla domanda “è normale?” che le mie automazioni a soglia non sanno gestire: la pompa di sollevamento gira a lungo perché ha piovuto, o perché il galleggiante è bloccato; l’acqua scorre per una doccia, o per una perdita. La regola calcola sempre la sua risposta, Jev si limita a consigliare, e tutto è partito in modalità shadow, così potevo leggere i disaccordi prima di fidarmi.
Quell’articolo si è preso un commento su Mastodon che meritava più di una risposta. Grazie a OneClickClaw per averlo scritto:
@mmornati Feed the last few hours of readings to a small local model, it gets the context.
Domanda legittima. I miei prompt erano davvero degli istantanei - umidità adesso, flusso adesso - e per qualche secondo una doccia e una perdita lenta possono sembrare identiche. Questo articolo racconta cosa ho fatto, e non è quello che suggeriva il commento. Ho guardato seriamente all’idea di far girare qualcosa in locale, ho deciso di no, e ho scoperto che il vero problema non aveva niente a che fare con quale modello risponde alla domanda.
Perché non un modello locale piccolo, sul mio hardware#
La casa che ho descritto l’ultima volta gira ancora sulla stessa scatoletta di cui ho già parlato su questo blog: un N100, 4 core, 16 GB di RAM, niente GPU. Ci gira già sopra Home Assistant Core, il database del recorder, Zigbee2MQTT e tutto il resto che HAOS porta con sé. Non c’è un acceleratore di scorta che se ne sta lì con le mani in mano, e non c’è una seconda scatoletta che vorrei dedicare solo a questo.
Nell’articolo sul router che ha fatto partire tutta questa storia, avevo benchmarkato Laya, un modello open weights costruito apposta per questo tipo di decisione tipizzata, e i numeri rispondevano già alla domanda che mi sarei fatto adesso: su una GPU Apple è veloce, ma su una CPU da Raspberry - e un N100 è più vicino a quella che a una scatola con GPU - mettete in conto da 1,5 a 3 secondi a chiamata. Le mie decisioni scattano ogni 5 minuti solo per la VMC, parecchie girano in parallelo (mode: parallel apposta, così un trigger che sbatte su e giù non resta in coda dietro a una chiamata lenta), e alcune condividono la scatoletta con il coordinatore Zigbee che dovrebbe reagire a un pulsante in tempo reale. Qualche secondo di contesa sulla CPU, sei volte all’ora, per sempre, non è un arrotondamento su 4 core - è una tassa su quello che la scatoletta deve davvero fare.
Ed è già così per un modello pensato per essere piccolo. Caricare anche solo un LLM generico distillato (un Llama o un Qwen piccoli) aggiunge qualche gigabyte di RAM che se ne sta lì fermo, su una macchina dove 16 GB sono tutto il budget, non un margine. I conti dell’articolo scorso lo dicevano già chiaramente: il locale ha senso solo sul suo hardware, e comprare un secondo mini PC per risparmiare 3 $ l’anno non è uno scambio serio.
La parte che sarebbe stata sbagliata anche con un hardware migliore#
Ecco la cosa che ho capito solo controllando i numeri: l’idea del modello locale dava per scontato che il problema fosse l’intelligenza di Jev. Non lo era. Jev ha una finestra di contesto da 32k token e ne stavo usando circa 565. Il tetto non è mai stato il modello - era che gli mandavo solo il valore attuale. Un modello locale piccolo con una finestra da 512 token avrebbe sbattuto contro lo stesso muro, solo prima, non l’avrebbe risolto.
Quindi la cura non era sostituire Jev con qualcos’altro. Era smettere di farlo morire di fame.
Cosa ho costruito al suo posto#
Cinque aggiunte, tutte dentro lo schema shadow/active che c’era già, senza toccare quale modello risponde alla domanda.
1. Storico compatto, non letture grezze#
Un nuovo script condiviso, script.jev_history, chiama recorder.get_statistics di Home Assistant e lo ricampiona in serie brevi che un modello può leggere al volo - un valore per passo, più minimo, massimo e la salita o discesa più grande con l’orario in cui è successa:
- action: script.jev_history
  data:
    sensors:
      water flow L/min: sensor.water_monitor_general_water_flow_l_min
      upstairs bathroom humidity %: sensor.temperature_sensor_salle_bain_etage_humidity_2
      parents' bathroom humidity %: sensor.temperature_sensor_salle_bain_parents_humidity_2
      kitchen humidity %: sensor.temperature_sensor_cuisine_humidity_2
    hours: 3
    every: 15
Sono circa 40 token per sensore invece di centinaia di stati grezzi e rumorosi, ed è esattamente quello che distingue una doccia da una perdita: una doccia è 8-12 L/min per dieci minuti con l’umidità del bagno che sale durante quella finestra; una perdita è un flusso basso e piatto per ore senza che nient’altro si muova. jev_history adesso gira prima di tutte e sei le decisioni - pompa, acqua, calo di temperatura, tapparelle, VMC, bucato.
Accanto c’è un sensor.house_timeline con finestra mobile di 24 ore che tiene gli ultimi 25 eventi di casa (“lavatrice partita”, “qualcuno è arrivato”, “VMC su Vitesse 2”) senza dire chi o dove, così una decisione vede anche cosa è appena successo, non solo che aspetto hanno i numeri.
2. Una base per l’umidità, perché “alto” è relativo#
Una stanza che segna sempre 72% non sta fumando al 72%, e soffiarci dentro aria esterna non asciuga niente se l’aria esterna ha più acqua della stanza. Due pezzi nuovi chiudono questo buco: un sensore statistics che tiene la mediana delle 24 ore di ogni stanza umida, e un template che trasforma temperatura e umidità relativa in umidità assoluta in g/m³ - il numero che dice davvero se ventilare aiuta o no. La decisione della VMC adesso riceve entrambi, insieme alle percentuali grezze.
3. Una rete di sicurezza per il bug che l’articolo scorso aveva scovato#
La scoperta più bella e più casuale dell’articolo precedente era che due sensori di umidità erano rimasti bloccati a 0% chissà da quanto, dando in pasto un numero sbagliato sia alla vecchia regola sia a Jev. Una cosa così non dovrebbe aspettare un altro articolo per essere notata, quindi adesso c’è un sensor_health.jinja condiviso: ogni sensore da cui dipende una decisione viene controllato per vedere se manca, non è disponibile, è fuori da un range plausibile, o è silenzioso da troppo tempo. Quando uno è rotto, a Jev viene detto esplicitamente quali valori non sono affidabili (“sensori inaffidabili: umidità massima soggiorno (valore implausibile)”), la sua risposta per quella chiamata non viene mai usata, e vince sulla regola anche un safe_answer (di solito “continua a fare quello che stavi facendo”) - perché la regola sta leggendo lo stesso sensore rotto e non ha idea che le stia mentendo.
4. Un interruttore di modalità per decisione, non uno per tutta la casa#
input_select.jev_mode era un solo interruttore per sei domande molto diverse tra loro. Adesso ci sono input_select.jev_mode_vmc, _eau, _pompe, _temperature, _volets, _linge, ognuno di default su global (segue l’interruttore principale) ma libero di andare in active o off per conto suo. È tornato utile prima di quanto pensassi - vedi i numeri qui sotto.
5. Un ciclo di feedback, così non devo più spulciare il registro a vita#
Ogni volta che Jev e la regola non sono d’accordo, adesso può partire una notifica sul telefono che chiede “chi aveva ragione?”, con due pulsanti. La risposta genera un evento, che finisce su un nuovo sensor.jev_scoreboard: per ogni decisione, quante volte è stato interrogato Jev, quante volte non era d’accordo con la regola, e chi diceva il feedback che avesse ragione, più il costo in token. Un’automazione della domenica sera legge lo scoreboard, pubblica un riepilogo settimanale e azzera il conteggio per la settimana dopo. Ho anche scritto un breve processo di revisione (docs/jev-weekly-review.md) per leggere il registro shadow, lo scoreboard e lo storico intorno a ogni disaccordo, e trasformare tutto questo in una pull request - la stessa forma di sessione che ha costruito la funzionalità la prima volta, questa volta puntata a rivederla.
Niente di tutto questo ha richiesto un modello diverso, una seconda macchina, o uscire dallo schema shadow. Ha richiesto mandare a Jev i fatti che una persona userebbe davvero per giudicare la stessa situazione.
Cosa dice davvero la casa, adesso#
L’ho tirato fuori dall’istanza live mentre scrivevo questa sezione, quindi è quello che sta succedendo davvero, non una stima.
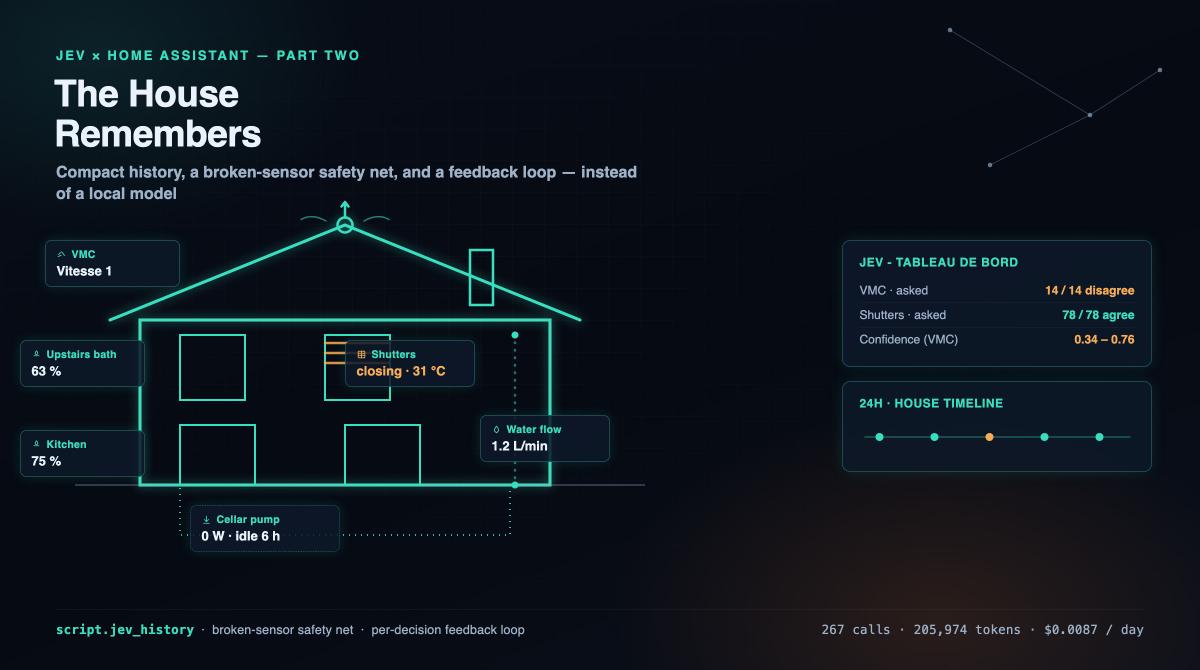
Oggi (26 settembre, controllato nel primo pomeriggio UTC): 267 chiamate a Jev, 205.974 token in input, 0,0087 $ finora. Sulla settimana passata, la media giornaliera è di circa 116 chiamate e un costo mediano intorno a 0,0027 $/giorno - un giorno tranquillo e uno intenso possono differire parecchio, il che è normale ora che la VMC chiede solo quando è cambiato davvero qualcosa e non a orario fisso.
Lo scoreboard ha solo poche ore (l’ho azzerato quando è entrato in produzione), e sta già raccontando qualcosa di utile:
| Decisione | Interrogato | In disaccordo con la regola | Confidenza di Jev |
|---|---|---|---|
| VMC (scelta tra 3 velocità) | 14 | 14 (100%) | 0,34 - 0,76, sempre sotto la soglia di 0,6 che gli permetterebbe di agire |
| Tapparelle (sì/no) | 78 | 0 (0%) | sempre sicura |
Tirato fuori direttamente dal registro shadow delle ultime 24 ore, non è un caso isolato - ognuna delle circa 115 chiamate della VMC non era d’accordo con la regola, sempre con una confidenza troppo bassa per contare anche in modalità active, mentre ogni chiamata delle tapparelle era d’accordo. Due decisioni, cablate allo stesso modo, che si comportano in modo completamente diverso. Ed è esattamente per questo che esiste l’interruttore per decisione: le tapparelle potrebbero passare in active oggi stesso, non c’è più niente da controllare; la VMC chiaramente non può ancora, e adesso ho uno scoreboard al posto di una sensazione di pancia a dirmelo. La mia ipotesi, da verificare: la regola della VMC reagisce già ai picchi brevi di umidità con isteresi, quindi buona parte di quello che sembra “disaccordo” è Jev e la regola che scelgono velocità diverse durante lo stesso transitorio, non uno dei due che sbaglia - ed è esattamente il genere di cosa per cui esiste il processo di revisione settimanale, una volta che ci sarà una settimana intera di risposte di feedback da leggere.
“Non è esattamente quello che fa il sensore bayesiano?”#
Un altro commento, sullo stesso thread di quello sul modello locale, stavolta di Niall O’Callaghan:
@mmornati is this not what the Bayesian sensor is for?
Il sensore bayesiano di Home Assistant fa “combina più indizi in una sola probabilità” da anni, del tutto in locale, gratis. La domanda è legittima, e la risposta onesta è: quasi, ma non proprio - e il divario è esattamente quello di cui parla questo articolo.
Un sensore bayesiano parte da un prior (quanto è probabile la cosa in generale) e da una lista di osservazioni - ciascuna una condizione state, numeric_state o template, con due numeri che fornite voi: prob_given_true e prob_given_false, quanto è probabile vedere quell’osservazione se la cosa è vera o falsa. Li moltiplica tra loro (bayesiano ingenuo) e passa a on non appena il risultato supera probability_threshold. Tutto locale, istantaneo, gratis, deterministico, e ogni numero è vostro, regolabile sulla vostra storia.
Dove finisce contro lo stesso muro di una semplice soglia:
- Bisogna conoscere le probabilità. “Quant’è probabile 14 mm di pioggia, sapendo che la pompa si comporta normalmente?” è una stima travestita da numero, e una stima sbagliata resta comunque un numero che sembra sicuro di sé.
- È binario, punto. Un sensore bayesiano è un solo
on/off. La decisione della VMC deve scegliere tra tre velocità, ciascuna con la sua confidenza - questo èjev.choice, che restituisce un’intera distribuzione che somma a 1. Per arrivarci con dei sensori bayesiani ne servirebbero tre che votano, senza nessuna garanzia che le loro probabilità si sommino a qualcosa di sensato. - I numeri diventano fasce, e gli indizi si considerano indipendenti. Un’osservazione
numeric_statescatta solo sopra o sotto una linea, quindi 11 L/min e 25 L/min finiscono nella stessa fascia. E l’umidità del bagno che sale perché l’acqua sta scorrendo è lo stesso fatto contato due volte, a meno di ricordarsi di modellare da soli quel legame. - Non sa quando le sue stesse letture mentono. Dategli il sensore di umidità rimasto bloccato a 0% chissà da quanto, e moltiplica quella bugia nella probabilità finale con esattamente la confidenza che avete configurato - proprio come faceva la vecchia regola della VMC. La rete di sicurezza
sensor_health.jinja, descritta più sopra in questo articolo, esiste proprio perché niente nel sensore bayesiano in sé avrebbe intercettato la cosa. - Niente memoria, neanche lì. Un sensore bayesiano ragiona sullo stato attuale delle sue osservazioni, non su “l’umidità è salita di 6 punti in 15 minuti e poi si è stabilizzata” - esattamente la forma che
script.jev_historyesiste per descrivere.
Niente di tutto questo lo rende uno strumento cattivo. Per un segnale che già si conosce bene e che si vuole tenere del tutto offline e deterministico - la presenza rilevata da sensori di movimento e apertura è l’esempio classico - un sensore bayesiano tarato a mano resta davvero la scelta migliore: nessuna chiamata di rete, nessun costo per chiamata, sempre la stessa risposta. I due, tra l’altro, si combinano bene: la probabilità di un sensore bayesiano può diventare una riga in più tra i dati che riceve Jev, e l’azione jev.calibrate di HA-Jev - che confronta lo storico di un sensore di probabilità con quello che è successo davvero - può suggerire una soglia, recuperando un po’ di quel vantaggio “tarato sulla mia casa” che un sensore bayesiano fatto a mano ha di partenza e un modello generalista no.
Cosa proverei ancora#
Due cose che non ho ancora fatto, entrambe passi naturali da quello che c’è già:
- Calibrare la VMC con il suo stesso storico. L’azione
jev.calibratedi HA-Jev confronta i valori passati di un sensore di probabilità con quello che è successo davvero e suggerisce una soglia. Con uno scoreboard e un registro che crescono, la decisione della VMC ha finalmente abbastanza dati suoi su cui essere tarata, invece di affidarsi alla calibrazione generica di Jev. - Dare a Laya lo stesso storico, in shadow, gratis. L’idea del modello locale non aveva torto a volere il contesto - stava risolvendo il livello sbagliato. Ora che
jev_historyproduce per ogni decisione una piccola serie JSON ricampionata, è anche esattamente quello di cui avrebbe bisogno un modello locale da 512 token, ed è economico da provare: registrare una terza colonna accanto a Jev e alla regola, senza notifiche sul telefono, solo numeri da confrontare tra qualche settimana.
Se fate girare Jev o un modello decisionale simile nelle vostre automazioni, mi piacerebbe sapere se avete trovato la stessa cosa - che il pezzo mancante era la memoria, non l’intelligenza. Ditemelo nei commenti, o rispondete su Mastodon come l’ultima volta.