Una settimana fa ho chiuso l’articolo su Clef-flash dicendo che avrei aggiunto il candidato successivo al benchmark al prossimo passaggio completo. Il candidato successivo è arrivato, ancora una volta, da un nome conosciuto: Nandakishor M, l’autore di Laya, ha rilasciato un secondo modello “System One”, VegaML. E nel frattempo Laya stesso ha avuto altre otto release.
Questo è il quinto articolo della serie. Se arrivate qui adesso:
- system-one-router: un gateway in Go che fa quattro domande tipizzate a un modello decisionale “System One” su ogni prompt (argomento, complessità, rischio, dati privati) e sceglie l’LLM più economico in grado di rispondere, con un benchmark da 80 prompt di Jev contro Laya;
- Jev in Home Assistant e il suo seguito: lo stesso tipo di modello che giudica le automazioni di casa mia;
- Laya contro Jev, dieci giorni dopo: nuovi modelli aperti (Von, Kev), una temperatura di confidenza e un fine-tuning di Laya sul mio MacBook;
- Clef-flash contro Jev: il modello decisionale da 9B di Cloudflare, il primo modello aperto a eguagliare Jev sull’argomento, ma a 4 secondi per decisione sul mio portatile.
Questo ha due parti: un breve aggiornamento su Laya, poi VegaML nel dettaglio.
Laya 0.3.24 → 0.4.2: otto release, stesse risposte#
Tra il 3 e il 10 ottobre, Laya è passato dalla 0.3.24 alla 0.4.2. Come l’ultima volta, la prima domanda era: è cambiato il modello, o solo il codice intorno?
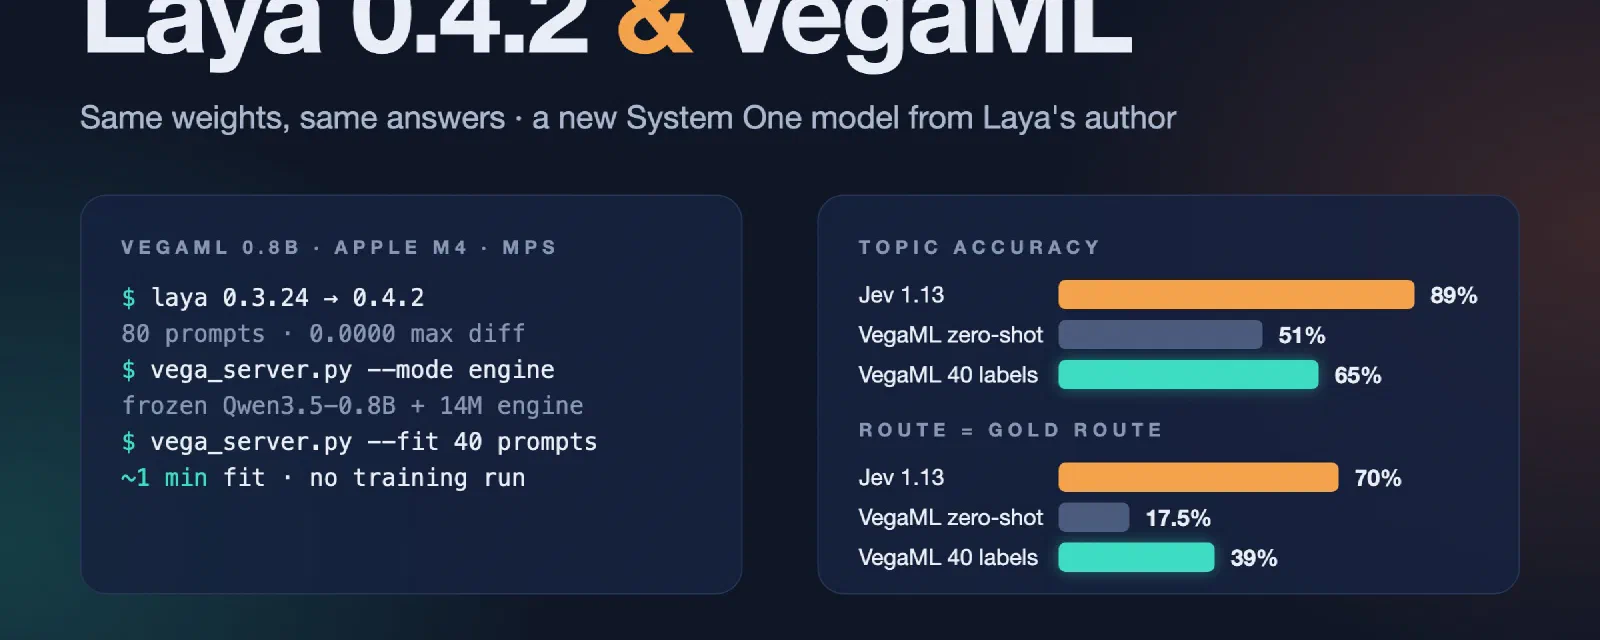
Solo il codice. L’ultimo commit che tocca i pesi su Hugging Face (convaiinnovations/laya) è del 19 settembre. I tre file model.safetensors hanno gli stessi hash, e l’unico commit sull’Hub dal mio test precedente aggiunge un config.json nella radice perché i download vengano contati. Quindi non mi aspettavo che cambiasse nulla, ma ho controllato comunque: stessi 80 prompt, tutte e quattro le colonne di Laya, sulla 0.4.2.
Ogni argomento, livello di complessità, livello di rischio e confidenza è identico al test con la 0.3.24, su tutti gli 80 prompt e tutti e quattro i checkpoint. La differenza di confidenza più grande è 0,0000. La storia dell’addestramento e i risultati attesi degli articoli precedenti non cambiano: Laya in zero-shot è ancora al 59% sull’argomento e ancora troppo insicuro per il router, e il fine-tuning resta il modo per renderlo utile.
Cosa è cambiato a monte, e perché non arriva al benchmark:
| Modifica | Influisce sul benchmark? |
|---|---|
0.4.0, incompatibile: laya.Router ora manda il testo di cui non riesce a rilevare la lingua al checkpoint multilingue invece che a quello inglese | No. Il mio sidecar fa il proprio routing per lingua per laya-auto con laya.detect_language(), e non usa Router. |
Correzioni a detect_language: acronimi inglesi come MON o EST non vengono più letti come francese; una parola che è inglese e anche una parola funzionale straniera conta una volta sola | Avrebbe potuto spostare uno o due prompt di laya-auto. Non l’ha fatto. |
Ricalibrazione a istogramma (histogram binning), controlli più severi su min_confidence | No. Nessun checkpoint pubblicato include nuovi file di calibrazione. |
| Disposizione “parallela” delle opzioni, opzionale e indipendente dall’ordine | No. Richiede un checkpoint riaddestrato; quelli pubblicati restano sequenziali. |
Nuova CLI laya-train, SDK Java e .NET, LAYA_EXTRA_MODELS, scaricamento quando inattivo | Non per i numeri. laya-train è interessante per il prossimo fine-tuning. |
Il sidecar ora è fissato a laya==0.4.2. Se usate Laya con il sidecar di system-one-router, l’aggiornamento è sicuro.
Una cosa è cambiata nel report, ed è un buon promemoria di come funziona il benchmark: su 6–19 prompt per checkpoint, il modello scelto è diverso rispetto al 2 ottobre, anche se le decisioni sono le stesse. La causa sono i prezzi di OpenRouter. DeepSeek V4.1 Flash è passato da $0,02/$0,60 a $0,30/$1,20 per milione di token, quindi ora GPT-5.6 Luna vince quegli slot, per tutti i provider e anche per la route di riferimento. Il router legge i prezzi in tempo reale, quindi la stessa decisione può portare a un modello diverso la settimana prossima. È voluto.
VegaML in breve#
VegaML è apparso su GitHub e PyPI il 9 ottobre, ed è passato dalla 0.1.0 alla 0.8.0 in due giorni. È Apache-2.0, pubblicato come pacchetto Python vegaml, con entrambe le taglie in un unico repository Hugging Face (nandakishorm/vega-08b-public-intents). Il README non cita Laya, ma l’autore è lo stesso.
La proposta è la stessa di Jev, Laya, Kev e Clef: gli si dà uno stato (un ticket, un prompt, la lettura di un sensore) e delle domande tipizzate il cui spazio di risposte è fissato in anticipo, e restituisce una risposta che il codice può usare direttamente, con delle probabilità. Non viene generato testo. Tre tipi di domanda:
choice: un’opzione da un insieme che definite voi (il mio argomento);score: un livello intero rispetto a criteri ordinati, più un valore atteso (la mia complessità e il mio rischio);boolean: la probabilità che un’affermazione sia vera (i miei dati privati). Nelle prime release si chiamavanoul, lo stesso nome dell’API di Jev, ed è stato rinominato nella 0.5.0.
Quello che cambia è come arriva alla risposta. Laya fa il fine-tuning di un intero ModernBERT. Kev e Clef mettono una testa addestrata sopra un modello linguistico. VegaML tiene il modello linguistico completamente congelato e ci aggiunge sopra un piccolo “motore fisico”:
- Lo stato, la domanda e le opzioni finiscono in un unico prompt, senza chat template. Il Qwen3.5 congelato lo legge una volta. VegaML preleva gli stati nascosti a due livelli interni (13 e 19 per lo 0.8B) e si ferma lì: la testa del modello linguistico non viene mai eseguita.
- I vettori aggregati piazzano una particella in uno “spazio decisionale” a 64 dimensioni, con una posizione di partenza e una spinta.
- Ogni risposta possibile diventa una valle (un pozzo gaussiano) in quello spazio. Per le domande
score, i livelli stanno su una linea, quindi il livello 2 è fisicamente vicino ai livelli 1 e 3. - La particella rotola con una dinamica smorzata per un budget fisso di 12 passi (con uscita anticipata), e la risposta è la valle in cui si ferma. Le probabilità dipendono da quanto finisce vicina al fondo di ciascuna valle.
Il titolo dell’articolo di blog dell’autore lo dice bene: un modello decisionale che fa rotolare una pallina giù da una collina. Il motore è piccolo: 14,3M di parametri (57 MB) per lo 0.8B, 30,9M per il 4B, nessun livello di attenzione. È addestrato sul comportamento di assestamento, non sulla previsione del token successivo. Due piccoli adattatori in stile LoRA (circa 5 MB in tutto) stanno sopra il motore, e un gate decide per ogni domanda se aiutano.
La fisica non è solo un espediente. Produce diversi segnali di sicurezza che tornano con ogni risposta:
- Una temperatura per decisione. Una particella che si muove ancora alla fine, o che si è fermata lontano da ogni valle, riceve una temperatura “più calda”, quindi una risposta meno sicura.
- Insiemi conformi. Per un livello di rischio α (per esempio 0,1), l’insieme di risposte che dovrebbe contenere quella giusta il 90% delle volte.
- Abstain, un flag quando la confidenza è sotto una soglia adattata.
- Unbound, un flag quando la particella si è fermata lontano da ogni valle: il modo del modello di dire “questa domanda è fuori da quello che conosco”.
E c’è la funzione che mi ha colpito: fit(). Le si danno degli esempi etichettati (la documentazione dice una ventina per domanda) e addestra una piccola testa per domanda, la valida in modo incrociato e scarta ogni testa che non batte il caso. Nessun addestramento, nessuna ora di GPU. Poi si sceglie una modalità:
| Modalità | Cosa fa |
|---|---|
engine | Zero-shot. Calibrazione, insiemi conformi e abstain. È la modalità dietro tutti i numeri pubblicati. |
auto | Il default dalla 0.7.0: usa una testa adattata dove batte il caso, il motore altrove. Senza nulla di adattato, è il motore. |
ttt | Solo teste adattate. Più nette sulle loro etichette, ma senza calibrazione né abstain. |
both | Le due letture affiancate. |
Qualche altra cosa da sapere:
- Due taglie. 0.8B (su Qwen3.5-0.8B, un backbone da 1,77 GB) e 4B (su Qwen3.5-4B, 9,34 GB).
- Contesto lungo: 73.728 token. Gli stati da 4.096 token o più vengono letti una volta e messi in cache, quindi fare dodici domande su un contratto lungo costa più o meno una lettura. Gli input troppo lunghi vengono rifiutati, non troncati in silenzio.
- Immagini.
decide_imagelegge un’immagine attraverso l’encoder visivo congelato del backbone. Funziona dalla 0.8.0; l’autore dice che i benchmark pubblicati non lo coprono. - Viste.
views=2o3rilegge l’input con le opzioni invertite o lo stato riformulato, e fa la media. Costa circa due o tre volte di più. Tutti i numeri pubblicati usanoviews=1. - Lingue: non dichiarate. Gli adattatori sono stati addestrati su LocalLLaMA/typed-decisions, che è in inglese.
A cosa serve, secondo l’autore#
Il README è di un’onestà rinfrescante. L’autore non sostiene che VegaML batta Jev in accuratezza; dice che Jev vince sull’accuratezza su tutta la linea. Quello che VegaML offre invece sono probabilità oneste, una risposta per ogni richiesta (niente “max tokens exceeded”), bassa latenza e tutto in locale, senza che niente lasci la macchina.
I flussi di esempio sono smistare un’email o un ticket a un team, valutare il rischio di abbandono di un cliente, classificare un documento dalla sua immagine e fare molte domande su un contratto molto lungo. I domini dove va meglio sono i compiti di screening brevi: phishing (il suo risultato migliore in un test precedente), spam, prompt injection, tossicità, e i compiti con spazi di etichette molto ampi, dove il motore aiuta di più il piccolo backbone (151 intenti su CLINC150: 0,900 con il motore contro 0,100 per il solo backbone).
I benchmark dell’autore#
I numeri attuali (README e bench/RESULTS.md) vengono da un test terminato l'11 ottobre su due Tesla T4 su Kaggle: modalità engine zero-shot, 3.841 decisioni per sistema, e Jev chiamato in diretta tramite l’endpoint jev-latest di TypeSafe per ogni riga.
| Vega 0.8B | Vega 4B | Jev | |
|---|---|---|---|
| Menu pubblico, 43 compiti (media macro) | |||
| Accuratezza | 0,556 | 0,717 | 0,836 |
| F1 macro | 0,486 | 0,649 | 0,796 |
| ECE (più basso è meglio) | 0,151 | 0,148 | 0,115 |
| Latenza p50 | 74 ms | 106 ms | 162 ms |
| JevBench, 231 elementi | |||
| Accuratezza | 0,545 | 0,662 | 0,866 |
| ECE | 0,178 | 0,169 | 0,067 |
| Coerenza sulle parafrasi | 0,694 | 0,722 | 0,972 |
| DecisionBench, 1.075 elementi | |||
| Accuratezza | 0,509 | 0,633 | 0,752 |
| Copertura | 1,000 | 1,000 | 0,997 |
| ECE | 0,103 | 0,098 | 0,122 |
| Latenza p50 | 85 ms | 245 ms | 163 ms |
Quindi, sulle suite dell’autore stesso, Jev è nettamente davanti in accuratezza, e VegaML è competitivo sulla calibrazione (meglio di Jev su DecisionBench, dove la confidenza media di Jev è 0,874 per un’accuratezza di 0,752) e più veloce su una GPU.
Con l’adattatore typed-decisions, sulla porzione di test del dataset su cui è stato addestrato (2.050 decisioni), il quadro è molto migliore: 76,3% di accuratezza e un ECE di 0,026 per lo 0.8B, 80,3% e 0,019 per il 4B, a 22–28 ms per decisione. È il VegaML “specializzato”, su dati del suo dominio: lo stesso motore 0.8B senza adattatore fa il 38,9% sulla stessa porzione.
Il README elenca anche dove batte Jev, compito per compito: 4 compiti su 43 per lo 0.8B e 12 su 43 per il 4B (classificazione di spam, jailbreak e tossicità, prompt injection, equità dei termini di servizio, alcuni compiti sui tweet). E poi, a suo merito, l’autore spiega perché la maggior parte di queste vittorie non conta: 8 delle 12 sono su 3 righe o meno, due hanno un problema di classe maggioritaria, e solo la prompt injection supera un test di significatività. In un test precedente, messo a confronto con Jev 1.13, VegaML ha intercettato 252 email di phishing su 400 contro 99 per Jev (con una precisione più bassa: 0,84 contro 0,96), ed era 2,1 volte più veloce: 280 ms per decisione su un Apple serie M in fp32, contro 591 ms per Jev ospitato.
La pagina RESULTS elenca anche “risultati reali contro Vega”, cosa che ho apprezzato:
- Gli insiemi conformi coprono meno del previsto: sul menu pubblico, gli insiemi al 90% contengono la risposta giusta il 70,5% delle volte per lo 0.8B (77,1% per il 4B).
- L’ordine delle opzioni conta: invertire le opzioni cambia la risposta sul 70% delle righe di un benchmark legale per lo 0.8B.
- Il backbone da solo (Qwen3.5 che genera la risposta) è preciso più o meno quanto VegaML su queste suite (0,523 contro 0,556 per lo 0.8B). La conclusione dell’autore è che il contributo del motore sono copertura, probabilità, calibrazione, astensione e circa un terzo della latenza, non l’accuratezza.
Ho trovato un solo test indipendente: un piccolo benchmark di estrazione di informazioni dove lo 0.8B ha fatto 9 su 12, ma dove il flag abstain ha intercettato tutte e sei le risposte sbagliate. C’è anche una versione ONNX a 8 bit che gira nel browser. Nessuno aveva ancora pubblicato numeri di routing. Tocca ai miei.
Gira sul mio Mac?#
Lo 0.8B sì. Il 4B no. VegaML gira solo in fp32, e il 4B richiede circa 16,5 GB di RAM in fp32 (è il dato del tester indipendente; l’autore dà solo la dimensione del backbone). Su un M4 da 16 GB, è la stessa storia di Kev-4B e Clef 27B.
Tre cose da sapere prima di cominciare:
- Non c’è un server
/v1/systemone. Laya, Von, Kev e Clef-flash parlano tutti il formato HTTP di Jev, quindi aggiungerli era questione di un URL. VegaML è un’API Python (vegaml.load(...).decide(state, questions)), quindi è servito un piccolo sidecar: sidecar/vega_server.py, 130 righe. Rinominanoulinbooleanin ingresso,probsinprobabilitieseexpected_scoreinscorein uscita, e fa passare i campi propri di VegaMLabstain,prediction_seteunbound. - Di default usa CUDA, poi la CPU. Su un Mac bisogna passare
device="mps"per usare la GPU. - Richiede
transformers>=5.17, quindi ha il suo ambiente virtuale invece di condividere quello di Laya.
uv venv --python 3.12 sidecar/.venv-vega && uv pip install --python sidecar/.venv-vega/bin/python vegaml==0.8.0
sidecar/.venv-vega/bin/python sidecar/vega_server.py                                  # :8793, zero-shot ("engine")
sidecar/.venv-vega/bin/python sidecar/vega_server.py --mode auto --fit examples.jsonl # with fitted heads
go run ./cmd/bench -providers jev,vega
Il primo avvio scarica il backbone Qwen3.5-0.8B (circa 2 GB), che VegaML verifica con uno SHA-256 fissato. Lato benchmark, è un nuovo provider vega e un’opzione -vega-url, con lo stesso limite di 6.000 caratteri di stato di Jev, Von, Kev e Clef-flash.
Il test standard, ancora una volta#
Per chi arriva adesso, e perché i dettagli contano per leggere i risultati, ecco cosa fa il benchmark. cmd/bench manda 80 prompt etichettati a ogni provider di decisione, usando lo stesso router e la stessa configurazione:
- 57 compiti di sviluppo di base (codice, review, debugging, SQL, infrastruttura, architettura, scrittura, chat);
- 8 prompt in altre lingue (francese, spagnolo, tedesco, italiano, giapponese, cinese, portoghese);
- 4 input più lunghi di 512 token;
- 7 prompt trabocchetto o ambigui (“sistemalo”, “puoi renderlo più veloce?”, una prompt injection…);
- 4 con dati privati (token, un URL di database con password, una cartella clinica).
Ogni prompt riceve le quattro domande del router in un’unica richiesta: argomento (una choice tra 10 opzioni: code-gen, code-review, debugging, security, docs, data-sql, infra-devops, architecture, writing, chat), complessità (uno score da 0 a 3), rischio (uno score da 0 a 2) e dati privati (un noul/boolean). Dalle risposte, il router calcola una soglia di qualità, la alza quando la confidenza sull’argomento è sotto 0,8, e sceglie il modello più economico sopra la soglia tra cinque modelli di OpenRouter, da Qwen 3.7 Flash a Claude Opus 5.5.
Nessun prompt viene mandato a un modello di chat. Il benchmark confronta solo le decisioni. Il riferimento è la route di riferimento: il modello che il router sceglie quando riceve le etichette umane invece delle risposte di un modello. Le metriche:
- Accuratezza su argomento, complessità e rischio rispetto alle etichette (la complessità anche “entro ±1”);
- Risposte sicure: la quota di risposte sull’argomento pari o superiori a 0,8, e quanto spesso sono giuste;
- ECE (errore di calibrazione atteso): quanto la confidenza dichiarata si allontana dall’accuratezza reale. Più basso è meglio;
- Route = riferimento: quanto spesso il modello scelto è esattamente quello di riferimento, e quanto spesso è più economico (sottodimensionato, un rischio di qualità) o più caro (sovradimensionato, soldi sprecati);
- Latenza della decisione stessa, p50 e p90.
Jev è stato rilanciato nella stessa sessione come riferimento, quindi i suoi numeri si spostano un po’ da un articolo all’altro (dal 70% al 75% di route identiche a quella di riferimento negli ultimi test, il rumore di un modello remoto su 80 prompt, più il cambio di prezzo di cui sopra).
Test 1: VegaML zero-shot#
Il primo test è la configurazione usata per i numeri dell’autore: mode="engine", views=1. Questo è il riepilogo del report HTML:

51% di accuratezza sull’argomento. È sotto tutti i modelli aperti che ho testato tranne Laya multilingue (45%), e 0% sul gruppo trabocchetto. Complessità e rischio sono un po’ meglio di quelli di Laya (42,5% e 54%), e i dati privati vengono rilevati il 92% delle volte. Ma solo una risposta su 80 raggiunge la soglia di confidenza di 0,8 del router. Come con Laya zero-shot, il router va sul sicuro, alza la soglia di qualità e manda quasi tutto a Sonnet:

59 prompt vanno a un modello più caro di quello di riferimento, e solo il 17,5% coincide con la route di riferimento. Le righe prompt per prompt mostrano lo schema: hello (“ciao, come stai oggi?”) viene letto come debugging al 20%, git-undo come docs al 21%. Anche quando VegaML indovina l’argomento (py-csv, rename-var), lo fa con una confidenza del 26–32%, di cui il router non può fidarsi.

Perché è così diverso dai risultati dell’autore? Credo che la ragione sia il compito. Le sue vittorie sono su screening binari o con poche classi (phishing sì/no, spam sì/no, l’argomento di una notizia tra quattro). La mia domanda sull’argomento è una scelta tra 10 opzioni con categorie che si sovrappongono: un prompt “scrivi una regex” è code-gen, ma un lettore ragionevole potrebbe dire code-review o debugging. È esattamente il tipo di domanda in cui si vede lo 0,866 di Jev contro lo 0,545 di VegaML su JevBench.
I segnali di sicurezza aiutano il router?#
Il punto di forza di VegaML sono i suoi segnali di incertezza, quindi li ho confrontati uno per uno con la soglia di confidenza del router:
abstainsegnala 72 delle 80 risposte sull’argomento. Quelle 72 sono giuste il 47% delle volte; le 8 che tiene sono giuste l'88% delle volte. Quindi è un segnale corretto, ma dice la stessa cosa che dice già la soglia di 0,8: “non sono sicuro”, quasi sempre.unboundnon porta alcun segnale qui: le risposte segnalate e non segnalate sono giuste il 51% e il 52% delle volte.- Gli insiemi conformi con α = 0,1 contengono una sola opzione e includono l’argomento di riferimento il 54% delle volte invece del 90%. La calibrazione fornita non si trasferisce alle mie domande, il che corrisponde alla copertura insufficiente che l’autore riporta sulle sue suite.
Test 2: una temperatura di confidenza#
Nell’articolo su Laya avevo aggiunto una temperature opzionale per provider: dividere i logit per T prima del softmax. Non cambia mai la risposta vincente, solo quanto il modello sembra sicuro. Ha sistemato Kev, il Laya fine-tunato e Clef-flash. Stesso metodo: minimizzare la log-loss su metà dei prompt, misurare sull’altra metà, 20 suddivisioni casuali. Lo script ha riprodotto il valore precedente di Kev (0,45 contro 0,47, abbastanza vicino per una griglia grossolana), e ha dato T = 0,60 per VegaML.
| VegaML zero-shot | VegaML, T = 0,60 | Jev 1.13 | |
|---|---|---|---|
| Accuratezza sull’argomento | 51% | 51% (invariata) | 89% |
| Risposte sicure (≥ 0,8) | 1% | 19% (93% giuste) | 84% (94% giuste) |
| Errore di calibrazione | 0,162 | 0,092 | 0,074 |
| Route = riferimento | 17,5% | 20% | 70% |
| Più economico / più caro del riferimento | 7 / 59 | 11 / 53 | 4 / 20 |
La calibrazione migliora molto (0,162 → 0,092), ma una temperatura non può creare un’accuratezza che non c’è: 51% resta 51%, e le route si muovono appena. Kev aveva il problema opposto: giusto ma timido. VegaML zero-shot è perlopiù insicuro perché sbaglia spesso, e dirlo è la risposta onesta.
Test 3: teste few-shot da 40 prompt etichettati#
Questa è la parte che mi incuriosiva di più, e il motivo per cui VegaML merita un articolo invece di una riga in una tabella. Nessuno degli altri modelli può imparare dalle mie etichette senza un addestramento. Il fit() di VegaML promette di farlo in circa un minuto.
Per misurarlo onestamente, non potevo adattare sugli 80 prompt e testare sugli stessi 80. Quindi:
- Gli 80 prompt sono stati divisi in due metà, A e B, stratificate per argomento.
- Il sidecar ha ricevuto un’opzione
--fit: legge esempi etichettati (stato, etichette, domande) e chiamafit()prima di servire in modalitàauto. - Le teste adattate su A hanno risposto ai prompt di B, poi le teste adattate su B hanno risposto ad A. Le due metà vengono unite, quindi ogni prompt è valutato da teste che non l’hanno mai visto.
Una trappola lungo la strada: Go serializza le mappe con le chiavi ordinate, quindi il router manda le opzioni dell’argomento in ordine alfabetico. Il file di fit deve usare lo stesso ordine, altrimenti le feature delle teste non corrispondono alle domande al momento di servire.
Adattare 40 esempi richiede circa un minuto sull’M4. Sulla metà A, la validazione incrociata di VegaML ha riportato l'84% per la testa dell’argomento, il 53% per la complessità e il 70% per il rischio. La testa dei dati privati è stata scartata su una delle metà (troppo pochi esempi privati per battere il caso), quindi lì ha risposto il motore, che è esattamente lo scopo della modalità auto.
| Jev 1.13 | VegaML zero-shot | VegaML teste few-shot (prompt tenuti da parte) | few-shot, T = 0,72 | |
|---|---|---|---|---|
| Accuratezza sull’argomento | 89% | 51% | 65% | 65% |
| Argomento: core / multilingue / lunghi / trabocchetto | 95% / 88% / 75% / 43% | 56% / 62% / 75% / 0% | 63% / 62% / 100% / 57% | uguale |
| Complessità esatta / entro ±1 | 71% / 100% | 42,5% / 94% | 54% / 96% | uguale |
| Rischio esatto | 61% | 54% | 64% | 64% |
| Risposte sicure (≥ 0,8) | 84% (94% giuste) | 1% | 10% (88% giuste) | 24% (84% giuste) |
| Errore di calibrazione | 0,074 | 0,162 | 0,186 | 0,138 |
| Route = riferimento | 70% | 17,5% | 39% | 42,5% |
| Più economico / più caro del riferimento | 4 / 20 | 7 / 59 | 2 / 47 | 6 / 40 |
| Latenza di decisione p50 / p90 | 364 / 436 ms | 1.344 / 1.703 ms | 862 / 977 ms | uguale |
Con 40 etichette e un minuto di adattamento, su prompt che le teste non hanno mai visto:
- L’argomento passa dal 51% al 65%, e il gruppo trabocchetto dallo 0% al 57% (Jev: 43%);
- Il rischio arriva al 64%, sopra il 61% di Jev, la stessa cosa che avevo visto con il fine-tuning di Laya: etichette scritte con le mie convenzioni insegnano la mia idea di rischio;
- Le route uguali a quella di riferimento più che raddoppiano, dal 17,5% al 39%, e al 42,5% con una temperatura;
- e diventa più veloce: una testa adattata sostituisce il motore per la sua domanda, quindi 0,86 s invece di 1,34 s.
Le teste sono ancora poco sicure (10% di risposte sopra 0,8), e le teste adattate sono senza calibrazione per costruzione. Una temperatura (T = 0,72, adattata sulle risposte unite dei prompt tenuti da parte, quindi in-sample per T, come le altre righe “benchmark completo”) aiuta un po’. Resta lontano da Jev, e sotto l'81% di Kev-0.8B in zero-shot sull’argomento.
Per avere un’idea delle proporzioni, il fine-tuning di Laya aveva richiesto 480 prompt etichettati e 41 minuti per arrivare all'85% sull’argomento e al 64% di route uguali a quella di riferimento. VegaML arriva al 65% e al 39% con 40 prompt e un minuto. Non sono lo stesso esperimento (il fine-tuning di Laya si era addestrato su un insieme separato di prompt; qui le due metà del benchmark si danno il cambio), ma il compromesso è chiaro: VegaML è un modo economico di ottenere qualcosa da una manciata di etichette; un vero fine-tuning resta il modo per ottenere un modello con cui fare routing.
Tutti i modelli finora#
Stessi 80 prompt, stesso router, serate diverse. Jev è il riferimento di ogni test, quindi per i dettagli fini confrontate ogni modello con la sua colonna Jev negli articoli precedenti.
| Modello (M4 da 16 GB salvo se ospitato) | Argomento | Route = riferimento | ECE | Latenza p50 |
|---|---|---|---|---|
| Jev 1.13 (ospitato) | 89% | 70–75% | 0,068–0,080 | 258–364 ms |
| Clef-flash 9B 4 bit, T = 0,64 | 90% | 64% | 0,072 | 3.854 ms |
| Laya fine-tunato (480 etichette), T = 0,87 | 85% | 64% | 0,082 | 319 ms |
| Kev-0.8B, T = 0,47 | 81% | 39% | 0,059 | 371 ms |
| Von 1.3 | 70% | 48% | 0,226 | 216 ms |
| Laya typed-decisions | 71% | 12% | 0,509 | 334 ms |
| VegaML 0.8B, few-shot (40 etichette), T = 0,72 | 65% | 42,5% | 0,138 | 862 ms |
| Laya inglese (0.4.2 = 0.3.24) | 59% | 20% | 0,171 | 300 ms |
| VegaML 0.8B, zero-shot, T = 0,60 | 51% | 20% | 0,092 | 1.344 ms |
Perché 1,3 secondi se la scheda dice 280 ms?#
Perché la scheda misura una decisione e una richiesta del router sono quattro domande. VegaML fa un passaggio nel backbone per ogni domanda, e la cache del prefisso parte solo da 4.096 token, molto sopra i miei prompt. Quattro passaggi da circa 330 ms ciascuno sulla GPU dell’M4 danno gli 1,3 s che ho misurato. Con le teste adattate, le teste sostituiscono il motore per le loro domande, da cui gli 0,86 s.
I 74–85 ms di p50 dell’autore sono su una GPU T4 in fp16, un’altra storia di hardware ancora. Come per Clef-flash, ogni numero è vero sulla sua macchina.
La solita domanda: su cosa è stato addestrato?#
Includo solo i modelli che dichiarano di non essere stati addestrati sugli output di Jev, perché i termini di TypeSafe vietano la distillazione di Jev. VegaML è un caso limite, come Clef-flash. Gli adattatori sono documentati: addestrati sulla porzione di addestramento di LocalLLaMA/typed-decisions, la cui scheda dice di non essere affiliata a TypeSafe e di non riprodurre Jev. I dati di addestramento del motore di base non sono descritti, solo il suo obiettivo. Jev compare nel repository come riferimento chiamato in diretta, niente di più. Ho incluso il modello e segnalato la questione nella documentazione del benchmark, come per Clef-flash.
Dove ha senso usarlo#
- Come router da sostituire così com’è, in zero-shot: no. 51% sull’argomento e 1% di risposte sicure vogliono dire che il router sovradimensiona quasi tutto, e i segnali di sicurezza non aggiungono nulla che la soglia di confidenza non dica già.
- Come “punto di partenza” per le mie etichette: interessante. system-one-router registra già gli esiti per
cmd/refit. Darne qualche decina afit()ogni notte, con le teste scartate automaticamente quando non battono il caso, è un ciclo economico che nessun altro modello qui offre. - Per i compiti per cui è stato pensato: probabilmente sì. Screening binario (è una prompt injection? è phishing?) con astensione, in locale, su documenti lunghi. Non è la domanda del mio router, ma potrebbe essere una delle domande di casa mia.
- Laya: niente di nuovo per il routing. Il prossimo passo lì resta un fine-tuning, ora con la CLI ufficiale
laya-traininvece dei miei script.
Lezioni imparate#
- Controllate i pesi prima di rilanciare un benchmark. Otto release di Laya, zero pesi cambiati, zero risposte cambiate. Un confronto degli hash me l’avrebbe detto in un secondo.
- Il listino prezzi si muove anche quando il modello resta fermo. Un cambio di prezzo di DeepSeek ha spostato fino a 19 route per colonna. I benchmark di un router sono confrontabili solo a parità di prezzi.
- Le vittorie di un fornitore descrivono i compiti del fornitore. Phishing sì/no e una scelta di argomento tra 10 sono entrambe “decisioni”, ma non hanno la stessa difficoltà.
- I segnali di incertezza servono solo se aggiungono informazione.
abstain,unbounde gli insiemi conformi sono ben progettati, ma sulle mie domande ripetono il punteggio di confidenza. - Il few-shot è una vera via di mezzo. 40 etichette, un minuto, misurato su prompt tenuti da parte: non abbastanza per farci routing, ma il miglior rapporto tra risultato e sforzo di tutto quello che ho provato finora.
- “Per decisione” non vuol dire “per richiesta”. Quattro domande sono quattro passaggi per VegaML. Leggete i numeri di latenza tenendo a mente il numero di domande.
Il codice e il resoconto completo sono in mmornati/system-one-router#12, con le istruzioni di installazione in docs/benchmark.md. Il report pubblicato mostra ancora il test a sette provider; Clef-flash e VegaML ci entreranno al prossimo passaggio completo, quando tutti i server locali saranno attivi nello stesso momento. Se avete provato il fit() di VegaML sui vostri dati, o il 4B su una macchina più grande, mi piacerebbe molto saperlo nei commenti.
Come è stato fatto#
Stesso metodo del resto della serie: una sessione di Claude Code con Opus 5.5. Gli ho chiesto di leggere il changelog di Laya, dirmi se valeva la pena di rifare il benchmark, e giudicare se VegaML fosse “allo stesso livello” e potesse essere messo alla prova, con un piano e senza codice. Ha confrontato gli hash dei pesi, letto il README e il codice di VegaML e proposto sei passi: sidecar, provider del benchmark, test zero-shot, temperatura, teste few-shot, documentazione. Ho detto “esegui tutti i punti”. Ha scritto il sidecar, fatto la verifica di Laya e i tre test di VegaML, trovato la trappola delle chiavi ordinate nel file di fit e aperto la pull request. Per questo articolo, una seconda sessione ha letto quella trascrizione, cercato online il materiale pubblicato su VegaML e scritto una bozza del testo. La mia parte è stata scegliere cosa misurare e cosa tenere.