Da un mese, il mio Home Assistant chiede a Jev le cose a cui le mie regole YAML non sanno rispondere bene: conviene spingere la ventilazione adesso? Vanno abbassate queste tapparelle? Questo flusso d’acqua è normale? Ho descritto il setup nel primo articolo e lo storico e il ciclo di feedback nel secondo. Jev è il modello “System One” ospitato di TypeSafe: gli mandi uno stato JSON e delle domande tipizzate, lui restituisce probabilità calibrate, per una frazione di centesimo al giorno.
Laya, di Convai Innovations, è l’alternativa open weights che seguo dal benchmark del router, passando per un fine-tuning sulle mie etichette e la verifica della 0.4.2. Parla la stessa API di Jev. E c’è un argomento a suo favore che nessun benchmark misura: se gira in casa, nessun dato della mia casa va da nessuna parte. L’umidità dei miei bagni, quando si muovono le tapparelle e se c’è qualcuno in casa sono esattamente il tipo di dati che preferisco tenere sulla mia rete.
Nel secondo articolo avevo spiegato perché non ero passato al locale sul mio mini PC N100. Questa volta ho smesso di discutere e l’ho installato. Questo articolo tratta:
- far girare Laya in Docker su un N100 e collegarlo a Home Assistant;
- cosa è successo quando ci ho rigiocato due settimane di richieste reali a Jev;
- il fine-tuning di Laya sulla mia casa: dati di Home Assistant, etichettati con il senno di poi da Claude Opus e verificati da me, con Jev come termine di paragone e non come insegnante;
- se ne è valsa la pena.
Laya in un container su un N100#
L’hardware è un piccolo box Intel N100: 4 core, 16 GB di RAM, nessuna GPU, e già occupato da altri container. Lo gestisco con Coolify, ma va bene qualsiasi host Docker. Laya ha un suo server, laya-serve, che espone POST /v1/systemone con la stessa forma di richiesta e risposta di Jev.
La mia prima versione installava tutto all’avvio del container:
services:
  laya-api:
    image: python:3.13-slim
    restart: unless-stopped
    command: >
      sh -c "pip install --no-cache-dir torch --index-url https://download.pytorch.org/whl/cpu &&
             pip install --no-cache-dir 'laya[serve]' &&
             laya-serve"
    environment:
      - LAYA_HOST=0.0.0.0
      - LAYA_PORT=8000
      - LAYA_SERVER_PRELOAD=multilingual
      - OMP_NUM_THREADS=4
      - PYTHONUNBUFFERED=1
    volumes:
      - laya_model_cache:/root/.cache/huggingface
    ports:
      - "8180:8000"
    healthcheck:
      test: ["CMD", "python3", "-c", "import urllib.request; urllib.request.urlopen('http://localhost:8000/health')"]
      interval: 30s
      start_period: 120s

volumes:
  laya_model_cache:
Funziona, ed è un buon modo per provare Laya in cinque minuti. Qualche nota se decidete di tenerlo:
- Usate la wheel di PyTorch solo CPU. Quella di default si porta dietro librerie CUDA che su un N100 non servono e pesa gigabyte in più.
- Tenete la cache di Hugging Face in un volume, altrimenti a ogni riavvio il checkpoint viene scaricato di nuovo.
OMP_NUM_THREADS=4corrisponde ai quattro core dell’N100. Aggiungere worker o repliche non aiuta: ogni richiesta usa già tutti e quattro i core.- Fissate le versioni. Questo
command:reinstalla unlaya[serve]senza versione fissata a ogni riavvio, quindi un riavvio può portare in silenzio una nuova versione che risponde in modo diverso, dopo diversi minuti di installazione. Quando sapete di volerlo tenere, mettetelo in un’immagine:
FROM python:3.13-slim
RUN pip install --no-cache-dir torch==2.14.1 --index-url https://download.pytorch.org/whl/cpu \
 && pip install --no-cache-dir "laya[serve]==0.4.15"
ENV LAYA_HOST=0.0.0.0 LAYA_PORT=8000 OMP_NUM_THREADS=4 PYTHONUNBUFFERED=1
CMD ["laya-serve"]
Precarico il checkpoint multilingue: legge 1.024 token, contro i 512 di quello inglese, e le mie richieste sono lunghe.
Collegarlo a Home Assistant#
L’integrazione HA-Jev che uso accetta già un indirizzo personalizzato. Quindi il passaggio è una modifica di configurazione, non di codice: una seconda voce con l’URL http://<your-laya-host>:8180, il modello multilingual e nessuna API key (l’integrazione avvisa che si usa HTTP in chiaro, il che su una LAN è accettabile). Gli script che interrogano Jev accettano un config_entry, quindi ogni decisione può essere indirizzata all’uno o all’altro.
Questa era la parte facile. Quello che è venuto dopo è stato meno divertente.
Primi risultati: funziona, lentamente, e le risposte sono sbagliate#
Laya taglia la richiesta, e Home Assistant non se ne accorge#
Il mio primo test è stato una richiesta reale per la VMC (la ventilazione), quella in cui Jev decide se attivare la rumorosa velocità 2. Laya ha risposto 0,9954, “boost”, dove Jev aveva detto 0,49. Laya sembrava deciso. Poi ho letto il resto della risposta:
"usage": {"input_tokens": 1024, "state_tokens": 960,
          "state_tokens_dropped": 196, "truncated": true}
Il checkpoint multilingue legge 1.024 token in tutto, e 256 sono riservati alla domanda e alle sue opzioni. Il mio stato della VMC è di circa 1.150 token, perché il secondo articolo ha dato a Jev una memoria: tre ore di umidità per stanza, gli eventi recenti, ogni stanza confrontata con la propria mediana giornaliera. Laya semplicemente butta via la fine.
Due esperimenti hanno mostrato esattamente cosa si perde. Ho messo un fatto decisivo (“porta del garage aperta/chiusa”) dopo 1.500 token di riempitivo: entrambe le versioni hanno restituito esattamente 0,7307, quindi Laya non l’ha mai visto. Poi, sulla richiesta reale, mettere away e sleeping a on, o cambiare le soglie alla fine del background della domanda, ha restituito esattamente 0,9954 ogni volta. Laya taglia la fine dello stato, cioè proprio dove stavano i miei away, sleeping, i dati esterni e gli avvisi sui sensori inaffidabili. Limita anche la domanda a 256 token e taglia la fine di un background lungo senza segnalarlo.
E l’integrazione non te lo dice mai: il client legge le risposte e il conteggio dei token, non il flag truncated. In Home Assistant una risposta troncata sembra una risposta come le altre.
Accorciare le richieste: solo se le risposte di Jev non cambiano#
La soluzione ovvia è una richiesta più corta. Una versione compatta dello stato della VMC, con i fatti decisivi in testa e un blocco per stanza, è passata da 1.221 a 471 token. Ma tutti quei dati li avevo aggiunti perché a Jev servivano per decidere bene, quindi mi sono dato una regola: un accorciamento entra solo se le risposte di Jev non si muovono più del rumore di Jev stesso.
Claude Code ha prima misurato quel rumore: la stessa richiesta reale mandata due volte a Jev si sposta in media di 0,013 per la VMC e di 0,007 per le tapparelle. Poi ha tolto un campo alla volta su 50 situazioni reali, e infine ha testato le regole combinate su altre 200 (circa 1.400 chiamate a Jev, 0,10 $):
| Modifica alla VMC | Risparmio | Variazione media / max della risposta di Jev | Verdetto |
|---|---|---|---|
| Rimuovere le voci vuote | 126 B | 0,013 / 0,05 | rumore |
| Lista breve dei sensori inaffidabili | 76 B | 0,009 / 0,03 | rumore |
| Togliere le righe della pompa dagli eventi | 154 B | 0,039 / 0,14 | Jev le usa |
| Togliere umidità assoluta e guadagno della ventilazione | 104 B | 0,041 / 0,18 | usati |
| Togliere la serie di 3 ore | 741 B | 0,058 / 0,26 | usata |
| Togliere il testo di background | 1.079 B | 0,096 / 0,42 | usato |
Anche le regole “sicure”, tutte insieme, hanno spostato le risposte sulla VMC il doppio del rumore e ribaltato quattro decisioni su 120. Sono passate solo le tapparelle: tenere i valori della serie senza i riepiloghi min/max fa risparmiare il 15% dei token senza alcun cambiamento, ed è finito nella mia configurazione. La richiesta della VMC resta com’è. Non entra in Laya, e farcela entrare peggiorerebbe Jev.
È abbastanza veloce?#
Per dimensionarlo, ho contato due settimane di chiamate reali a Jev: 1.416 chiamate, 101 al giorno, 4,2 all’ora in media. Il minuto più affollato ne ha avute 4, ai :00 e ai :30, quando le domande programmate si allineano. Sull’N100, senza nient’altro che interroga:
| Richiesta | Tempo |
|---|---|
| Richiesta VMC completa (1.024 token, troncata) | 4,9 s (7,8 s per la prima chiamata) |
| Richiesta VMC compatta (325 token) | 1,0 s |
| 4 richieste contemporanee | 5,3 / 10,2 / 15,1 / 19,9 s |
laya-serve gestisce una richiesta alla volta, quindi un picco finisce in coda. Con 4 insieme, l’ultima risposta arriva dopo 20 secondi, dentro il timeout di 30 secondi dell’integrazione ma senza molto margine. Il costo cresce più in fretta della lunghezza, quindi la vera accelerazione è una richiesta più corta, più di qualsiasi impostazione della CPU. Sull’arco della giornata, però, sono circa 8 minuti di lavoro della CPU. Per una casa, lento va bene. Aspetterei volentieri 5 secondi per una decisione sulla ventilazione, se significa che i miei dati restano a casa.
Il vero test: due settimane di richieste reali#
Fino a quel momento avevo una sola richiesta reale. Ma il logging dei prompt era attivo sul mio account OpenRouter, quindi le richieste reali c’erano tutte. Claude Code le ha lette nel browser, dopo che mi ero autenticato io: 1.416 richieste dall'11 al 25 ottobre, ognuna con il JSON esatto mandato da Home Assistant e la risposta di Jev. Questi log mostrano quando c’è qualcuno in casa, quindi sono rimasti sul mio portatile, fuori da qualsiasi repository.
Ogni richiesta è andata a Laya senza modifiche. Dopo 396 il quadro era chiaro:
| Domanda | Laya base | Jev |
|---|---|---|
| Boost della VMC | troncata ogni volta; “sì” a 0,994–0,999 ogni volta | “sì” nel 18% dei casi |
| Tapparelle | “abbassale” nel 99% dei casi | una volta |
| Irrigazione del giardino | “sì” nel 100% dei casi | mai |
| Quale luce accendere | stessa scelta di Jev nel 27% dei casi |
Il troncamento non è il problema principale. Con lo stato completo visibile, su un esempio fatto a mano, una doccia in corso (90,8%, +16 punti in 15 minuti), una doccia di un’ora prima, un’umidità piatta e “tutti dormono” hanno ottenuto tutti tra 0,980 e 0,992. Gli ho dato i fatti come numeri, come parole (“in rapida salita, vapore fresco”) e come un semplice flag fresh_steam: true: niente ha spostato la risposta nella direzione giusta. Sulla VMC, il suo ordinamento delle situazioni era appena migliore del caso (AUC 0,60 rispetto alle decisioni di Jev).
Questo corrisponde alla documentazione stessa di Laya: è un encoder da 322M parametri (mmBERT-base) pre-addestrato su compiti decisionali generici, le sue risposte sì/no possono seguire la formulazione delle opzioni più che lo stato, e gli autori dicono di considerarlo una base da specializzare. Una temperatura o una soglia non possono rimediare: riscalano i punteggi ma ne mantengono l’ordine, e qui è l’ordine a essere sbagliato.
Quindi, nella sua forma base, Laya non può sostituire Jev in casa mia. Ha bisogno di addestramento. La vera domanda è: addestrato su cosa?
Insegnare a Laya la mia casa#
La scorciatoia che non ho tenuto#
L’obiettivo ovvio era lì, a portata di mano: 1.416 richieste, ognuna con la risposta di Jev. Addestrare Laya a riprodurre quelle risposte è distillazione, e il contratto cliente di TypeSafe (§2.3(b)) la esclude: non si possono usare il servizio o il suo output “to perform model distillation” né per “train a model to imitate the output of the Services” (cioè per fare distillazione o addestrare un modello che imiti l’output del servizio). Non prevede eccezioni per l’uso personale.
Per trasparenza: l’ho provato una volta, in locale, come primo test, per vedere se Laya fosse in grado di imparare la mia casa. Lo era. Dopo un’ora sul mio MacBook, le sue decisioni sulla VMC sono passate dal 14% al 93% di accordo con Jev su giorni che non aveva mai visto. Ma quel modello era una copia di Jev: non potevo farlo girare con la coscienza tranquilla, e non avrebbe mai potuto fare meglio di Jev. Quindi ho cancellato il checkpoint e i dati di addestramento etichettati da Jev, e sono ripartito con etichette che non vengono da Jev. Questo articolo parla di quel secondo modello.
Non sono l’unico curioso. Su GitHub, Mini-Jev distilla Jev in un piccolo modello Qwen e avverte lui stesso i lettori di controllare i termini di TypeSafe. Altri, come Kev o system-one-open, si addestrano invece su dataset pubblici o su etichette sintetiche proprie, ed è quella la strada pulita.
Etichette da Home Assistant, giudicate con il senno di poi#
Home Assistant sa già cosa è successo dopo ogni decisione: se l’umidità del bagno ha continuato a salire dopo un “niente boost”, se il soggiorno è arrivato a 28 °C nel pomeriggio in cui le tapparelle sono rimaste su. Un giudice che vede sia il momento della decisione sia le ore successive può dire quale fosse la scelta giusta, senza chiedere a Jev.
Tutti gli input vengono dal mio Home Assistant:
- Ottobre: 1.411 decisioni reali. Gli stati esatti mandati da Home Assistant tra l'11 e il 25 ottobre: VMC, tapparelle e le domande più rare. Per ognuno, il recorder aggiunge cosa è successo dopo: le letture grezze dei sensori per l’ora successiva da metà ottobre, le statistiche orarie prima di allora.
- Estate: 608 situazioni per le tapparelle. La mia automazione delle tapparelle ha cominciato a interrogare Jev solo in autunno, quando la risposta è sempre “tienile su”, quindi non c’era niente da imparare sull’abbassarle. Ma Home Assistant conserva per anni le statistiche orarie a lungo termine (media, minimo, massimo). Partendo da quelle, Claude Code ha ricostruito la decisione sulle tapparelle per ogni zona e per ogni ora da maggio a settembre: temperatura interna ed esterna, i sensori delle facciate al sole, le ultime quattro ore, la posizione del sole. Poi ne ha campionate 608 tra giornate calde, tiepide e fresche, insieme a quanto si è scaldata ogni stanza più tardi nello stesso giorno.
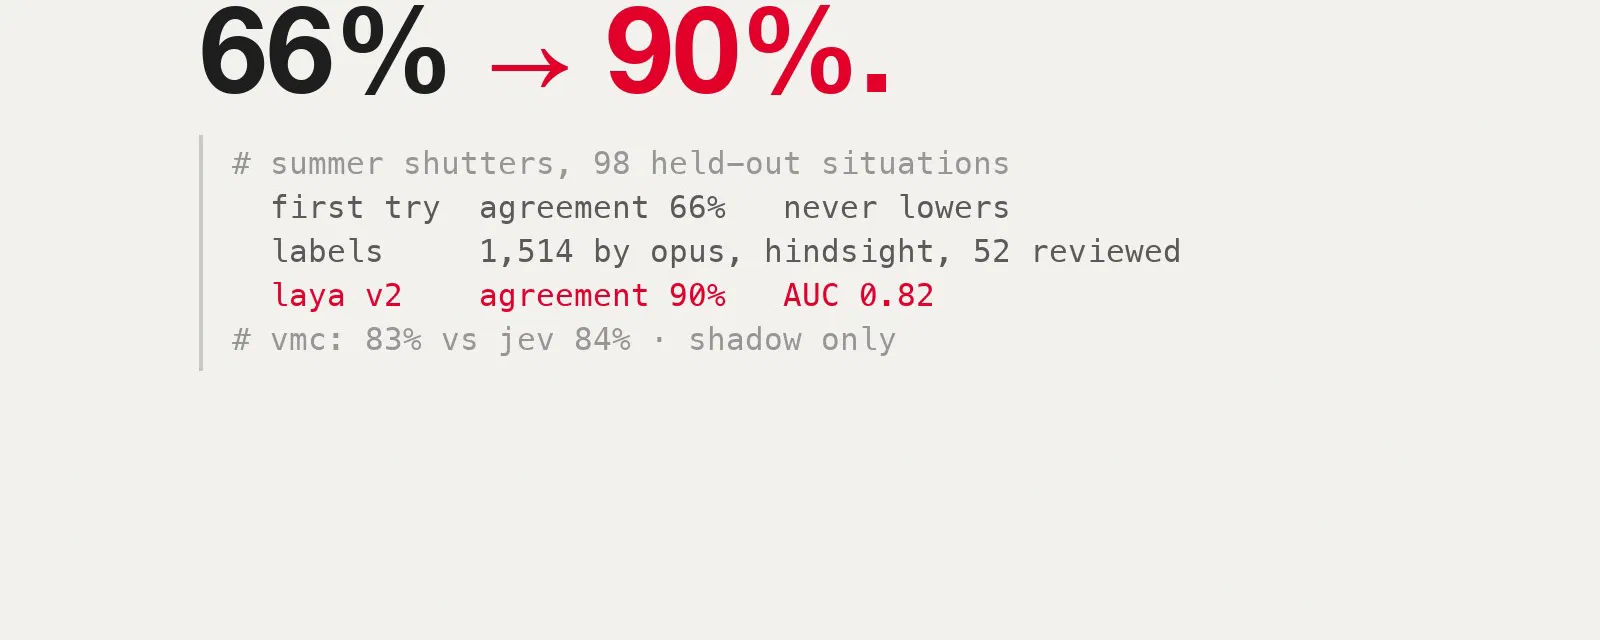
Il giudice è Claude Opus, tramite sub-agenti di Claude Code che lavorano a partire da una griglia di criteri scritta. Boost quando una stanza umida mostra vapore fresco (circa +5 punti in 15–30 minuti) e il senno di poi conferma che è reale, non un difetto del sensore. Abbassare le tapparelle se la stanza arriverà a circa 26 °C più tardi nella giornata e il sole batte su quella facciata. Per tutto il resto, buon senso e il background della domanda stessa. Ogni etichetta è una probabilità, non un sì/no (0,95 per “boost senza dubbio”, 0,6 per “propendo per il sì”), con una motivazione di una riga come “bagno dei genitori +11 a 82,8, vapore fresco da doccia”. In totale, 2.019 etichette.
Poi ho verificato il giudice. Claude Code ha raccolto i 52 casi più discutibili e li ho rivisti uno per uno io stesso. Una precisazione: per trovare in fretta i casi difficili, li ha scelti tra quelli in cui Opus e Jev non erano d’accordo. Ho dato ragione a Opus su tutti e 52, quindi nessuna etichetta è cambiata. Le risposte di Jev non sono mai state usate come etichette; servono solo per il confronto.
Jev non è la verità assoluta#
Questa si è rivelata la parte più interessante. Sulle 831 richieste VMC di ottobre, Jev e le etichette con il senno di poi sono d’accordo su 743, circa l'89%. I disaccordi non sono casuali:
- 53 volte il giudice avrebbe fatto il boost e Jev no. Quasi sempre l’inizio di una doccia: “bagno di sopra +12 a 81,5, vapore fresco da doccia”. Di solito anche Jev l’aveva vista, ma dava 0,45–0,59, appena sotto la mia soglia di 0,6.
- 35 volte Jev ha fatto il boost e il giudice no. In 31 casi il boost era già in corso: la cucina o il bagno erano tornati al loro livello abituale, e Jev teneva accesa la rumorosa velocità 2.
- Lo scaldabagno notturno: qualche volta Jev ha detto “scalda stanotte” dove il giudice propendeva per il no, per esempio con una sola persona in casa.
In parte dipende dalle mie soglie tanto quanto da Jev. Ma il punto è chiaro: Jev è un buon termine di paragone, non la verità, e un modello addestrato a copiarlo ne eredita gli errori.
Cos’è davvero Laya, e cosa cambia l’addestramento#
Laya non è un modello di chat e non scrive mai testo. Per ogni domanda costruisce una sequenza:
[CLS] <question type> instructions [SEP] [MASK] option 1 option 2 ... [SEP] state JSON [SEP]Un encoder la legge tutta in una volta, e una piccola testa in cima la trasforma in probabilità sulle opzioni: noul: 0.12, oppure una probabilità per ogni scelta. Un solo forward pass, nessun passo di ragionamento, ed è per questo che un modello da 322M risponde in circa un secondo sulla CPU di un mini PC.
Il fine-tuning cambia i pesi, non il programma. Per ogni esempio di addestramento, Laya fa una previsione, la previsione viene confrontata con l’obiettivo, e tutti i pesi si spostano un po’ verso di esso. Fatelo qualche centinaio di volte con un learning rate piccolo, e il modello si adatta alle vostre domande senza dimenticare il resto. Con le probabilità come obiettivi, impara anche il dubbio: uno 0,6 insegna “propendo per il sì”, non “sì”.
Laya ha il suo codice di addestramento, laya.train, che è stato meglio che fare reverse engineering del notebook Kaggle linkato dalla model card.
L’addestramento#
Ogni riga di addestramento è uno stato più la probabilità data dal giudice:
{"state": {...},
 "questions": {"answer": {"type": "noul", "instructions": {...}, "criteria": {...}}},
 "gold": {"answer": {"probabilities": {"false": 0.05, "true": 0.95}}}}
Le scelte importanti sono state:
- Dividere per tempo, non a caso. Addestramento sull'11–21 ottobre e sui giorni estivi, tranne il 16–31 agosto. Test sul 22–25 ottobre (402 richieste) e sul 16–31 agosto (98 situazioni per le tapparelle). Una divisione casuale metterebbe richieste VMC consecutive quasi identiche da entrambe le parti, e il punteggio sembrerebbe molto migliore di quanto sia.
- Non tagliare mai niente. Il modello deve funzionare solo per Laya, quindi riceve uno stato compatto: i fatti decisivi in testa e un background breve per la VMC. Ogni riga è stata verificata con il
build_sequencedi Laya: se anche un solo token dello stato venisse scartato, una regola di ripiego accorcia le serie, poi toglie gli eventi più vecchi uno alla volta. Risultato finale: ogni input entra in 1.024 token con 0 token scartati. - Le probabilità come soft target, convertite nel formato di Laya per ogni tipo di domanda (
noul,choice).
Lo script di addestramento è corto, perché il lavoro lo fa laya.train:
from laya.train import TrainConfig, finetune

cfg = TrainConfig(
    epochs=6,
    micro_batch=2, grad_accum=8,   # effective batch of 16
    encoder_lr=2.5e-5,
    loss="soft-ce",                # match the label's probability, not just yes/no
    gradient_checkpointing=True,   # 1,024-token inputs in 16 GB
    seed=0,
)
finetune(data="train.jsonl", model_dir="laya/multilingual",
         output_dir="ckpt/house-v2", config=cfg, device="mps")
Tre impostazioni da spiegare:
- 6 epoche, batch effettivo di 16: 516 aggiornamenti dell’ottimizzatore su 1.363 righe, con altre 151 tenute da parte per la calibrazione. I valori di default ne darebbero molti meno, e il codice stesso di Laya avverte che troppo pochi aggiornamenti possono far collassare il modello su una risposta costante, proprio il problema che cercavo di risolvere.
- Loss
soft-ceal posto del defaultrlcd: la soft cross-entropy è l’obiettivo naturale quando il target è una probabilità, e le note stesse di Laya dicono che il termine RL qui non dava alcun guadagno. - Gradient checkpointing: senza, le sequenze da 1.024 token non entrano nei 16 GB di memoria dell’M4. Non è esposto dalla CLI, ed è per questo che ho chiamato
finetune()da Python.
Si parte dai pesi base di Laya, non dalla copia di Jev cancellata. L’esecuzione ha richiesto 1 h 48 sulla GPU dell’M4 (MPS), niente è uscito dal portatile, e la loss è scesa da 0,45 a 0,27. Non può arrivare a zero quando l’obiettivo stesso è 0,6; sono i giorni tenuti da parte a dire se ha funzionato.
I risultati su giorni mai visti#
Ogni risposta viene trasformata in una decisione alla soglia che la mia automazione usa davvero, e confrontata con le etichette con il senno di poi, già riviste:
| Tenuti da parte | Jev | Laya, primo test (addestrato su Jev, cancellato) | Laya v2 (etichette con il senno di poi) |
|---|---|---|---|
| VMC 22–25 ott: stessa decisione delle etichette (244) | 84% | 79% | 83% |
| VMC: ordinamento delle situazioni (AUC) | 0,95 | 0,85 | 0,93 |
| VMC: boost mancati (su 53) | 29 | 43 | 37 |
| VMC: boost inutili | 10 | 8 | 4 |
| Tapparelle 22–25 ott (145, nessuna da abbassare) | 100% | 100% | 100% |
| Tapparelle estive 16–31 ago (98, 33 da abbassare) | mai interrogato | 66% | 90% |
| Tapparelle estive: abbassamenti mancati / inutili | 33 / 0 | 9 / 1 | |
| Domande rare, 22–25 ott (13) | 85% | 85% | 77% |
Per riferimento, Laya base ottiene il 22% sulla VMC e il 34% sulle tapparelle estive: dice sì a tutto.
Cosa ci leggo:
- Le tapparelle estive sono il vero guadagno. A Jev non è mai stato chiesto di abbassare le tapparelle d’estate, e il primo test, addestrato sulle risposte autunnali, aveva imparato solo “tienile su”. Addestrato su cinque mesi di statistiche, v2 le abbassa in 24 delle 33 situazioni in cui dovrebbe, e una sola volta quando non dovrebbe. È una decisione per cui prima la mia casa non aveva dati.
- Sulla VMC, v2 pareggia Jev; non lo batte. 83% contro 84%, e più prudente: meno boost inutili (4 contro 10), più boost mancati (37 contro 29). La maggior parte dei mancati è al limite. Per una ventola rumorosa preferisco questo lato, ma non è “meglio di Jev”.
- Viene valutato dal giudice da cui ha imparato. v2 ha imparato dalle etichette di Opus e viene valutato sulle etichette di Opus; Jev no. Questo favorisce v2. La mia revisione dei 52 casi controversi è l’unica verifica indipendente. La lettura onesta è “paragonabile a Jev sulla VMC, più le tapparelle estive”, non “batte Jev”.
- Lo stato delle tapparelle viene dalle statistiche orarie, una visione più grossolana di una richiesta in tempo reale. Prima che decida qualsiasi cosa, Home Assistant deve mandare lo stesso formato. È un lavoro per la prossima primavera.
- Ha imparato la mia casa, non a ragionare. Fategli domani una domanda nuova e siete di nuovo al modello base. E le 13 domande rare sono troppo poche per giudicare.
Servire il checkpoint#
La buona notizia: è lo stesso programma e la stessa immagine. laya-serve carica checkpoint aggiuntivi dalla variabile LAYA_EXTRA_MODELS, da una cartella locale o da un repository Hugging Face. La cartella del checkpoint pesa circa 650 MB (model.safetensors, rl_agent_config.json, questions.json, encoder/, tokenizer/; lo stato dell’ottimizzatore non serve).
Per una prova non toccherei il container in produzione. Basta un secondo servizio accanto:
services:
  laya-shadow:
    build: .                      # the Dockerfile above
    restart: unless-stopped
    environment:
      LAYA_EXTRA_MODELS: '{"house-v2": "/models/house-v2"}'
      LAYA_MODELS: house-v2
      LAYA_DEFAULT_MODEL: house-v2
      OMP_NUM_THREADS: "4"
    volumes:
      - ./house-v2:/models/house-v2:ro
    ports:
      - "8181:8000"
Con LAYA_DEFAULT_MODEL, Home Assistant non deve nemmeno indicare il modello; altrimenti manda "model": "house-v2". Funziona anche un repository Hugging Face privato con un HF_TOKEN, ma una cartella locale è più semplice e tiene i pesi sulla vostra rete. Attenzione alla RAM: il modello in sé richiede circa 1,3 GB, e docker stats mostra il mio attuale container Laya a circa 5 GB, page cache inclusa, su un box da 16 GB che fa girare anche altro. La velocità non cambia, dato che il modello ha la stessa dimensione: circa 1 secondo per una richiesta corta, 5 per una lunga.
Resta una modifica vera lato Home Assistant, e non è facoltativa: deve mandare gli stati su cui il modello è stato addestrato, lo stato compatto della VMC e lo stato delle tapparelle basato sulle statistiche. La richiesta completa per Jev verrebbe di nuovo tagliata a 1.024 token, e il modello vedrebbe qualcosa su cui non è mai stato addestrato.
Ne è valsa la pena?#
Come esperimento, sì, chiaramente. Qualche cosa che mi porto a casa:
- L’installazione è la parte facile. Un’API compatibile con Jev significa un container Docker e un URL in Home Assistant. Ed è davvero comodo.
- Controllate
truncatedprima di tutto il resto. Un modello che taglia in silenzio la fine della vostra richiesta sembrerà sicuro di sé e sbaglierà, e Home Assistant non ve lo dirà. - Un N100 basta per una casa, con circa 100 decisioni al giorno. Qui la lentezza non è un problema; i picchi sì, e le richieste più corte li risolvono meglio dell’hardware.
- Laya base non è un motore decisionale per stati numerici di una casa, e lo dicono i suoi autori. Con il fine-tuning diventa sorprendentemente bravo sulle mie domande, dopo meno di due ore di addestramento su un portatile.
- Copiare Jev era comunque l’obiettivo sbagliato. Termini a parte, una copia eredita gli errori di Jev e non impara niente là dove Jev non è mai stato interrogato. Le etichette con il senno di poi mi hanno dato le tapparelle estive, cosa che nessuna quantità di dati di Jev avrebbe potuto darmi.
- Un LLM con il senno di poi è un buon etichettatore, se lo verificate. Il recorder ha i fatti; il giudice li trasforma in 2.019 etichette calibrate; una persona deve comunque guardare i casi difficili.
- La casa gira ancora su Jev. v2 è abbastanza buono per la modalità shadow sulla VMC: Home Assistant interroga entrambi, agisce secondo Jev e registra Laya accanto. Le tapparelle si aggiungeranno la prossima primavera, quando il template manderà lo stato giusto.
La lezione più grande riguarda ancora i dati. Il mio scoreboard raccoglie le mie risposte a “chi aveva ragione?”, e le verifiche dei risultati registrano cosa è successo davvero dopo ogni decisione. Quelle etichette sono mie, non hanno bisogno di un giudice, e sono il miglior obiettivo in assoluto. Il giudice con il senno di poi è un modo per cominciare prima di averne mille; il prossimo addestramento li mescolerà entrambi.
Se fate girare Laya, o un qualsiasi modello compatibile con Jev, a casa, mi piacerebbe molto sapere come gestite la finestra di contesto e su cosa lo addestrate. I commenti sono aperti.
Come è stato realizzato#
Diverse sessioni di Claude Code con Opus 5.5. La prima è partita dal mio “sostituiamo Jev con Laya”, ha capito come l’integrazione parla con Jev, ha trovato il troncamento, ha misurato l’N100, ha letto i log dei prompt di OpenRouter nel browser (l’autenticazione l’ho fatta io), li ha rigiocati attraverso Laya, e ha testato ogni accorciamento rispetto al rumore di Jev prima di cambiare un solo template. Una seconda ha costruito il primo dataset, ha fatto girare il test addestrato su Jev sul mio MacBook e ha verificato come servire un checkpoint. Dopo che ho rivisto una prima bozza di questo articolo, una terza ha ricostruito cinque mesi di decisioni da una copia in sola lettura del recorder di Home Assistant, ha fatto etichettare 2.019 di esse a sub-agenti Opus con una griglia di criteri scritta, ha preparato i 52 casi controversi per la mia revisione, ha addestrato e valutato v2, ha cancellato il test addestrato su Jev e ha riscritto questo articolo. La mia parte è stata decidere cosa testare, insistere che le risposte di Jev non dovessero cambiare, rivedere i casi difficili del giudice, e decidere cosa tenere e cosa pubblicare.