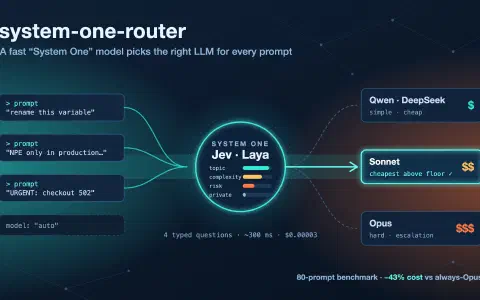
Dieci giorni fa, nell’articolo su system-one-router, ho messo alla prova due modelli decisionali “System One”: Jev, il modello ospitato di TypeSafe, e Laya, l’alternativa open weights di Convai Innovations. Il verdetto era netto. Jev era utilizzabile così com’è (89% di accuratezza sull’argomento, ben calibrato), Laya zero-shot no (59%, e così insicuro di sé che il router sovradimensionava quasi ogni richiesta). Chiudevo con: “se Laya viene sottoposto a fine-tuning prima che ci arrivi io, mi farebbe davvero piacere saperlo”.
Non ha scritto nessuno, quindi ci sono arrivato io. Dieci giorni sono tanti in questo angolo del mondo dell’AI: Laya ha pubblicato 18 release, sono comparsi diversi nuovi modelli simili a Jev, e il README di Laya adesso lo dice chiaramente, considerate Laya come una base veloce da specializzare, non come un motore decisionale zero-shot. Questo articolo fa quindi tre cose:
- rilancia il benchmark con il nuovo Laya e tre nuovi modelli open;
- fa il fine-tuning di Laya sulle mie etichette, sul mio MacBook M4, con i comandi, gli output e i tempi reali;
- torna a casa mia, dove Jev ora giudica le mie automazioni di Home Assistant, e rigioca 80 decisioni reali attraverso Laya per verificare quello che avevo detto sul farlo girare in locale.
Come la volta scorsa, la macchina di test è un Apple M4 con 16 GB di RAM.
Laya 0.3.6 → 0.3.24: codice nuovo, stesso modello#
Tra il primo benchmark (23 settembre) e oggi, Laya è passato per 18 release: autocast MPS, riuso del tokenizer, raggruppamento per lunghezza, correzioni al routing per lingua, strumenti per la temperatura, un SDK TypeScript… Tutto codice di runtime. I pesi e i file di calibrazione su Hugging Face sono identici byte per byte a quelli che avevo provato la prima volta, quindi mi aspettavo numeri identici, ed è quello che ho ottenuto:
| 0.3.6 | 0.3.24 | |
|---|---|---|
| Laya inglese, accuratezza sull’argomento | 59% | 59% |
| Laya multilingue, accuratezza sull’argomento | 45% | 45% |
| Laya auto, accuratezza sull’argomento | 58% | 56% (un prompt) |
| Errore di calibrazione, latenza | — | entro 0,003 e 10 ms |
L’aggiornamento è sicuro, e per il routing non cambia niente. Anche Jev, rimisurato lo stesso giorno, si è mosso appena: 89% di accuratezza sull’argomento, 72% di route identiche a quella di riferimento, 268 ms di latenza mediana.
I nuovi arrivati#
Quando ho scritto il primo articolo, Laya era *l’*alternativa open. Adesso non più. Ho scelto quelli con licenza Apache-2.0, che girano su un Mac da 16 GB e che dichiarano di non essere stati addestrati sugli output di Jev. Quest’ultimo punto conta: il contratto cliente di TypeSafe vieta di usare l’output di Jev “to perform model distillation” o per addestrare un modello che lo imiti, e alcuni dei modelli della community sono esattamente questo.
- Laya typed-decisions: un terzo checkpoint che stava nel repository di Laya fin dall’inizio. È il modello inglese con fine-tuning sul dataset typed-decisions (2.000 decisioni su quattro workflow).
- Von 1.3: un ModernBERT-large da 395M con una testa a marcatori di opzione, contesto da 8k, solo inglese.
- Kev-0.8B: una LoRA più una testa a puntatore su Qwen3.5-0.8B, servita tramite MLX. Il Kev-4B consigliato richiede un Mac da 32 GB, quindi non ho potuto provarlo.
Tutti e tre parlano lo stesso formato di richiesta di Jev, quindi a system-one-router non è servito nessun adattatore, solo un URL. Il benchmark da 80 prompt, stessi prompt, stesso router, stessa configurazione:
| Jev 1.13 | Laya inglese | Laya typed-decisions | Von 1.3 | Kev-0.8B | |
|---|---|---|---|---|---|
| Accuratezza sull’argomento | 89% | 59% | 71% | 70% | 81% |
| Complessità esatta | 72% | 45% | 41% | 55% | 42% |
| Rischio esatto | 61% | 31% | 34% | 46% | 49% |
| Risposte sicure (≥ 0,8) | 84% (94% giuste) | 12% | 0% | 74% (75% giuste) | 5% |
| Errore di calibrazione (più basso è meglio) | 0,068 | 0,171 | 0,509 | 0,226 | 0,349 |
| Stessa route del riferimento | 72% | 20% | 12% | 48% | 22% |
| Modello più economico / più caro del riferimento | 3 / 19 | 3 / 61 | 0 / 70 | 15 / 27 | 4 / 58 |
| Costo stimato dei modelli (riferimento 1,18 $, sempre Opus 2,40 $) | 1,37 $ | 1,74 $ | 2,32 $ | 0,99 $ | 1,16 $ |
| Latenza della decisione p50 | 268 ms | 300 ms | 334 ms | 216 ms | 371 ms (MLX) |
Tre personalità diverse:
- Laya typed-decisions è il miglior Laya sull’argomento (71%), ma non è mai sicuro. Neanche una volta su 80 prompt. Il router tratta ogni decisione come incerta, alza la complessità e manda 70 prompt su 80 su un modello più caro del necessario. È il router più costoso della tabella, e ognuna delle sue decisioni è gratis.
- Von è quello che si avvicina di più al riferimento senza alcun ritocco (48%), ed è il più economico. Ma in parte per il motivo sbagliato: è troppo sicuro di sé, e 15 prompt finiscono su un modello troppo debole per loro. In un router, è la direzione sbagliata in cui sbagliare.
- Kev-0.8B è il miglior classificatore di argomento tra gli open: 81%, e 100% sui prompt multilingue, con un modello da 0,8B. Ma è molto poco sicuro di sé, quindi sovradimensiona come Laya.
Il report interattivo mette tutti e sette i provider fianco a fianco, prompt per prompt.
Un trucco economico prima dell’addestramento: riscalare la confidenza#
Riguardate la tabella: per Kev e Laya typed-decisions, il problema non sono tanto le “risposte sbagliate” quanto le “risposte giuste date con il 40% di confidenza”. E il mio router, per come è progettato, punisce la bassa confidenza. Un modello che ha ragione ma è insicuro costa comunque soldi.
La correzione da manuale è il temperature scaling: dividere i logit per una costante T prima della softmax. Non cambia quale opzione vince, solo quanto il modello sembra sicuro. Ho aggiunto a system-one-router una temperature opzionale per provider, e ho stimato T su metà dei prompt, misurando sull’altra metà (20 suddivisioni casuali):
| Kev-0.8B | Laya typed-decisions | Von 1.3 | |
|---|---|---|---|
| T stimata | 0,47 | 0,43 | 2,47 |
| Errore di calibrazione, prima → dopo | 0,349 → 0,059 | 0,509 → 0,072 | 0,226 → 0,236 |
| Stessa route del riferimento, prima → dopo | 22% → 39% | 12% → 25% | 48% → 36% |
Con T = 0,47, Kev è calibrato quanto Jev (0,059 contro 0,068). Per Von non serve: i suoi errori sono errori sicuri, e nessun riscalamento può separare una risposta sbagliata data con sicurezza da una giusta data con la stessa sicurezza. Un’avvertenza onesta: 80 prompt sono pochi, quindi prendete questi valori come un punto di partenza.
Ma anche un Kev perfettamente calibrato coincide con la route di riferimento solo nel 39% dei casi. Il collo di bottiglia si è spostato: per tutti i modelli open, l’argomento non è più la parte debole; lo sono complessità e rischio. E nessuna temperatura insegnerà a un modello cosa significa “complessità 2” nella mia configurazione. Per quello serve l’addestramento.
Fine-tuning di Laya su un MacBook#
Il README di Laya è molto diretto in proposito: sul benchmark typed-decisions, i checkpoint di base zero-shot sono vicini al caso (0,36 contro una baseline casuale di 0,32), e quello con fine-tuning arriva a 0,766, sopra lo 0,727 pubblicato per Jev. Convai fornisce due percorsi di addestramento: un notebook Kaggle per due GPU T4 gratuite, e uno script standalone per Apple Silicon. Il metodo si chiama RLCD: un passo di policy gradient la cui ricompensa è una proper scoring rule (premia una probabilità quando è allo stesso tempo giusta e onesta), combinato con una normale cross-entropy, poi una stima della temperatura per tipo di domanda. Ho letto lo script prima di lanciarlo, come avevo fatto per il pacchetto: download da Hugging Face, safetensors, nessun codice remoto.
Prima regola: addestrare sulle proprie etichette, non su quelle di Jev#
Nell’articolo sul router, il mio piano era il “fine-tuning di Laya sulle decisioni di Jev registrate”. La modalità shadow le stava persino registrando per me. Ho abbandonato quel piano: addestrare un modello sulle risposte di Jev è esattamente la distillazione che i termini di TypeSafe vietano. E, a pensarci bene, era comunque l’obiettivo sbagliato. Non voglio una copia di Jev; voglio un modello che sappia cosa significa “complessità 2” nella mia configurazione.
Quindi le etichette devono essere mie. Per questo esperimento mi servivano più degli 80 prompt del benchmark (che devono restare un test set), così ho fatto scrivere all’agente 480 nuovi prompt etichettati: 48 per argomento, complessità da 0 a 3, rischio da 0 a 2, il 10% con segreti o dati personali (palesemente finti), 45 in francese, italiano, spagnolo o tedesco, 30 lunghi con stack trace o diff, qualche prompt injection. Poi ho controllato che non si sovrapponessero al benchmark: la coppia più vicina condivide un terzo delle parole (“fix it” contro “deploy it”). Nella vita reale, la fonte migliore è il proprio traffico: richieste registrate, etichettate a mano, più i risultati delle verifiche e dei feedback che il gateway registra già.
Passo 1: setup (5 secondi e 800 MB)#
uv venv --python 3.12 train/.venv
uv pip install --python train/.venv/bin/python laya==0.3.24 datasets pyyaml
mkdir -p train/work && cd train/work
curl -sLO https://raw.githubusercontent.com/NandhaKishorM/laya/v0.3.24/notebooks/laya_finetune_typed_decisions_mps.py
# solo il checkpoint inglese, non tutto il repository
../.venv/bin/python -c "from huggingface_hub import snapshot_download as s; \
  s('convaiinnovations/laya', local_dir='laya_base', \
    allow_patterns=['model.safetensors','rl_agent_config.json','encoder/*','tokenizer/*'])"
Passo 2: trasformare le etichette in elementi di addestramento#
È il passo in cui è facile sbagliare in modo sottile. Il modello va addestrato esattamente su quello che vedrà in inferenza: la stessa formulazione delle domande, le stesse opzioni nello stesso ordine, la stessa forma dello stato. Per questo train/build_items.py importa il build_sequence di Laya e ricostruisce parola per parola le quattro domande del router. Una trappola che ho scoperto solo leggendo il codice Go: il gateway manda gli argomenti come una map Go, e l’encoder JSON di Go ordina le chiavi delle map. Quindi Laya vede le opzioni in ordine alfabetico, non nell’ordine di config.yaml, e gli elementi di addestramento devono rispettarlo.
Ogni prompt diventa quattro elementi (argomento, complessità, rischio, dati privati). Gli obiettivi sono le etichette con un po’ di smoothing (90% sull’etichetta, il resto soprattutto sui livelli vicini per i punteggi), perché obiettivi rigidi al 100% insegnano a un modello a essere troppo sicuro di sé:
train/.venv/bin/python train/build_items.py train/data/train_cases.json train/work/route_items.pt
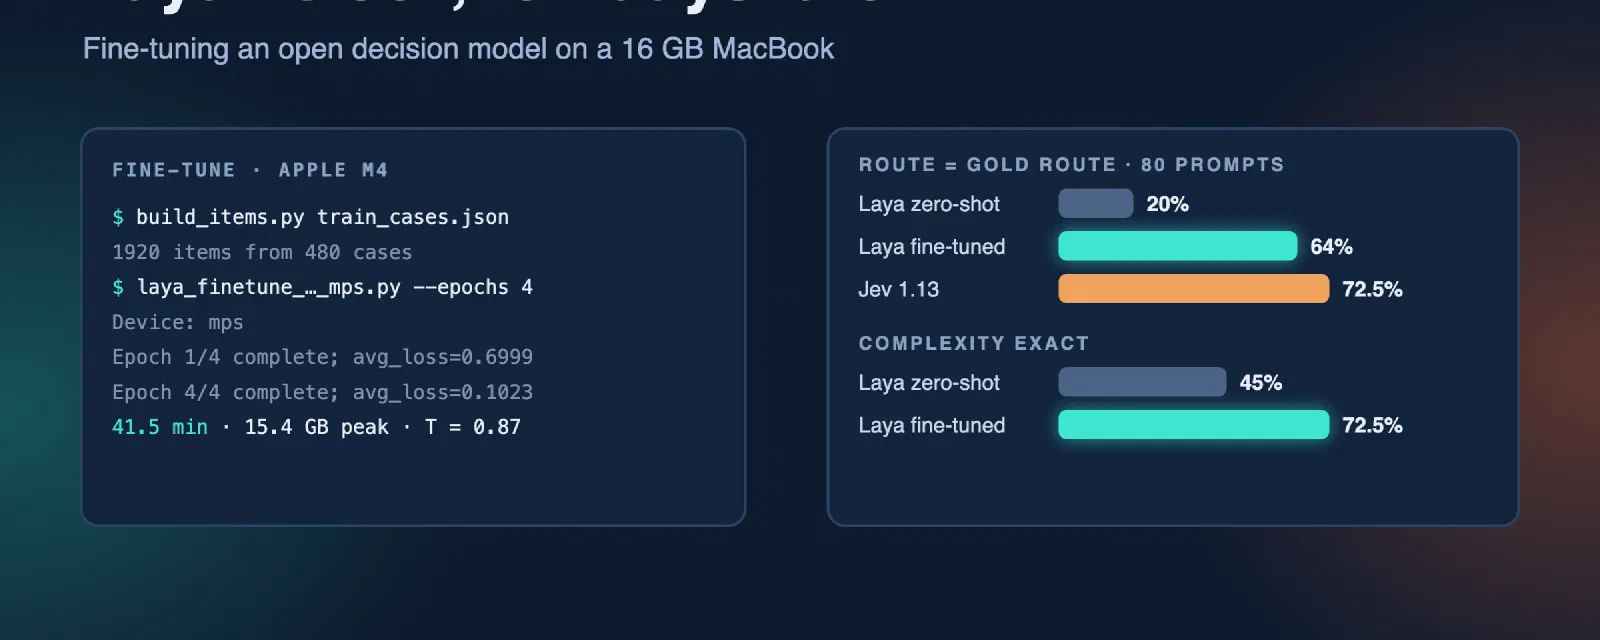
1920 items from 480 cases -> train/work/route_items.pt (skipped 0)
Passo 3: addestramento (41 minuti)#
La raccomandazione di Convai per un MacBook da 16 GB è un esempio alla volta, con i gradienti accumulati su 32:
cd train/work
../.venv/bin/python laya_finetune_typed_decisions_mps.py --model-dir ./laya_base \
  --items ./route_items.pt --output-dir ./laya-route \
  --micro-batch 1 --grad-accum 32 --epochs 4
00:10:39 Using legacy cached training items without metadata: route_items.pt
00:10:40 Device: mps
00:10:40 Training items: 1728; calibration items: 192
00:10:40 micro_batch=1; grad_accum=32; epochs=4
00:11:18 epoch 1/4, step 100, loss=0.9694
...
00:21:04 Epoch 1/4 complete; avg_loss=0.6999
00:31:16 Epoch 2/4 complete; avg_loss=0.2924
00:41:27 Epoch 3/4 complete; avg_loss=0.0979
00:51:44 Epoch 4/4 complete; avg_loss=0.1023
00:51:47 Running temperature calibration ...
00:52:01 Model saved to ./laya-route
00:52:01 Temperatures: [1.25038480758667, 1.4553054571151733, 1.0085362195968628](La riga “legacy cached items” è prevista: quando --items esiste già, lo script salta il proprio dataset.) Lo script tiene da parte il 10% degli elementi per la stima della temperatura, e tra un attimo tornerà utile.
| Apple M4, 16 GB, nient’altro in esecuzione | |
|---|---|
| Tempo reale, 4 epoche | 41,5 minuti, circa 10,3 minuti per epoca |
| Velocità | ~0,36 s per elemento di addestramento |
| Picco di memoria | 15,4 GB: chiudete il browser |
| Output | un checkpoint da 1,6 GB |
Quanto ci vorrebbe per voi? Con prompt brevi come i miei, contate circa 0,36 s per elemento per epoca, e quattro elementi per prompt etichettato: 4 epoche su N prompt richiedono più o meno N × 6 secondi. 500 prompt: meno di un’ora. 2.000 prompt: circa 3 ore, una notte. Per confronto, ho lanciato anche la ricetta ufficiale sul suo dataset (6.000 elementi, con stati più lunghi): andava a 0,58 s per elemento, quindi le sue 4 epoche richiederebbero circa 3,6 ore su questo portatile. Ho misurato i primi 700 step e l’ho fermata lì. Due cose che ho provato e che non sono servite: i micro-batch da 8 erano più lenti su 16 GB, non più veloci, e far girare qualcosa di pesante nello stesso momento (il mio replay di Home Assistant, più sotto) rallentava visibilmente entrambi.
Passo 4: funziona?#
Il sidecar ha guadagnato un’opzione --checkpoint NAME=DIR per servire un checkpoint locale, e il benchmark un provider corrispondente laya:NAME:
sidecar/.venv/bin/python sidecar/laya_server.py --checkpoint laya-route=train/work/laya-route &
go run ./cmd/bench -providers jev,laya,laya:laya-route
jev laya laya:laya-route
topic accuracy 88.8% 58.8% 85.0%
topic acc · tricky 42.9% 28.6% 100.0%
complexity exact / ±1 72.5% / 100.0% 45.0% / 98.8% 72.5% / 98.8%
risk exact 61.3% 31.2% 68.8%
confident (≥ threshold) share 85.0% 12.5% 0.0%
ECE (lower = better calibrated) 0.070 0.171 0.311
route = gold-label route 72.5% 20.0% 35.0%
under / over-provisioned 3 / 19 3 / 61 1 / 51Il salto di accuratezza è reale: argomento dal 59% all'85%, complessità dal 45% al 72,5%, come Jev, rischio dal 31% al 69%, meglio di Jev. E poi la riga della confidenza: 0%. Nessuna decisione ha raggiunto la soglia di 0,8 del router, quindi va ancora sul sicuro e sovradimensiona 51 prompt. Stessa malattia di prima, in un modello più intelligente.
La causa è in parte mia: lo smoothing delle etichette dice al modello “non essere mai sicuro più del 90%”, e il router legge il campo confidence di Laya, che è più severo della probabilità massima. La soluzione è la temperature di prima, ma stimata onestamente: non sul benchmark, ma sui 192 elementi che l’addestramento aveva tenuto da parte. Un piccolo script fa al checkpoint servito la domanda sull’argomento per quei prompt tenuti da parte e trova la T che minimizza la log-loss:
train/.venv/bin/python train/fit_temperature.py train/data/train_cases.json train/work/route_items.pt
52 held-out cases, topic accuracy 79%, log-loss 0.766 at T=1 -> 0.748 at T=0.87
go run ./cmd/bench -providers laya,laya:laya-route -temperature laya:laya-route=0.87
La colonna di Jev viene dal run della stessa notte, da qui le piccole differenze con la tabella iniziale (0,070 invece di 0,068, per esempio).
| Jev 1.13 | Laya zero-shot | Laya con fine-tuning | Laya con fine-tuning, T = 0,87 | |
|---|---|---|---|---|
| Accuratezza sull’argomento | 89% | 59% | 85% | 85% |
| Complessità esatta | 72,5% | 45% | 72,5% | 72,5% |
| Rischio esatto | 61% | 31% | 69% | 69% |
| Risposte sicure (≥ 0,8) | 85% (94% giuste) | 12,5% | 0% | 86% (90% giuste) |
| Errore di calibrazione | 0,070 | 0,171 | 0,311 | 0,082 |
| Stessa route del riferimento | 72,5% | 20% | 35% | 64% |
| Modello più economico / più caro del riferimento | 3 / 19 | 3 / 61 | 1 / 51 | 9 / 20 |
| Costo stimato dei modelli (riferimento 1,18 $) | 1,35 $ | 1,74 $ | 1,80 $ | 1,28 $ |
| Latenza della decisione p50 (GPU M4) | 250 ms | 283 ms | 308 ms | 319 ms |
| Costo della decisione | 0,04 $ / 1k | 0 $ | 0 $ | 0 $ |
Dal 20% al 64% di route identiche a quella di riferimento, con una calibrazione quasi buona quanto quella di Jev, e un costo di routing leggermente inferiore a quello di Jev. Per 41 minuti su un portatile e 480 prompt etichettati, è molto più di quanto mi aspettassi. Di tutti i modelli open che ho provato, è il primo che prenderei davvero in considerazione di collegare al gateway.
Ora le avvertenze, perché contano:
- L’etichettatore è lo stesso. I 480 prompt di addestramento e le 80 etichette di riferimento sono stati scritti dallo stesso tipo di etichettatore (un agente LLM che segue le stesse convenzioni). Parte del guadagno è il modello che impara l’idea di complessità e rischio di *quell’*etichettatore. È proprio lo scopo del fine-tuning (è l’idea della mia configurazione, non una generica), ma è anche il motivo per cui può battere Jev sul rischio. Con le etichette di qualcun altro, il divario sarebbe più piccolo.
- I gruppi sono minuscoli. Il 100% sul gruppo “trabocchetto” suona benissimo, ma sono 7 prompt.
- È meno prudente di Jev. 9 prompt vanno su un modello più debole del riferimento, contro 3 per Jev. È la direzione che mi piace di meno. Una
confidence_thresholdo una temperatura più alta scambierebbero un po’ di risparmio con un po’ di sicurezza. - Jev vince ancora sulla parte difficile: quando è sicuro, ha ragione il 94% delle volte, e lo fa zero-shot, su qualsiasi domanda inventiate domani. Il mio Laya è bravo su queste quattro domande. Chiedetegli qualcos’altro, e siete di nuovo al modello di base.
La ricetta, gli script e i prompt etichettati sono nel repository: docs/fine-tuning.md.
Ritorno a casa: Laya può giudicare le mie automazioni?#
Il router è un caso d’uso. L’altro, quello che gira 24 ore su 24, è la mia casa: dal primo articolo su Home Assistant, Jev risponde alle domande “è normale?” che le mie regole a soglia non sanno gestire, sempre accanto alla regola, prima in modalità shadow. Nel secondo, un lettore su Mastodon chiedeva perché non un modello locale piccolo, e avevo spiegato perché non ero passato al locale su un mini PC N100. Era il momento buono per verificare quella risposta con i numeri invece che con gli argomenti.
Prima di tutto, come se la cava Jev in casa#
Lo scoreboard è stato azzerato domenica 27 settembre, quindi questa è una settimana dei nuovi prompt (con lo storico compatto e la base dell’umidità del secondo articolo), presa direttamente dall’istanza live:
| Decisione | Interrogato | In disaccordo con la regola | Feedback “chi aveva ragione?” |
|---|---|---|---|
| VMC (scelta della velocità) | 265 | 17 (6%) | Jev 3, regola 0 |
| Tapparelle contro caldo (sì/no per tapparella) | 198 | 6 (3%) | — |
| Irrigazione stasera? | 5 | 0 | — |
| Simulazione di presenza (scelta della stanza) | 4 | 4 | — |
| Bucato, acqua, calo di temperatura, scaldabagno | 6 | 0 | — |
La riga interessante è la VMC. Nel secondo articolo, era in disaccordo con la regola a ogni singola chiamata, sempre con una confidenza troppo bassa per agire. Con lo storico nel prompt, adesso è in disaccordo il 6% delle volte, e sui tre disaccordi a cui ho risposto dalla notifica sul telefono, Jev aveva ragione tutte e tre le volte (uno di questi, una doccia venerdì sera, è tra gli esempi qui sotto). La simulazione di presenza è nuova ed è ancora nella fase “Jev e la regola scelgono stanze diverse”, il che va bene: lì la regola è una scelta casuale pesata, quindi il disaccordo è previsto.
Sul fronte dei costi, niente di nuovo: ieri 84 chiamate, 118k token in input, mezzo centesimo.
Rigiocare 80 decisioni reali della casa attraverso Laya#
Per confrontare Laya con Jev su domande di casa invece che su prompt di routing, mi servivano le richieste reali. Home Assistant registra solo il risultato di ogni decisione (“jev=True (p=0.71) rule=False”), non i dati che ha mandato, quindi le ho fatte ricostruire a Claude Code, in sola lettura:
- le definizioni delle domande (istruzioni, opzioni, soglie) vengono direttamente dal repository della mia configurazione;
- i dati attuali sono stati generati sull’istanza live con i template veri;
- i momenti passati, soprattutto i disaccordi registrati, sono stati ricostruiti dal registro, dal sensore della timeline e dalle letture del recorder. Per 11 dei 19 momenti registrati, una nuova chiamata a Jev ha riprodotto la probabilità registrata entro ±0,1, quindi la maggior parte delle ricostruzioni è fedele, ma non tutte;
- ogni payload è andato a Jev, a Laya inglese e a Laya multilingue, questi ultimi due sulla CPU con 4 thread, per avvicinarmi al mio N100 a 4 core.
80 payload in totale, 80 chiamate a Jev, 0,0043 $. I risultati, con ogni risposta trasformata in sì/no alla soglia che l’automazione usa davvero (0,6 per la VMC, 0,7 per le tapparelle e l’irrigazione, 0,8 per l’acqua):
| Decisione | n | Laya EN = Jev | Laya multilingue = Jev | p di Jev | p di Laya EN | p di Laya multilingue |
|---|---|---|---|---|---|---|
| VMC | 19 | 15 | 4 | 0,07 – 0,75 | 0,52 – 0,61 | 1,00, sempre |
| Tapparelle | 18 | 15 | 3 | 0,14 – 0,86 | 0,54 – 0,57 | 0,72 – 0,99 |
| Flusso d’acqua | 15 | 12 | 4 | 0,09 – 0,85 | 0,46 – 0,54 | 0,85 – 0,98 |
| Irrigazione | 12 | 12 | 0 | 0,12 – 0,61 | 0,52 – 0,54 | 0,98 – 0,99 |
Non fatevi ingannare dalla colonna “Laya EN = Jev”. Laya inglese risponde circa 0,5 a tutto: le sue probabilità vanno da 0,46 a 0,61 su 64 domande sì/no. È “d’accordo” con Jev solo perché 0,5 sta sotto ogni soglia, quindi non agisce mai, e di solito neanche Jev lo fa. La sua correlazione di rango con le probabilità di Jev è persino leggermente negativa sulla VMC e sulle tapparelle. Il checkpoint multilingue ha il problema opposto: dice sì quasi a tutto, con grande sicurezza, anche a “la luce della cucina è accesa?” quando lo stato dice che è spenta.
Quattro momenti lo rendono concreto:
- Venerdì alle 20:00, una doccia. Umidità del bagno al piano di sopra dal 67% all'82%, aria esterna più secca di quella interna. Jev: 0,75, alza la VMC (e quella sera avevo risposto “Jev aveva ragione” dal telefono). Laya EN: 0,52, no. Laya multilingue: 1,00.
- Venerdì alle 19:56, 11 L/min d’acqua appena rientrati a casa. Jev: normale (0,67), causa “doccia o bagno” a 0,93. Laya EN: 0,49, causa “altro” a 0,06. Laya multilingue: 0,96, causa “sciacquone che perde”.
- Una perdita notturna. 0,8 L/min, piatti, per ore, alle 04:30, nessuna variazione di umidità da nessuna parte. Jev: 0,11, sospetto, causa “perdita”. Laya multilingue: 0,97, normale. È sopra la soglia di 0,9 per le perdite, quindi in modalità active avrebbe soppresso l’allarme perdita. È quello che costerebbe soldi.
- Pomeriggio caldo, soggiorno, 27,8 °C fuori e pieno sole. Jev: 0,86, abbassa le tapparelle. Laya EN: 0,54. Laya multilingue: 0,99, ma diceva 0,94–0,97 anche nei giorni freschi e piovosi.
E il lato pratico:
| Jev (rete) | Laya EN, CPU 4 thread | Laya multilingue, CPU 4 thread | |
|---|---|---|---|
| Latenza, mediana / p95 | 310 / 479 ms | 684 / 2.221 ms | 329 / 1.635 ms |
| Acqua (3 domande in una chiamata) | 315 ms | 1.487 ms | 1.435 ms |
| Payload tagliati dalla finestra di contesto | 0 / 80 (32k token) | 64 / 80 (512 token) | 34 / 80 (1.024 token) |
Parliamo di un core M4, molto più veloce di un core N100, quindi sul mini PC moltiplicate per “parecchio”. Parte del p95 è anche colpa mia: il primo tentativo del fine-tuning qui sopra girava sulla GPU nello stesso momento.
Dove avevo sbagliato negli articoli precedenti#
Rigiocare richieste reali insegna l’umiltà, quindi correggo tre cose che avevo scritto:
- “Le mie richieste stanno intorno ai 300 token di testo reale, che entrano nei 512.” Era vero per la prima versione. Da quando il secondo articolo ha aggiunto lo storico compatto a ogni decisione, le richieste sono da 1.000 a 1.900 token. La cura per “Jev non ha memoria” è esattamente ciò che le rende troppo lunghe per Laya inglese: legge meno di metà di una richiesta della VMC. Per Jev, con 32k token, non è niente.
- “Userei il checkpoint multilingue, che tra l’altro capisce meglio i nomi in francese delle mie entità.” I payload sono in inglese per scelta (solo qualche nome di entità e “Vitesse 2” sono in francese), e qui il checkpoint multilingue è il peggiore dei due. La lingua non è mai stata il problema. E mandare una richiesta più corta, senza le serie dello storico, non ha aiutato nessuno dei due checkpoint.
- “Quando Laya è sicuro, ci azzecca.” Vero sui prompt di routing. Sulle domande di casa, Laya inglese semplicemente non è mai sicuro, e quello multilingue è sicuro e sbaglia. Il benchmark del routing non si è trasferito, il che ricorda bene che un benchmark misura le sue domande.
La conclusione del secondo articolo regge, adesso con i numeri: sul mio hardware e con le mie domande, Laya zero-shot non è un’opzione, e non è una questione di CPU. La casa resta su Jev.
Le alternative, dal lato di Home Assistant#
Se volete provarci comunque, anche l’ecosistema si è mosso in fretta. HA-Jev, l’integrazione che uso (sensori, azioni jev.noul / jev.choice / jev.score / jev.ask, un agente Assist), funziona ancora solo con Jev nel cloud e si installa come repository personalizzato di HACS; ne esistono diversi fork. Ci sono anche componenti più mirati come ha-conversation-jev (una scorciatoia Jev per luci, clima e tapparelle) e “Gut Check”, un controllo settimanale della salute dell’installazione. Per i modelli locali, il ponte più pratico che ho trovato è Decidealot, un servizio Docker che serve Laya, Von o CLM dietro un’API REST compatibile con TypeSafe: in teoria, basta puntarci l’indirizzo personalizzato di HA-Jev. Non l’ho provato, e dopo il replay qui sopra ci collegherei solo un modello con fine-tuning.
Prossimi passi#
A che punto sono i due progetti:
- system-one-router: il Laya con fine-tuning diventa un’opzione concreta per
decision.provider: auto, dove i prompt privati vengono decisi in locale. Prima di usarlo come provider principale, voglio addestrarlo su traffico reale: qualche centinaio di richieste registrate ed etichettate a mano, più i risultati delle verifiche e dei feedback che il gateway registra già. Kev, che arriva con il suokev-finetune, merita lo stesso trattamento, idealmente nella versione 4B su una macchina più grossa. - Home Assistant: la casa resta su Jev. La strada verso un modello locale però adesso è chiara: le risposte “chi aveva ragione?” dello scoreboard e le verifiche automatiche dei risultati (la pompa si è davvero fermata, l’allarme perdita era o non era una perdita) sono etichette mie, non di Jev. Qualche settimana di quelle, un fine-tuning del checkpoint multilingue con la sua finestra da 1.024 token (o un payload più piccolo, la parte lunga è lo storico), e la cosa diventa interessante. Al ritmo attuale dei disaccordi, però, raccoglierne abbastanza richiederà un po’ di tempo, il che è anche una buona notizia per Jev.
Lezioni imparate#
- Una nuova versione non è un nuovo modello. 18 release di Laya, zero cambiamenti nei numeri: i pesi non si sono mossi. Controllate cosa è cambiato davvero prima di rilanciare un benchmark, e rilanciatelo comunque.
- I modelli decisionali zero-shot sono una base, non un prodotto. Lo dice il README stesso di Laya, e lo dimostra il salto dal 20% al 64% di route giuste dopo 41 minuti di addestramento.
- La calibrazione è metà del lavoro, di nuovo. Il modello con fine-tuning è passato da “mai sicuro” a “calibrato quanto Jev” con un solo numero, T = 0,87. Stimatelo su dati tenuti da parte, mai sul vostro test set.
- Addestrate sulle vostre etichette. È quello che richiedono i termini di TypeSafe, ed è anche quello che volete davvero: un modello che conosce le vostre definizioni, non una copia di quelle di qualcun altro.
- Basta un portatile. 480 prompt, 41 minuti, 15 GB di memoria. La parte costosa sono le etichette, non la GPU.
- Rigiocate richieste reali prima di credere a un benchmark. Il benchmark del routing diceva “quando Laya è sicuro, ci azzecca”. La mia casa ha detto altro, e lo storico che ho aggiunto per Jev ha comunque reso le richieste troppo lunghe per Laya.
Il codice, gli script di addestramento e i 480 prompt etichettati sono su GitHub: mmornati/system-one-router, e il report del benchmark è online. Se fate il fine-tuning di un modello decisionale sui vostri dati, soprattutto per Home Assistant, mi piacerebbe davvero confrontarci nei commenti.
Come è stato costruito#
Stesso setup degli articoli precedenti: una sessione di Claude Code con Opus 5.5. Una prima sessione aveva aggiornato Laya, aggiunto Von e Kev al benchmark e aperto la pull request. Questa ha verificato quel lavoro, cercato i modelli più recenti, misurato la ricetta di addestramento ufficiale, scritto i 480 prompt etichettati (con un sub-agente) e gli script di addestramento, lanciato il fine-tuning e i benchmark, e rigiocato le decisioni di Home Assistant (con un altro sub-agente, in sola lettura sull’istanza live). La mia parte è stata scegliere cosa misurare, mettere in discussione i risultati (la riga con lo 0% di confidenza è stato il momento di fermarsi a riflettere) e decidere cosa tenere.