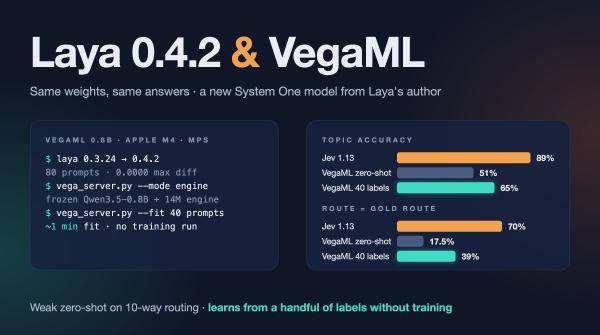
Laya ha pubblicato otto release e per il routing non è cambiato nulla. Il suo autore ha anche pubblicato VegaML, un modello decisionale che risponde lasciando che una particella si fermi in una valle. In zero-shot non è pronto per il mio router, ma può imparare da 40 etichette in un minuto, cosa che nessuno degli altri modelli sa fare.
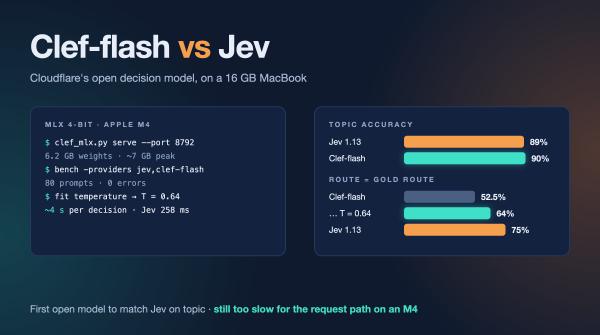
Tre giorni dopo l’annuncio di Cloudflare, Clef-flash ha affrontato lo stesso benchmark da 80 prompt di Jev, Laya, Von e Kev. 90% di accuratezza sull’argomento, una temperatura di confidenza che lo porta al livello di Jev sulla calibrazione, e un problema che nessuna temperatura può risolvere su un portatile.
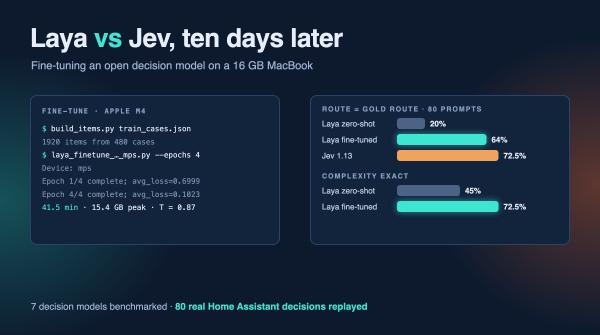
Laya dice “fammi il fine-tuning”, e l’ho fatto, su un MacBook da 16 GB. Ecco la ricetta, quanto ci vuole, cosa cambia sul benchmark da 80 prompt, e perché la mia casa gira ancora su Jev.
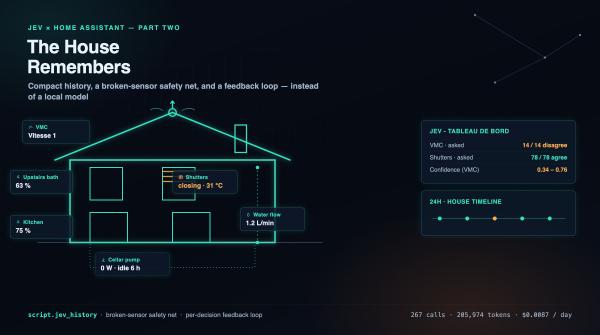
La cura per “Jev non ha memoria” non era un modello diverso. Era dargli una memoria. Ecco lo script dello storico, il ciclo di feedback, e su cosa lo scoreboard live è già in disaccordo.
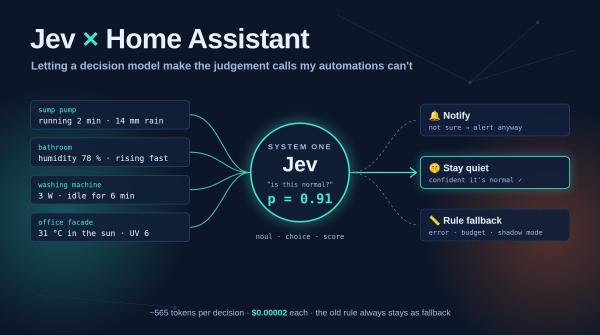
Le mie automazioni sono brave con le soglie e negate con il contesto. Jev risponde a domande tipizzate con una probabilità calibrata, per circa due millesimi di centesimo a domanda. Ecco come l’ho collegato a Home Assistant tenendo le vecchie regole come rete di sicurezza, e quanto costa davvero.
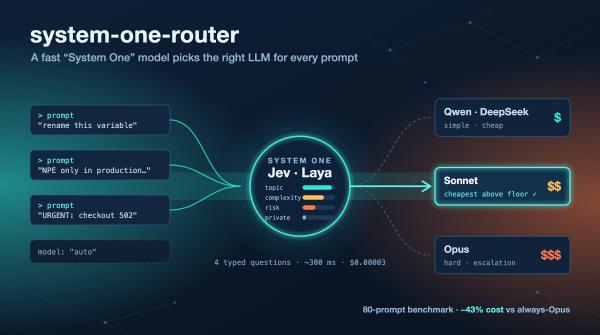
Il mio primo router di modelli lasciava a un LLM il compito di leggere un file di prompt e scegliere un agente. Questo fa quattro domande tipizzate a un modello decisionale “System One”, calcola il punteggio dei modelli con semplice aritmetica, e pubblica un benchmark per dimostrare che funziona (e per mostrare dove non funziona).