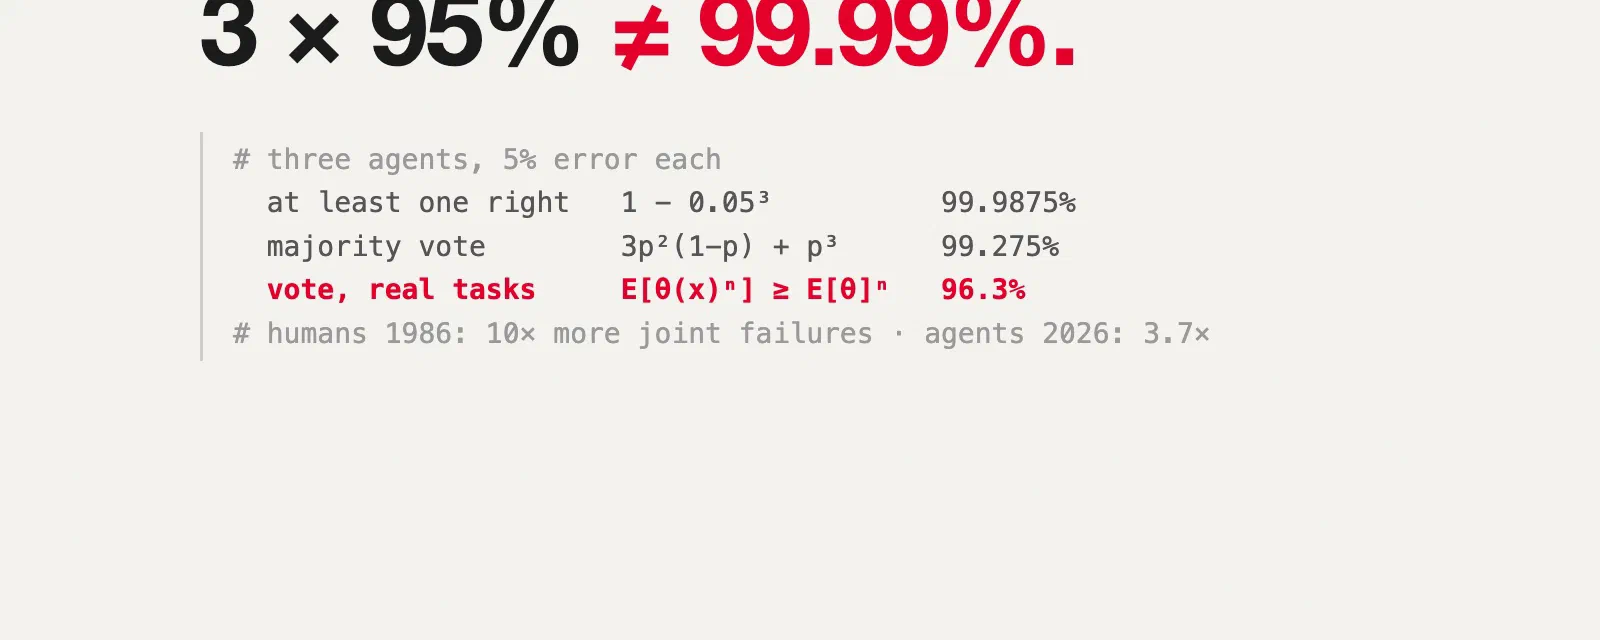
Ogni risposta di un LLM arriva con un tasso di errore. Anche un ottimo agente di programmazione sbaglia qualche compito: diciamo uno su venti, il 5%. Non possiamo portare quel numero a zero, ma la statistica ha un vecchio trucco per le misure poco affidabili: non fidarsi di una sola, prenderne diverse. Se affidiamo lo stesso compito a più agenti, la probabilità che sbaglino tutti dovrebbe crollare in fretta. Con tre agenti al 5% di errore ciascuno, la probabilità che almeno uno abbia ragione è:
1 - 0.05 × 0.05 × 0.05 = 99.9875%È il numero dietro ogni presentazione del tipo “usa più agenti”, ed è quello che avevo in testa quando ho cominciato a usare un secondo modello per fare la review delle pull request del primo. La vera domanda è se regge, e per verificarlo non serve un nuovo esperimento. Decenni di ingegneria dell’affidabilità forniscono già i dati: un rapporto della NASA del 1985, un famoso esperimento del 1986 con programmatori umani, due repliche con agenti di programmazione pubblicate quest’estate, oltre a benchmark pubblici e studi sui difetti. Basta questo per fare i calcoli e le stime di questo articolo.
Questo articolo è quella risposta. In breve: sì, più esecuzioni, più modelli e un controllo indipendente aiutano tutti, e la matematica spiega perché. Ma aiutano molto meno di quanto dica la formula ingenua, e il motivo è lo stesso che si era trovato con i programmatori umani quarant’anni fa.
1. La formula è giusta, è la domanda a essere sbagliata#
1 - 0.05³ è la probabilità che almeno uno dei tre agenti abbia ragione. Per trasformarla in un risultato servono due cose:
- Gli agenti sbagliano in modo indipendente. La probabilità che l’agente B sbagli non dipende dal fatto che l’agente A abbia sbagliato.
- Sai riconoscere qual è la risposta giusta. Qualcuno, una suite di test completa o un oracolo, sceglie l’output corretto ogni volta che ce n’è uno.
La seconda ipotesi è quella che tutti dimenticano. In pratica un oracolo lo hai di rado; se lo avessi, non ti servirebbero tre agenti. Quindi voti: tieni la risposta su cui sono d’accordo almeno due dei tre. Con agenti indipendenti al 95%, il voto a maggioranza dà:
P(majority right) = 3p²(1 - p) + p³ = 99.275%Sempre notevole, ma l’errore residuo è passato dallo 0,0125% allo 0,725%, 58 volte di più, solo perché nessuno sa qual è la risposta corretta. Questo scarto tra “almeno uno ha ragione” (quello che i paper chiamano pass@k) e “il voto ha ragione” è la prima cosa da tenere a mente. Il paper Large Language Monkeys l’ha misurato sul codice: la copertura continua a crescere con più campioni, ma senza un verificatore il voto e i reward model arrivano a un plateau.
2. La difficoltà è correlazione#
La prima ipotesi è messa peggio, e non serve nessun misterioso argomento del tipo “i modelli pensano tutti allo stesso modo”. I compiti semplicemente non sono tutti difficili allo stesso modo.
Prendiamo due mondi in cui gli agenti hanno esattamente la stessa accuratezza media del 95%:
- Mondo A: ogni compito fallisce il 5% delle volte.
- Mondo B: il 90% dei compiti è facile e fallisce l'1% delle volte; il 10% è difficile e fallisce il 41% delle volte. In media fa sempre il 5%.
Un solo agente non distingue i due mondi. Tre agenti sì:
| 3 agenti, accuratezza media del 95% | Mondo A (indipendenti) | Mondo B (compiti facili + difficili) |
|---|---|---|
| Almeno uno giusto (oracolo) | 99,9875% | 99,31% |
| Voto a maggioranza giusto | 99,275% | 96,31% |
Nel mondo B, i tre agenti sbagliano tutti insieme 55 volte più spesso di quanto preveda l’indipendenza. Nessuno ha copiato nessuno. Sono semplicemente tutti scarsi sugli stessi compiti difficili. E aggiungere agenti aiuta appena: con il voto a maggioranza, il mondo B passa dal 96,3% con 3 agenti al 96,7% con 5 e al 97,1% con 9. Se i compiti difficili falliscono più della metà delle volte, il voto addirittura li peggiora, ed è quello che hanno trovato Chen et al.: più chiamate all’LLM aiutano sulle domande facili e peggiorano quelle difficili.
Non è un’idea nuova. È il modello di Eckhardt-Lee, scritto per la NASA nel 1985 per il software di volo ridondante, e raffinato da Littlewood e Miller. Se θ(x) è la probabilità che una versione scelta a caso fallisca sull’input x, allora:
P(all n versions fail) = E[θ(x)ⁿ] ≥ (E[θ(x)])ⁿTutta la storia sta in quella disuguaglianza: appena la difficoltà varia da un input all’altro, il fallimento congiunto è più probabile di quanto preveda l’indipendenza. L’unica via d’uscita è rendere le versioni diverse apposta, in modo che i loro θ(x) non abbiano il picco sugli stessi input.
Puoi riprodurre entrambe le tabelle in poche righe:
from math import comb

def vote_fails(theta, n):
    return sum(comb(n, k) * theta**k * (1 - theta)**(n - k)
               for k in range(n // 2 + 1, n + 1))

worlds = {"A": [(1.0, 0.05)], "B": [(0.9, 0.01), (0.1, 0.41)]}
for name, tasks in worlds.items():
    for n in (1, 3, 5, 9):
        oracle = 1 - sum(w * t**n for w, t in tasks)
        vote = 1 - sum(w * vote_fails(t, n) for w, t in tasks)
        print(f"world {name}, n={n}: oracle {oracle:.4%}, vote {vote:.4%}")
3. Cosa è stato misurato: umani nel 1986, agenti nel 2026#
Nel 1986, John Knight e Nancy Leveson hanno fatto l’esperimento: 27 studenti di due università hanno scritto versioni indipendenti dello stesso programma a partire dalla stessa specifica, e ogni versione è stata eseguita su un milione di input casuali. Sotto l’ipotesi di indipendenza si aspettavano circa 127 fallimenti coincidenti. Ne hanno osservati 1.255, circa dieci volte di più. L’indipendenza è stata rifiutata con una confidenza del 99%, e i fallimenti si concentravano sulle parti difficili della specifica.
Questo giugno, Ron, Baudry e Monperrus l’hanno rifatto con gli agenti di programmazione: 69 versioni da 5 harness di agenti e 23 modelli, lo stesso tipo di specifica, un milione di test. I risultati:
- Prese una per una, le versioni degli agenti sono buone: 27 delle 48 che hanno passato l’accettazione hanno avuto zero fallimenti sul milione di input, e la media era di 387 fallimenti per versione (circa lo 0,04%).
- Le terne con voto a maggioranza riducono i fallimenti medi di circa due terzi (da 387 a 131).
- Ma l’indipendenza viene di nuovo rifiutata: 429 fallimenti coincidenti osservati contro 115 attesi, 3,7 volte di più. I fallimenti si concentrano sulle ambiguità della specifica, esattamente come con gli studenti.
Un secondo studio del 2026, Nogueira et al., ha fatto girare 12 modelli su 224 problemi in 5 linguaggi e ha trovato che i guadagni del voto a maggioranza restano sotto la metà di quanto preveda l’indipendenza, e che nessun ensemble ha battuto il miglior modello singolo. La scelta del modello contava più di tutto; lo stile del prompt quasi per niente.
Quindi il riassunto onesto è: l’ensemble aiuta, di circa un fattore tre sui fallimenti, non di un fattore quattrocento.
4. Modelli diversi? Meglio, ma meno di quanto speri#
Se il problema è che le versioni condividono gli stessi punti ciechi, la mossa ovvia è scegliere versioni che non li condividono: famiglie di modelli diverse. Aiuta, ma c’è un però.
Kim et al. (ICML 2025) hanno guardato più di 350 modelli. Quando due modelli sbagliano entrambi, scelgono la stessa risposta sbagliata circa il 60% delle volte su una delle classifiche. E più i modelli sono accurati, più i loro errori sono correlati, anche tra fornitori diversi. Goel et al. hanno trovato la stessa cosa: man mano che le capacità crescono, gli errori si somigliano di più. I grandi modelli sono addestrati sullo stesso internet, sullo stesso GitHub e sempre di più sugli stessi dati sintetici. I loro θ(x) hanno il picco sugli stessi input.
Quello che decorrela davvero gli errori non è il logo sul modello, è quello che cambi intorno:
- un input diverso: una specifica riscritta o chiarita, una scomposizione diversa del compito;
- un metodo diverso: una versione scritta partendo dai test, una generata a partire da esempi;
- un tipo di controllo diverso: test che eseguono il codice, non un altro modello che lo legge.
Quest’ultimo punto è quello che uso tutti i giorni.
5. Generare e rivedere: il controllo che cambia la formula#
La maggior parte di noi non fa girare tre agenti per poi votare. Facciamo girare un agente che scrive il codice e un altro, o lo stesso in un contesto pulito, che ne fa la review. La formula cambia:
P(bug ships) = P(generator wrong) × P(reviewer misses it)Con un generatore al 95% e un revisore che trova l'80% dei bug, l’indipendenza prevede che il 5% × 20% = 1% delle modifiche arrivi in produzione con un bug. Vale lo stesso problema di correlazione: il revisore ha più probabilità di lasciarsi sfuggire proprio i bug che erano difficili da evitare fin dall’inizio. E c’è un secondo rischio, quello dell’auto-review. Goel et al. mostrano che gli LLM usati come giudici favoriscono gli output di modelli simili a loro, e diversi studi trovano che i modelli non vedono nel proprio output errori che invece trovano quando lo stesso testo arriva da fuori. Le prove sono contrastanti: un test verificabile non ha trovato nessuna preferenza per sé misurabile. Ma nessuno ha ancora misurato, su codice con una verità di riferimento eseguibile, quanto più spesso un bug scritto dal modello A viene approvato da A rispetto a un revisore di un’altra famiglia. È la domanda aperta più utile di tutto questo ambito.
Cosa sostengono già i numeri:
- Un revisore vale più di un terzo generatore. Perché un voto fallisca servono due risposte sbagliate su tre che coincidano; una review moltiplica per il tasso di errori sfuggiti, e un revisore che legge la specifica e il diff è un metodo diverso, non una terza copia dello stesso.
- Preferisci un revisore di un’altra famiglia, in un contesto pulito, con la specifica ma senza il ragionamento del generatore.
- Preferisci un controllo che esegue. Test, un type checker, un fuzzer. I loro errori non sono per niente correlati con quelli del modello, ed è esattamente la proprietà che chiede la matematica. È anche il motivo per cui ho costruito Graft e il controllo di rilascio attorno a verifiche scriptate, e non attorno a un secondo parere.
6. “Lasciamo che l’LLM validi la PR”: come gli strumenti fanno già i calcoli#
Quando uno strumento dice “un’IA fa la review della tua pull request”, raramente è un solo modello che legge un diff una volta sola. Gli strumenti che pubblicano come funzionano usano gli stessi ingredienti delle formule qui sopra: più passate, un punto di ingresso diverso per ognuna, un voto o una soglia, e un secondo controllo su ogni problema trovato.
BMAD-Method. La skill bmad-code-review di BMAD-Method (v6.12, ottobre 2026) lancia fino a quattro revisori in parallelo. Ognuno è un sotto-agente nuovo, senza contesto, e ognuno riceve di proposito un input diverso:
| Revisore | Cosa riceve | Cosa cerca |
|---|---|---|
| Blind Hunter | il diff, nient’altro | cosa è sbagliato e cosa manca; una lista vuota non è accettata |
| Edge Case Hunter | il diff; la descrizione della PR solo dopo aver tracciato tutti i percorsi | i rami non gestiti, e le promesse della descrizione che il codice non mantiene |
| Verification Gap Reviewer | il diff e i test del repository | i cambi di comportamento che nessun test intercetterebbe |
| Intent Alignment Auditor | l’intento del ticket o del piano, e il diff | se la modifica fa quello che era stato chiesto |
È la sezione 2 applicata. Quattro revisori che leggono la stessa cosa con lo stesso contesto condividono lo stesso θ(x). Dare a uno solo il diff, a un altro i test e a un terzo l’intento sposta i loro punti ciechi in posti diversi. La descrizione della PR viene trattenuta apposta, così le affermazioni dell’autore non possono orientare l’analisi a posteriori: l’impostazione dell’autore è esattamente il tipo di input condiviso che correla gli errori. Poi la sessione che orchestra verifica ogni problema sul codice prima di unire i duplicati, e un revisore che fallisce viene segnalato come review incompleta, non come risultato pulito. La versione v6.2, quella che ho usato all’inizio di quest’anno, aveva già tre livelli con accessi diversi: solo il diff, il diff più il progetto, il diff più la specifica. Quello che BMAD non cambia di default è il modello: tutti i revisori girano con il modello della sessione, e un altro modello è solo un ripiego o una personalizzazione. La sezione 4 dice che è la decorrelazione più economica rimasta sul tavolo.
Claude Code. Il plugin code-review lancia quattro agenti in parallelo: due agenti Sonnet controllano le regole del CLAUDE.md, un agente Opus legge solo il diff, senza contesto aggiuntivo, e un agente Opus cerca bug e problemi di sicurezza nel codice nuovo. Poi ogni bug riceve il proprio sotto-agente validatore, che deve confermarlo con alta confidenza; tutto il resto viene scartato. La versione di novembre 2025 dava a ogni problema un punteggio da 0 a 100 e teneva quelli da 80 in su, una soglia di confidenza. Il servizio gestito Code Review di Anthropic descrive la stessa forma (trovare in parallelo, verificare, ordinare) e riporta che meno dell'1% dei problemi segnalati viene marcato come sbagliato. Angoli diversi, input diversi, taglie di modello diverse, e una verifica che punta ai falsi allarmi.
Cursor Bugbot. Bugbot è partito con la versione più letterale della sezione 1: otto passate in parallelo sullo stesso diff, ognuna con il diff in un ordine casuale diverso, per spingere il modello verso ragionamenti diversi. I bug trovati da una sola passata venivano scartati con un voto a maggioranza, e un modello validatore filtrava il resto. Mescolare l’input è il modo più economico per cambiare il punto di ingresso. Da allora Bugbot è passato a un’architettura agentica, e il suo tasso di risoluzione è salito dal 52% a oltre il 70%; l’articolo non dice se il voto è sopravvissuto.
OpenAI Codex. Il controesempio è il revisore di OpenAI: un solo revisore addestrato, non un comitato, ma con accesso a tutto il repository e all’esecuzione. Lasciargli eseguire il codice ha migliorato sia il recall sia la precisione rispetto a un revisore che vede solo il diff. È l’ultimo punto della sezione 5: un controllo che esegue fa errori che non sono correlati con quelli del modello.
Cosa hanno in comune, e cosa manca ancora:
- Tutti diversificano il punto di ingresso o l’angolo. È la leva principale, e costa solo token.
- Solo Bugbot vota. Gli altri tengono l’unione di tutti i problemi trovati e verificano ognuno. Per una review è la scelta giusta: un voto tiene ciò su cui la maggior parte delle passate è d’accordo, quindi un bug che un solo angolo può vedere, come un test mancante, verrebbe eliminato dal voto. Nella review, il recall viene dalla diversità e la precisione dalla verifica.
- La verifica legge più di quanto esegua. I revisori BMAD lavorano per ispezione, il plugin di Claude Code e il servizio gestito non compilano né eseguono il codice. Un verificatore che legge il codice con lo stesso modello ne condivide i punti ciechi; uno che lancia un test no. Ultrareview è l’eccezione lato Anthropic: dichiara che ogni problema viene riprodotto e verificato in modo indipendente.
- La diversità di modelli è la leva meno usata. BMAD usa un solo modello di default, e Claude Code mescola taglie della stessa famiglia.
Quindi “lasciamo che l’LLM validi la PR” va bene, a patto che significhi questo: più revisori con input diversi, ognuno in un contesto nuovo, una verifica su ogni problema trovato, e idealmente un’altra famiglia di modelli e qualcosa che esegue.
7. E gli umani? Quarant’anni di dati sui difetti#
La seconda domanda che avevo: come si confronta tutto questo con noi? Qual è la probabilità che una modifica scritta da un umano sia sbagliata, e come si confronta con un modello di un anno fa e con uno di oggi?
La prima risposta onesta è che le metriche non coincidono. I dati sugli umani si contano in difetti per riga o per function point su un intero progetto. I dati sui modelli si contano in compiti superati su un benchmark. Con questa avvertenza, ecco quello che abbiamo.
Umani, dal 1975 a oggi#
| Fonte | Periodo | Cosa misura | Numero |
|---|---|---|---|
| Watts Humphrey, SEI | Anni ‘90 | Difetti introdotti da ingegneri esperti, prima di qualsiasi review o test | 80-125 per KLOC |
| Ray Panko, dati di ispezione | 1986-2006 | Difetti per riga trovati durante l’ispezione del codice | 1,9%-3,7% delle righe |
| Panko, difetti residui (Putnam & Myers, 1.486 progetti) | 1975-1996 | Difetti rimasti dopo la consegna | ~0,1%-0,3% delle righe (1-3 per KLOC) |
| Capers Jones | ~2010 | Media USA dei difetti creati per function point, quota rimossa prima del rilascio | 5,1 per FP, 86,7% rimossi, 0,68 consegnati |
| Capers Jones, stessi dati | ~2010 | Team che usano TSP/PSP | 4,0 per FP, 97% rimossi, 0,12 consegnati |
| Coverity Scan | 2013-2014 | Difetti trovati dall’analisi statica su ~10 miliardi di righe | 0,61-0,77 per KLOC |
| Software di bordo dello Shuttle NASA | Anni ‘90 | Errori in ciascuna delle ultime tre release da 420.000 righe | 1 per release |
Saltano all’occhio tre cose.
- Gli umani fanno tanti errori e ne trovano la maggior parte. Entrano circa 100 difetti ogni mille righe; ne escono da uno a tre. Quasi tutta la qualità viene dalle fasi di review, ispezione e test, non dalla prima stesura.
- Il tasso di errori quasi non si è mosso in quarant’anni. Il potenziale di difetti di Jones sembra piatto in tutti i suoi scritti, e la sua efficienza di rimozione si è mossa appena, da circa l'85% (2007-2012) a poco più del 90% (2015). Prima di allora non ho trovato nessuna serie affidabile decennio per decennio. Quello che cambia il risultato di un fattore da cinque a dieci è il processo: confronta gli 0,68 difetti consegnati per function point della media USA con gli 0,12 dei team TSP/PSP, oppure il gruppo dello Shuttle, che è arrivato a un errore ogni 420.000 righe con 260 persone e 35 milioni di dollari all’anno.
- I controlli umani sono l’ensemble originale. Ispezione più test più una persona diversa che rilegge è esattamente il “controllo indipendente” della sezione 5, e ha lo stesso limite: Knight e Leveson hanno dimostrato che anche gli umani condividono gli stessi punti ciechi.
Per confrontare con i modelli mi serve la stessa unità. Il meglio che riesco a fare è la probabilità che una modifica tipica arrivi in produzione con almeno un difetto. Prendiamo una modifica di 50 righe e i numeri di Panko. Prima della review, con circa il 3% di difetti per riga, la probabilità di almeno un difetto è 1 - 0,97⁵⁰ ≈ 78%. Dopo la solita review e i soliti test, con circa lo 0,3% di difetti residui per riga, è 1 - 0,997⁵⁰ ≈ 14%. Prendile come stime fatte sul retro di una busta, non come misure.
Modelli, ottobre 2025 e ottobre 2026#
| Benchmark | Ottobre 2025 | Ottobre 2026 |
|---|---|---|
| SWE-bench Verified (500 issue reali di GitHub, test nascosti) | Claude Sonnet 4.5: 77,2%, GPT-5: 74,9% | 95-97% in cima alla classifica, ora archiviato perché saturo |
| SWE-Bench Pro (più difficile, resistente alla contaminazione) | ~23% al lancio (GPT-5, Opus 4.1) | ~60% sul set originale; 90-98% sulla V2 ripulita |
| Orizzonte temporale METR (durata dei compiti con il 50% di successo) | ~3,5 h (GPT-5), ~5 h (Opus 4.5, misurato a gennaio 2026) | ≥16 h (Claude Mythos Preview, maggio 2026) |
| Tasso di successo sulla sicurezza di Veracode (compiti sensibili per la sicurezza) | 55% (45% dei compiti vulnerabili) | 56% in media, il miglior modello al 68% |
I tassi di successo dei benchmark sovrastimano la correttezza, perché i test nascosti sono deboli. SWE-ABS ha ricontrollato le patch “risolte” dai 30 migliori agenti e ne ha trovate circa una su cinque semanticamente sbagliata. Se applico quello sconto, la probabilità che un compito venga fatto giusto è:
- Ottobre 2025: circa 0,77 × 0,80 ≈ 60-65% su SWE-bench Verified, e meno del 25% su SWE-Bench Pro. Quindi il 35-40% dei compiti falliva, più del doppio del 14% di una modifica umana rivista, e vicino a una non rivista.
- Ottobre 2026: 95% o più su un benchmark saturo. Anche con lo stesso sconto del 20%, che è pessimistico per modelli più forti, i fallimenti scendono più o meno al 5-25%. È la fascia di una modifica umana rivista.
L’unico confronto alla pari è l’esperimento N-version: stesso tipo di specifica, un milione di test. Le versioni degli agenti del 2026 falliscono in media su circa lo 0,04% degli input, e più della metà non fallisce mai. Shape of Code fa notare che sembra molto più basso delle versioni degli studenti del 1986. Tieni presente che quelli erano studenti, non team professionali.
E c’è un numero che non si è mosso: la sicurezza. Il tasso di successo di Veracode sui compiti sensibili per la sicurezza è rimasto tra il 45% e il 55% dal 2023, mentre i benchmark funzionali sono passati dal 75% al 95%. Java è al 29%, XSS e log injection al 13-15%. Il modello scrive codice che funziona molto più spesso di un anno fa. Non scrive codice sicuro molto più spesso.
Ci sono anche dati da repository reali, e sono meno drammatici di quanto dicano entrambi gli schieramenti. Mao et al. hanno abbinato 36.855 unità di codice probabilmente scritte da IA con 65.391 scritte da umani negli stessi repository: 10,0 avvisi di analisi statica per KLOC per l’IA contro 13,6 per gli umani, lo stesso tasso di avvisi ad alto rischio, e un po’ più di correzioni successive per il codice IA. Effetti “piuttosto piccoli”, per usare le loro parole. Dall’altra parte, CodeRabbit ha contato 1,7 volte più osservazioni di review sulle pull request assistite dall’IA alla fine del 2025, su un campione piccolo e da parte di un’azienda che vende review fatte dall’IA. Non ho trovato nessuno studio del 2026 che misuri gli incidenti in produzione del codice scritto dall’IA rispetto a quello scritto da umani. È il numero che tutti vorrebbero, e nessuno ce l’ha ancora.
8. Cosa ne ricavo#
La matematica e i dati dicono la stessa cosa, per gli umani e per i modelli:
- Una singola esecuzione è una bozza. Gli umani introducono circa 100 difetti ogni mille righe; i modelli falliscono una quota di compiti passata in un anno da circa il 40% a qualcosa tra il 5% e il 25%. Nessuno dei due è pronto per essere consegnato così com’è.
- La ripetizione aiuta meno della diversità. Chiedere tre volte allo stesso modello vuol dire soprattutto campionare gli stessi punti ciechi. Tre famiglie di modelli fanno meglio, ma i modelli migliori sono sempre più d’accordo tra loro, anche sugli errori.
- Il controllo che rende di più è quello i cui errori non sono correlati con quelli dell’autore. Per gli umani erano ispezione più test più processo, e hanno ridotto i difetti consegnati di un fattore da cinque a dieci. Per gli agenti è un revisore di un’altra famiglia con la specifica in mano, e soprattutto controlli che eseguono: test, tipi, fuzzing, un controllo di rilascio.
- Sistema la specifica prima di aggiungere agenti. Nel 1986 come nel 2026, i fallimenti comuni si concentrano sulle specifiche ambigue. Nessun ensemble aggiusta una domanda posta male.
- La sicurezza è l’eccezione. I modelli sono diventati molto più bravi a scrivere codice che funziona, non codice sicuro. È un punto in cui un controllo dedicato, uno scanner o una review di sicurezza, non è facoltativo.
La maggior parte di quello che serve per ragionare sugli ensemble è già misurata, e i calcoli qui sopra bastano per usarla. Quello che resta aperto è circoscritto: se un modello approva i propri bug più spesso di un revisore di un’altra famiglia. Basterebbe una manciata di compiti con buoni test nascosti per rispondere.
Fonti#
- Knight & Leveson, An Experimental Evaluation of the Assumption of Independence in Multi-Version Programming (1986)
- Eckhardt & Lee, A theoretical basis for the analysis of redundant software subject to coincident errors (NASA, 1985)
- Littlewood & Miller, Conceptual modeling of coincident failures in multiversion software
- Ron, Baudry, Monperrus, N-Version Programming with Coding Agents (2026)
- Shape of Code, Reliability via N-version programming (2026)
- Nogueira et al., Evaluating Failure Independence in LLM-Generated Code (2026)
- Kim et al., Correlated Errors in Large Language Models (ICML 2025)
- Goel et al., Great Models Think Alike and this Undermines AI Oversight (ICML 2025)
- Chen et al., Are More LLM Calls All You Need? (2024)
- Brown et al., Large Language Monkeys (2024)
- Watts Humphrey, The Software Quality Profile (SEI)
- Ray Panko, Human Error in Software
- Capers Jones, Software Quality in 2010
- Coverity Scan Open Source Report 2014
- They Write the Right Stuff (Fast Company, 1996)
- Anthropic, Introducing Claude Sonnet 4.5 (2025)
- Classifica SWE-bench Verified (llm-stats) e Vals.ai
- Scale, SWE-Bench Pro e SWE-Bench Pro V2
- SWE-ABS: patch “risolte” ma semanticamente sbagliate (2026)
- METR, Time Horizon 1.1 (2026) e orizzonti temporali METR
- Veracode, 2025 GenAI Code Security Report e rapporto 2026
- Mao et al., codice generato dall’IA e codice umano in repository reali (2026)
- CodeRabbit, State of AI vs Human Code Generation (2025)
- Cross-Context Review (2026), Do LLM Evaluators Prefer Themselves for a Reason?, Self-Preference Is Weak or Absent in Verifiable Revision (2026)
- BMAD-Method, skill
bmad-code-review, v6.12 (2026) e i livelli di review della v6.2 - Anthropic, plugin
code-reviewdi Claude Code e la sua versione di novembre 2025 - Anthropic, Code Review for Claude Code (2026) e Ultrareview
- Cursor, Building a better Bugbot (2026)
- OpenAI, Scaling code verification (2025)