Da qualche settimana sto verificando fino a che punto può cambiare il ciclo di sviluppo del software quando umani e agenti lavorano sulla stessa board. Non “un’IA che scrive il codice al posto mio”, ma uno spazio di lavoro condiviso: il backlog, le colonne, le pull request e le decisioni vivono tutti in un GitHub Project, e sia gli umani sia gli agenti lo leggono e lo aggiornano.
Ho condotto l’esperimento su due progetti reali. Il primo è stato Horae, un agente personale self-hosted. Prima di scrivere una sola riga di codice ho chiesto a Claude di stimarlo in due modi: in giorni umani, se lo costruisse un team di sviluppatori, e in giorni IA, se lo costruisse un team di agenti con me a supervisionare. La risposta era chiara, e un po’ deludente: un umano con quattro agenti sarebbe stato più lento di tre sviluppatori. 76 settimane contro 22, perché la mia supervisione sarebbe stata il collo di bottiglia. Angelia, un bus di eventi di release scritto in Go, è arrivato qualche giorno dopo, con una board organizzata sulla base di quello che mi aveva insegnato Horae.
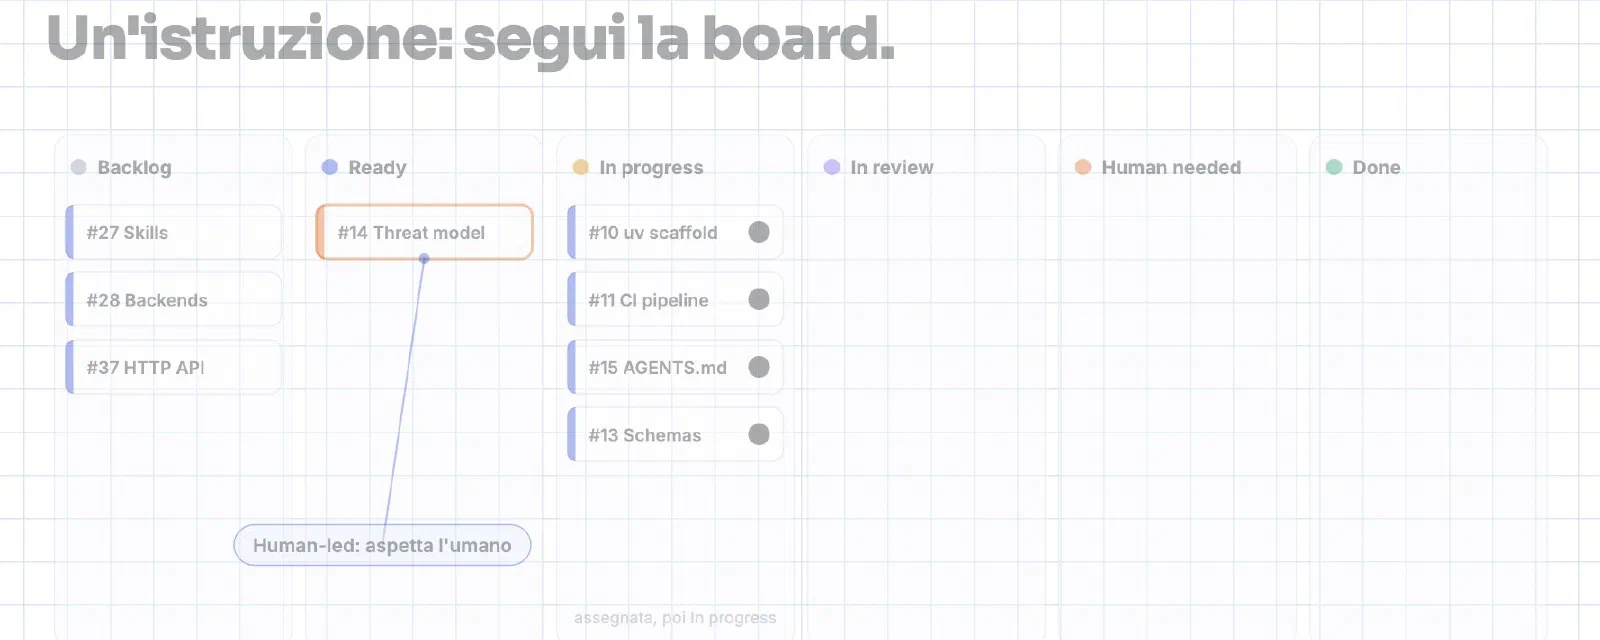
Non ero convinto dalla stima. Così ho organizzato entrambi i progetti in modo che fosse la board stessa a darmi la risposta: ogni story porta la sua stima, e ogni story riceve i suoi numeri reali quando è finita. Poi ho dato agli agenti una sola istruzione: segui la board.
Due settimane e mezza dopo, tutto il lavoro su Horae che un agente poteva fare è unito, Horae gira sul mio server di casa e ha già mandato un promemoria al mio telefono, e Angelia ha pubblicato la sua prima release. Questo post racconta come funziona giorno per giorno, cosa dicono i numeri rispetto alla stima, cosa hanno cambiato la quota di utilizzo e il conto dei token, e perché l’ultimo miglio è stato ancora soprattutto umano.
0. Prima il risultato#
Ecco tutto il ciclo in un centinaio di secondi. Come i miei video precedenti, non è un file video: ogni fotogramma è disegnato in JavaScript, sopra una voce sintetica.
Premi Play (con l’audio). Cambia lingua nella barra dei controlli o attiva i sottotitoli. Aprilo a pagina intera per avere l’elenco dei capitoli.
1. Due progetti#
Horae è un agente personale prevedibile e self-hosted: pipeline fisse invece di un loop di agenti, al massimo un passo LLM limitato, plugin con permessi dichiarati installati da git. Il brief del mattino, i promemoria, le integrazioni con le mie note, i miei calendari e la mia posta. Un prodotto vero con vincoli veri: input non affidabili, segreti, plugin che non ho scritto io. Python, 15 repository.
Angelia è un bus di eventi di release self-hosted: osserva PyPI, npm, crates.io, le release di GitHub e i registry OCI, e consegna un CloudEvent firmato per ogni nuova versione a CI, chat e agenti IA. Go, 5 repository.
Li ho costruiti entrambi soprattutto con agenti fin dal primo giorno, con me come maintainer part-time: sere, qualche mattina e i weekend.
2. Prima i ticket, e li valida l’umano#
Niente di quello che segue funziona senza questo passo, ed è quello che mi ha preso più tempo.
In qualche sessione, Claude e io abbiamo scritto il piano (PLAN.md), le decisioni di architettura da prendere e il backlog. Poi ho chiesto a Claude di mettere tutto su GitHub: un’organizzazione, 15 repository e un progetto pubblico, la Horae Roadmap. Ha creato 130 issue: 23 epic, 90 story, 7 task solo umani e 10 rischi (i “burning points”), usando i tipi di issue (Epic, Story, Risk), le sub-issue e i link “bloccato da”.
Ho letto e validato i ticket prima che esistesse una sola riga di codice. È la parte che non delegherei mai: decidere cosa vuol dire “fatto”.
Ogni story ha la stessa forma: un riassunto, i criteri di accettazione, una tabella di stima, le istruzioni per gli agenti e una sezione Actuals vuota da compilare alla fine.
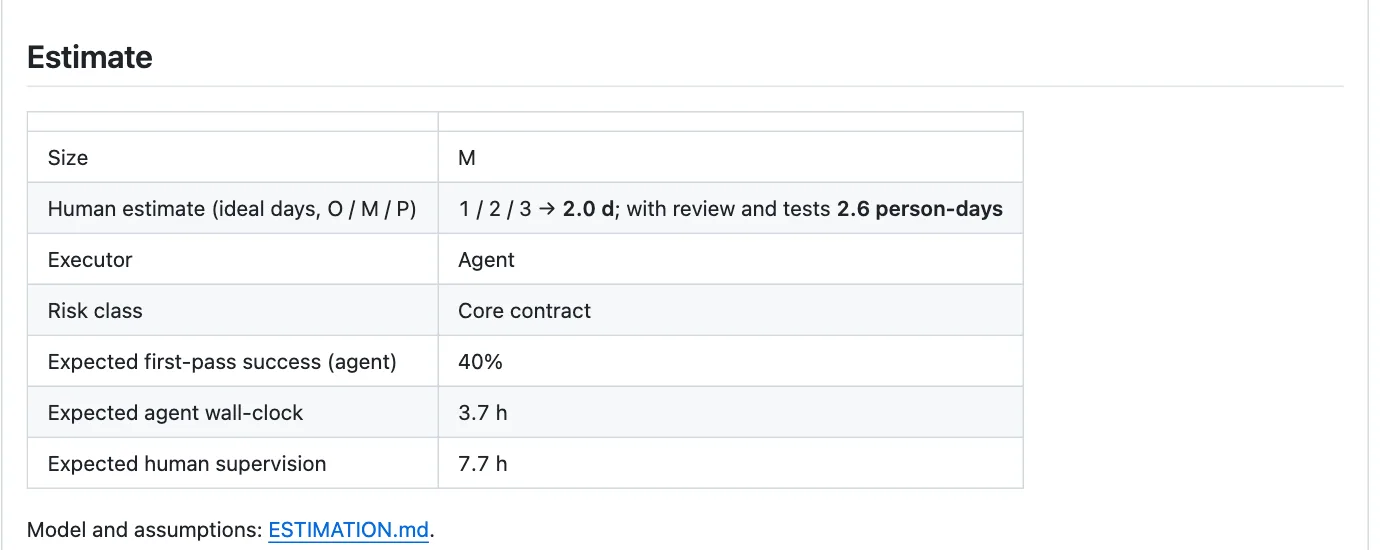
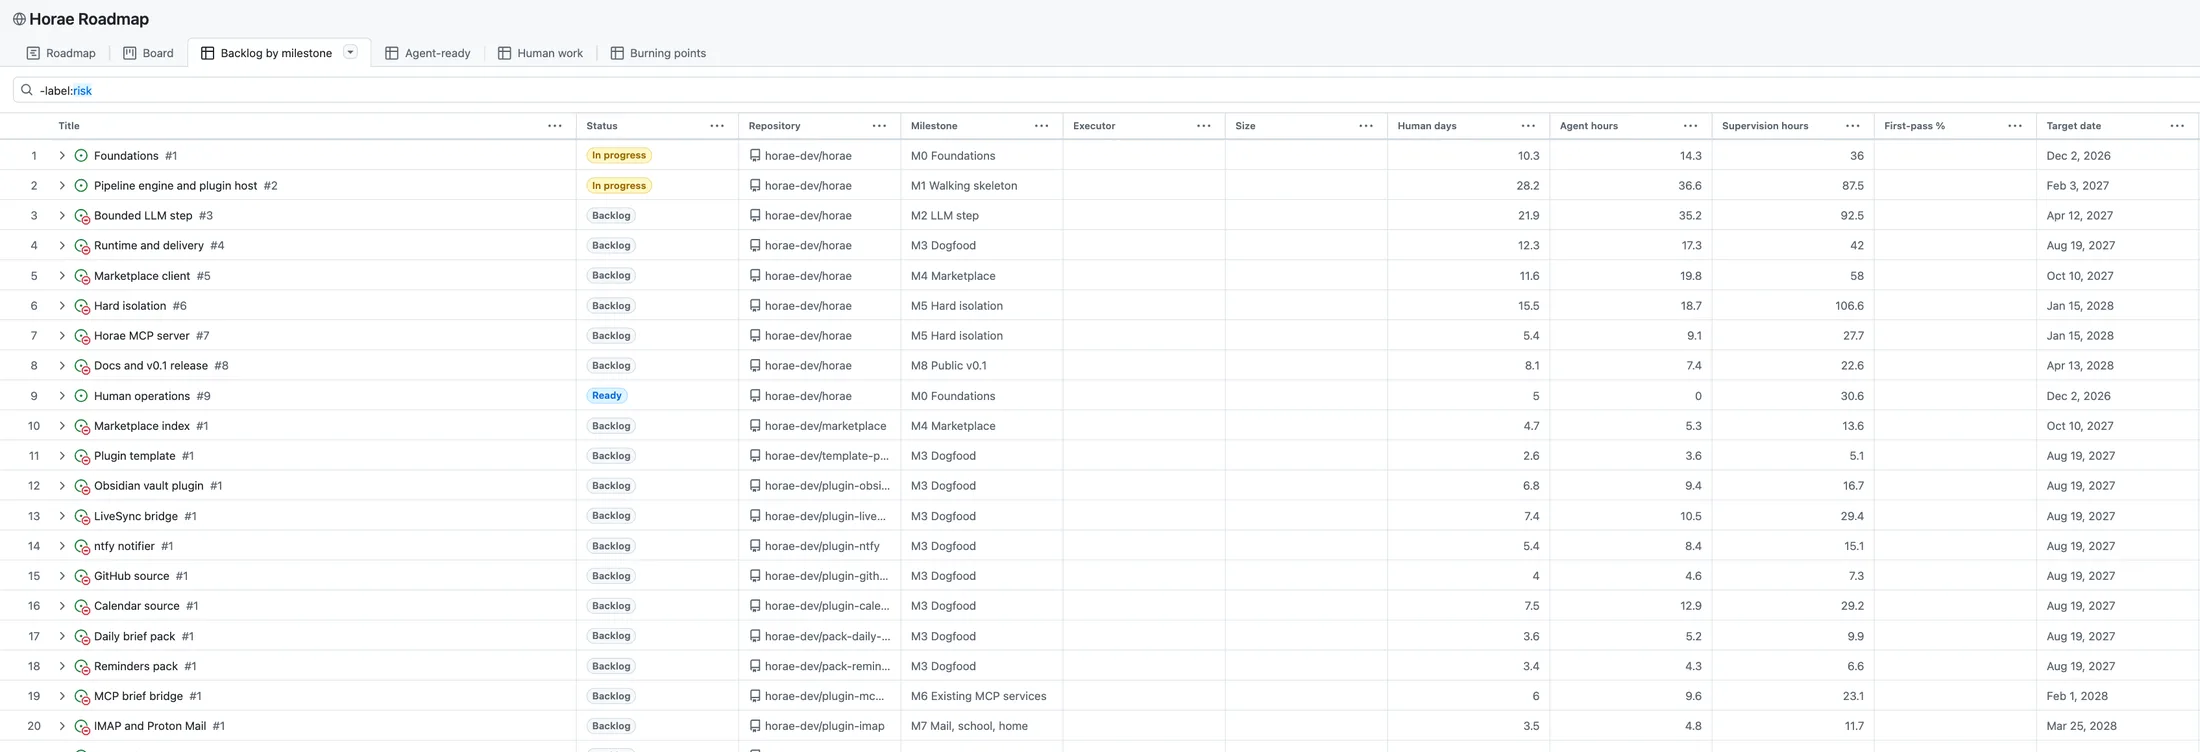
Il progetto ha dei campi personalizzati che rendono la board leggibile sia dagli umani sia dagli agenti:
| Campo | Valori | Perché |
|---|---|---|
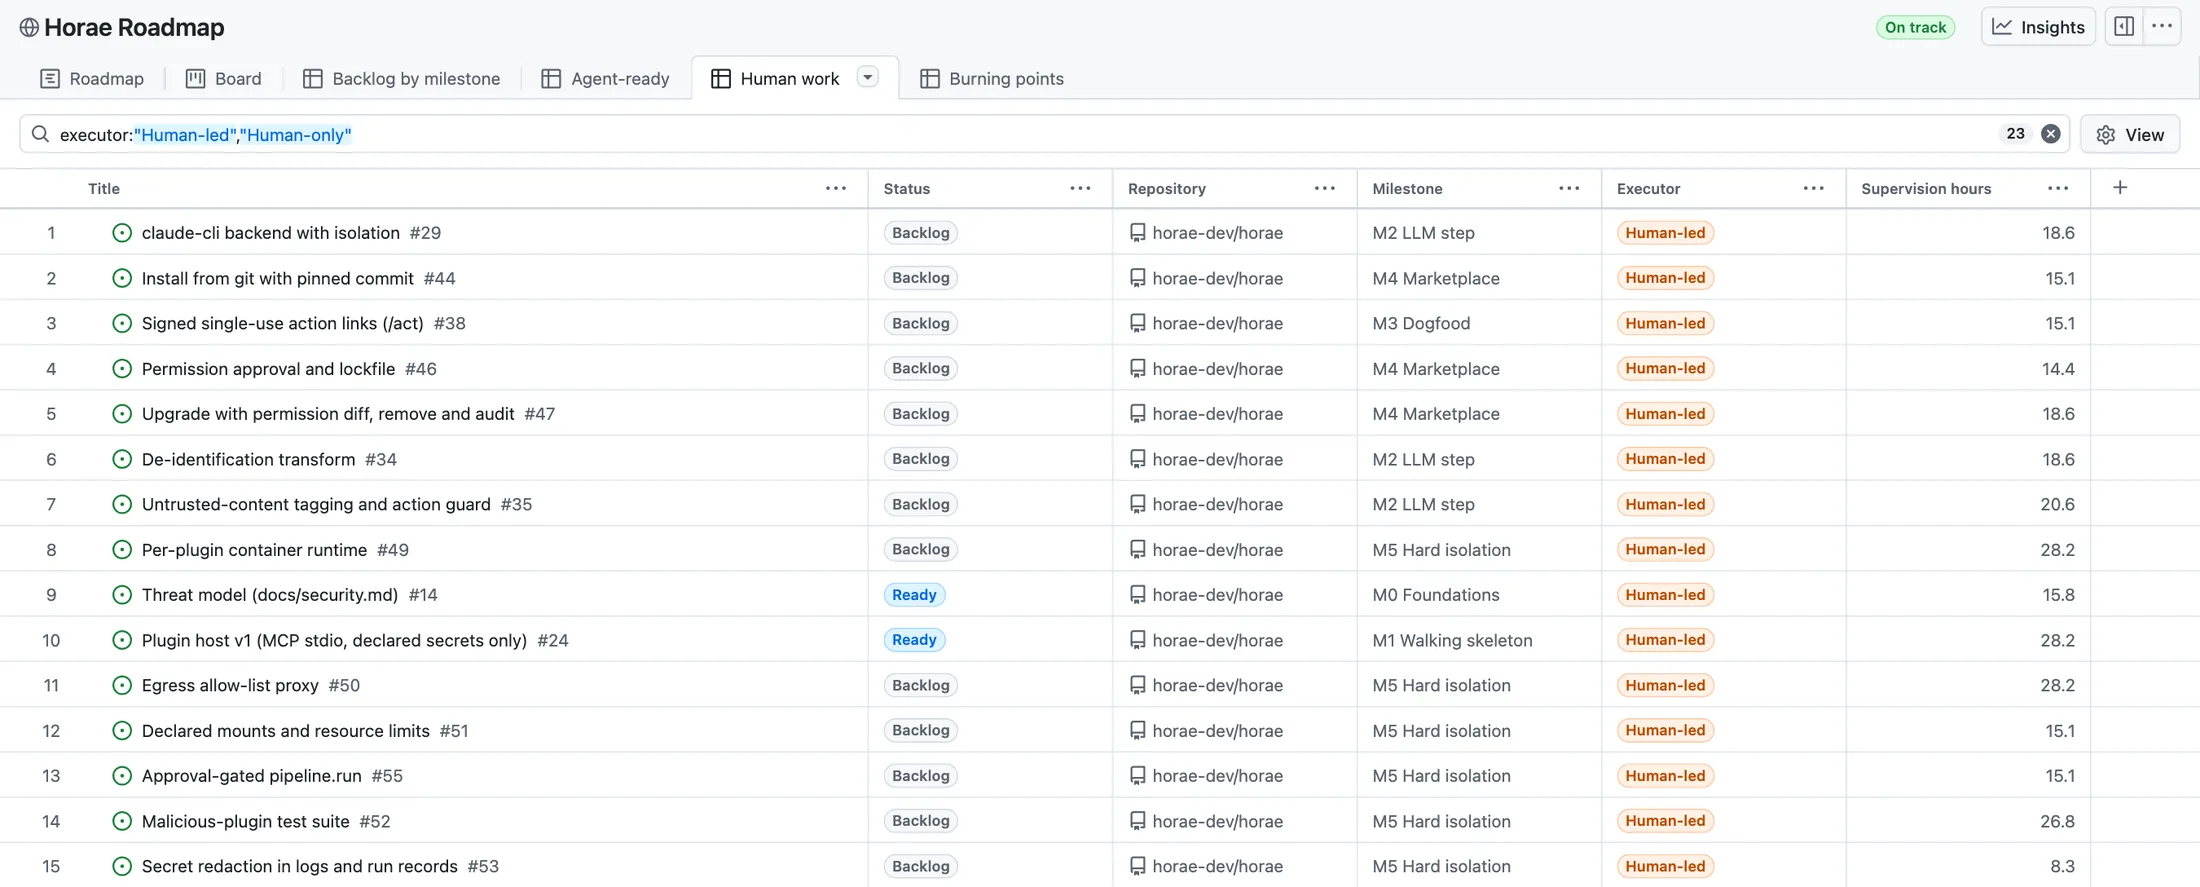
| Executor | Agent · Agent + human check · Human-led · Human-only | chi fa il lavoro, così gli agenti sanno cosa saltare |
| Size | XS · S · M · L | per la stima |
| Risk class | Normal · Docs/CI · Core contract · Security · Integration · External API · Design/prompt | sicurezza e API esterne richiedono molta più supervisione |
| Human days, Agent hours, Supervision hours, First-pass % | numeri | le due stime, per story e per epic |
Ogni repository ha anche un AGENTS.md (setup, comandi, convenzioni, definizione di “fatto”) e una policy graft.yaml che dice quali percorsi richiedono la mia review, così le regole vivono nel repository, non in un prompt.
3. La board è l’interfaccia#
La vista board ha sei colonne. Le loro descrizioni contano, perché sono il contratto tra me e gli agenti:
| Colonna | Significato |
|---|---|
| Backlog | non ancora pronta |
| Ready | specifica completa, si può iniziare |
| In progress | un agente o un umano ci sta lavorando |
| In review | PR aperta, review di Graft e/o del maintainer |
| Human needed | bloccata sul maintainer |
| Done | unita e accettata |
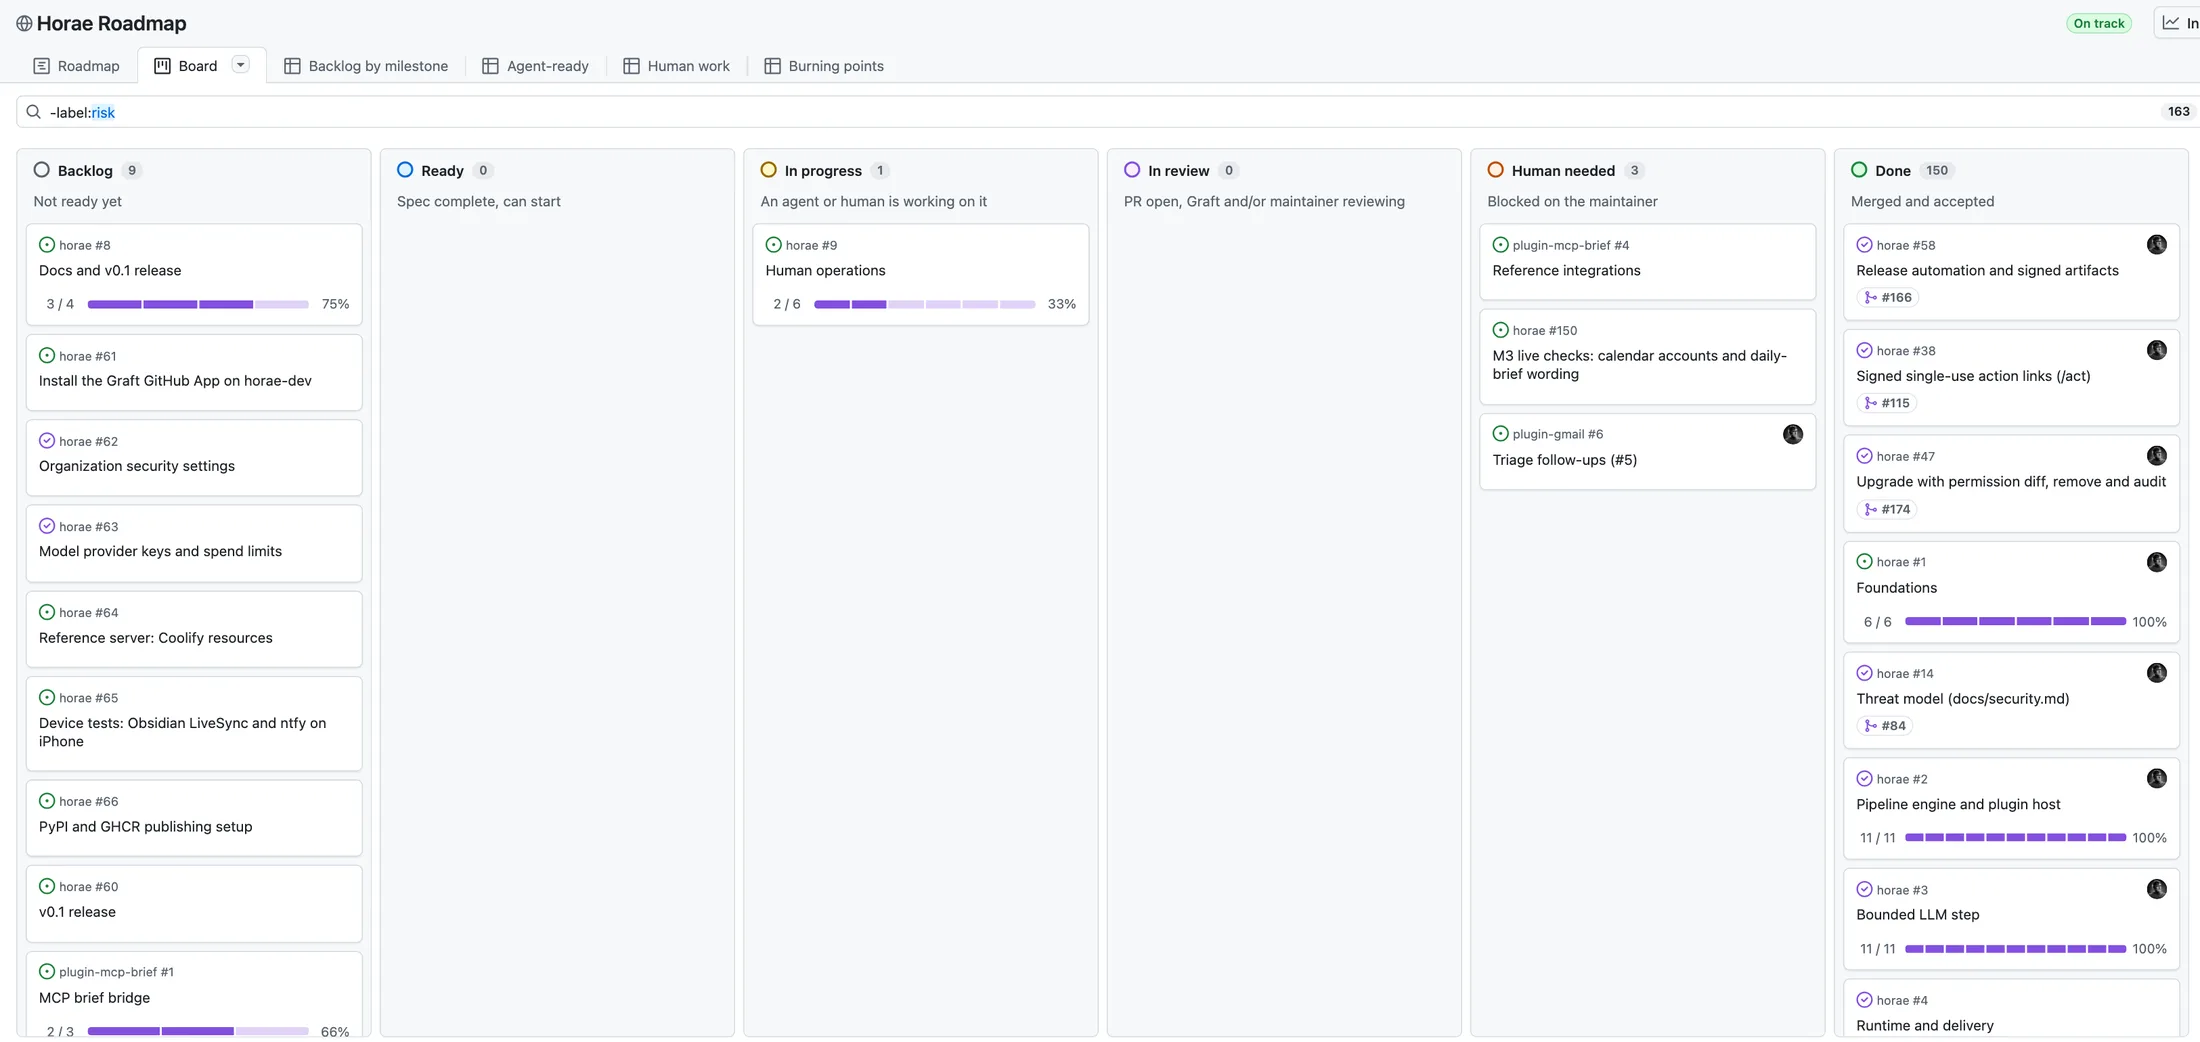
Intorno ci sono altre cinque viste: Roadmap, Backlog by milestone (con le stime), Agent-ready (filtro label:agent-ready status:Ready: quello che un agente può prendere adesso), Human work (gli elementi Human-led e Human-only, il vero collo di bottiglia) e Burning points (i rischi).
Guardate la colonna Backlog nella board qui sopra: quello che resta su Horae è esattamente il lavoro che solo io posso fare.
4. Una sola istruzione: segui la board#
Poi ho scritto questo (in inglese, errori compresi):
Following the project on github https://github.com/orgs/horae-dev/projects/1/views/3 Start in the right order the epics/issues ready for agents dev. Use the proper workflow with subagents when needed assigning the proper model based on the complexity, make a full review with another agent and fix then all the findings with a third agent. Create the PR referencing the issue, wait for the CI to be green, merge and move on.
E un secondo messaggio un minuto dopo: “be sure to assign each task before to start to be able to track the time”.
Da lì, la sessione principale di Claude Code ha guidato la board. Per ogni story in Ready, nell’ordine delle dipendenze:
- Assegnare la issue a me e spostarla in In progress (il timestamp fa partire il cronometro).
- Costruire: un sotto-agente la implementa su un branch
story/<n>-<slug>. L’agente principale sceglie il modello in base alla complessità: Sonnet per lo scaffold, la CI e il workflow degli agenti; Opus per i JSON Schema, la validazione degli intent, gli ADR e tutto ciò che tocca la sicurezza. - Review: un agente separato rivede il lavoro rispetto ai criteri di accettazione, a
PLAN.mde alle story che ne dipendono. Non modifica nulla: riproduce i problemi in un clone usa e getta e scrive i suoi rilievi. Le story di sicurezza hanno un revisore specializzato in sicurezza. - Correggere: un terzo agente corregge tutti i problemi trovati.
- Aprire la PR che riferisce la issue, aspettare che la CI sia verde, fare il merge.
- Pubblicare gli Actuals sulla issue e spostare la card in Done.
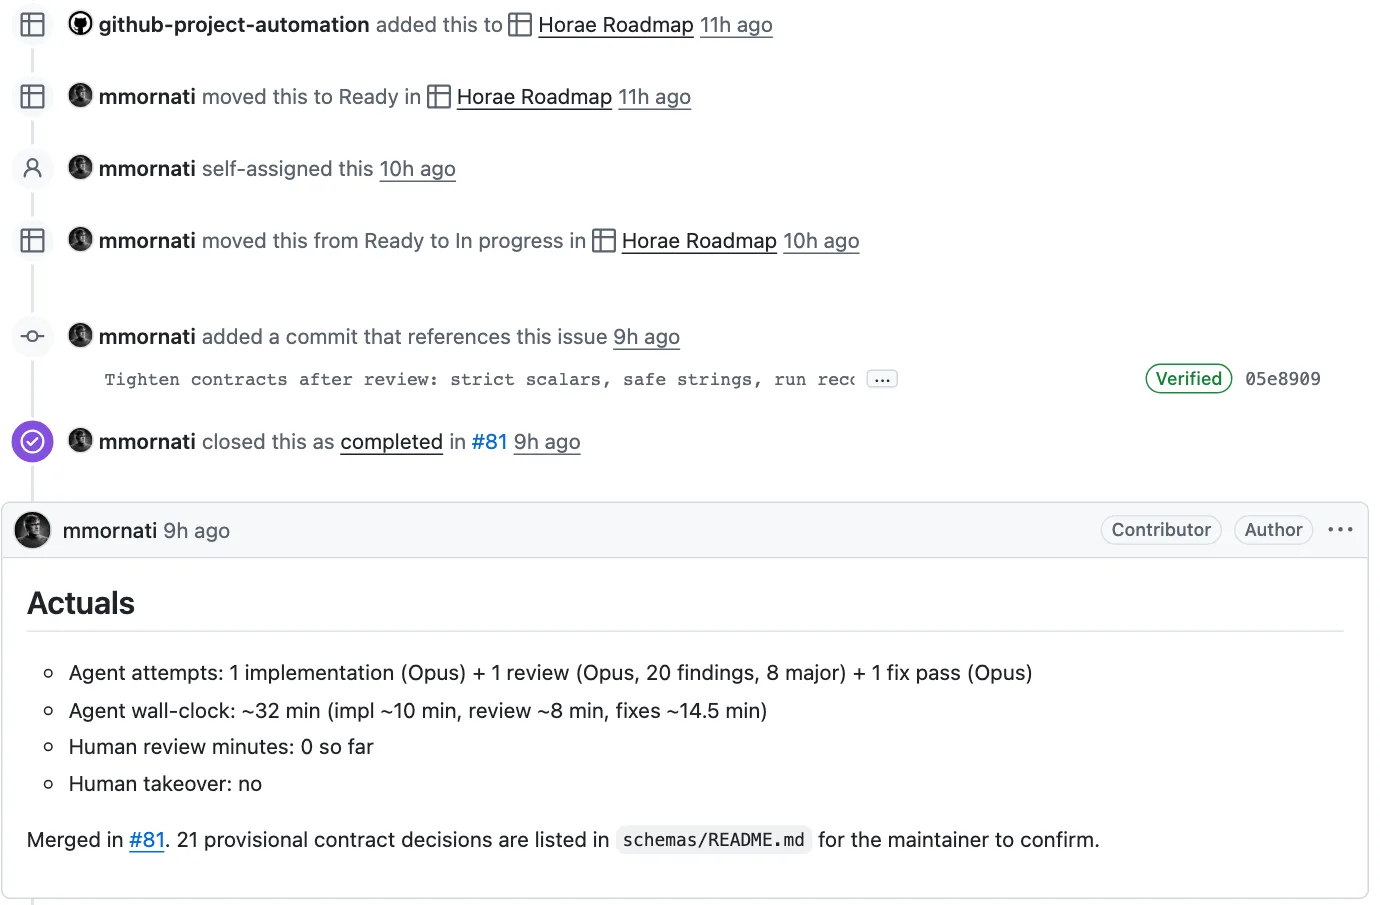
Le card con Executor Human-led vengono saltate finché non ho preso le decisioni. Quando ci sono story indipendenti in Ready, l’agente principale le avvia in parallelo, ognuna nel suo worktree git.
Dopo la prima serata, le mie istruzioni sono diventate ancora più brevi, e sempre una milestone alla volta: “Start M2”, “Can you proceed with the next user stories ready to dev?”, “continue”. Undici giorni dopo, l’ultima è stata “yes go to complete the full project with the remaining tasks”. Non ho mai chiesto tutto il backlog in un colpo solo. Si è rivelato importante (sezione 8).
La board è anche cresciuta da sola. Gli agenti hanno aperto 43 nuove issue su Horae e 34 su Angelia: seguiti delle review, story divise in due, lacune del core scoperte mentre costruivano i plugin. Sono passate per lo stesso ciclo.
Cosa hanno trovato i revisori#
È la parte che mi ha convinto che il ciclo funziona. L’implementatore diceva sempre “tutti i controlli passano”. Il revisore trovava quasi sempre qualcosa di reale, e spesso di serio. Solo nelle prime 36 story di Horae, gli Actuals elencano più di 360 problemi trovati in review, tutti corretti prima del merge. Qualche esempio:
- #15 workflow degli agenti: l’hook di commit usava il primo
python3nel PATH. Con il Python 3.9 di default di macOS andava in crash e bloccava ogni commit, compresi i miei. - #13 schema (20 problemi, di cui 8 gravi): il percorso di una nota poteva uscire dal vault di Obsidian verso
.obsidian/plugins(esecuzione di codice sul mio portatile),notify.pushaccettava linkjavascript:, e il lockfile accettava URL gitext::. - #18 store SQLite: le chiavi esterne erano attive prima delle migrazioni, quindi una futura ricostruzione di tabella avrebbe cancellato in silenzio tutte le voci del journal. Il revisore ha riprodotto la perdita di dati.
- #32 cache: dopo aver annullato un’esecuzione, la successiva esecuzione identica avrebbe riapplicato gli stessi intent dalla cache, gratis, per un massimo di 7 giorni, compresi intent nati da una prompt injection.
- #191 installazioni di terze parti: un plugin di terze parti poteva piazzare un pacchetto avvelenato nella cache di download condivisa con le installazioni first-party, che una build successiva avrebbe eseguito sulla mia macchina, senza che il plugin venisse mai eseguito. Il revisore ha riprodotto l’attacco dall’inizio alla fine.
- #52 suite dei plugin malevoli: nessuno dei 41 attacchi è passato. Poi un revisore ha disattivato 24 protezioni una alla volta per verificare che il test corrispondente fallisse. Cinque test passavano ancora con la loro protezione rimossa, quindi per quelle garanzie la suite dava una falsa sicurezza. Corretto prima del merge.
E uno che i revisori non potevano trovare: il backend claude-cli (#29) passava tutti i test con i mock, ma la prima esecuzione reale con il mio token ha fatto fallire quattro test. La vera CLI avvolge il JSON in blocchi di codice, ragiona prima di rispondere e ritenta in silenzio le risposte troncate fino a tre volte, quindi una chiamata limitata a 64 token ne fatturava 256. I mock confermano le tue ipotesi; la realtà no. La sezione 10 ne ha molti altri.
5. Quando serve un umano#
Alcune story sono mie per scelta: il threat model, il plugin host, tutto ciò in cui un default sbagliato diventa una falla. Per queste l’agente non tira a indovinare. Scrive una nota di design in una PR in bozza, con domande numerate e una raccomandazione per ciascuna, e la card passa in Human needed.
Il protocollo sta in due passi:
- Rispondere sulla PR, mantenendo i numeri delle domande. Bastano risposte brevi; anche “tutto come proposto” va bene.
- Rimettere la card in Ready. È il segnale. La prossima volta che un agente la prende, legge i miei commenti, trasforma la nota nel vero deliverable e riparte con il solito ciclo costruire → review → correggere → merge.

Dieci domande, dieci risposte di una riga, una card rimessa in Ready. È tutta l’interfaccia.
Quando PLAN.md era ambiguo, gli agenti hanno scelto l’opzione più restrittiva (allentare una regola dopo non rompe niente, stringerla sì), l’hanno segnata come provvisoria e me l’hanno elencata. Alla fine c’erano più di 70 decisioni numerate in schemas/README.md di Horae.
Il protocollo è cambiato il tredicesimo giorno#
Il 9 novembre la board aveva diverse card in attesa di me, tutte con il codice già unito e solo una verifica nel mondo reale da fare. Ho scritto: “Get for all of them the recommendation you would like to do and move on. Plan the next development phases and go.” L’agente principale le ha chiuse, ha spostato ogni verifica nel mondo reale in una di tre issue di checklist per me, ha accettato il template di nota predefinito come una scelta di design che gli avevo delegato, ha pubblicato un piano da M4 a M8 e ha iniziato a costruire.
Ha comunque tracciato un confine che non gli avevo chiesto. Le story che controllano quale codice di plugin viene installato ed eseguito (#44, #46, #47) sono arrivate solo fino a una PR con review: “Fare il merge di codice di installazione critico per la sicurezza senza che tu lo guardi non spetta a me.” Nei due giorni successivi ho approvato nove di queste PR: installazione da git, approvazione dei permessi e lockfile, aggiornamento e audit, il runtime dei container, l’autenticazione MCP, il proxy di uscita, le esecuzioni di pipeline soggette ad approvazione, mount e limiti, e le installazioni di terze parti.
Ecco la parte scomoda. Alcune di queste approvazioni mi hanno preso un paio di minuti: “I’ll review it”, poi “review done, you can proceed” due minuti dopo. Un revisore di sicurezza indipendente aveva già esaminato ogni diff, e la PR elencava le decisioni da verificare, quindi ho letto le decisioni, non il codice. È quello per cui il sistema è pensato, ma significa anche che il cancello umano è solido solo quanto l’attenzione che c’è dietro.
6. La stima, e perché ne dubitavo#
Ecco cosa diceva il modello per Horae, nel caso probabile:
| Team umano | Un umano + 4 agenti | |
|---|---|---|
| Sforzo | 218 giorni-persona | 325 ore di agenti + 1.134 h della mia supervisione |
| Calendario | 22 settimane con 3 sviluppatori · 67 settimane da solo | 76 settimane a 15 h/settimana · 38 settimane a tempo pieno |
Il modello era accurato e le sue fonti erano buone: gli orizzonti temporali di METR, lo studio METR del 2025 in cui sviluppatori esperti erano il 19% più lenti con l’IA, i report di CodeRabbit e Veracode sui difetti del codice scritto dall’IA. Le sue ipotesi principali:
- Il successo al primo tentativo di un agente scende in fretta con la taglia e il rischio: 85% per una story S, 30% per una L, dimezzato ancora per la sicurezza.
- Ogni tentativo fallito costa una review umana pari a circa il 15% dello sforzo umano, il doppio per la sicurezza.
- Dopo tre fallimenti, subentra un umano al 60% dello sforzo umano.
- Durata di un agente: 0,75 h per una story S, 2 h per una M, 5 h per una L.
Quindi gran parte delle 1.134 ore ero io, a rivedere diff e a salvare agenti. La roadmap costruita su questa stima andava dal 2 novembre 2026 al 13 aprile 2028.
7. Cosa dicono le board#
Horae: finito in 15 giorni#
Delle 97 story e task del backlog originale di Horae, 89 sono finite. Le 8 che restano sono 7 task solo umani (account, impostazioni, dispositivi, la release stessa) e un’integrazione che richiede una piccola modifica in due servizi che gestisco io. Strada facendo, gli agenti hanno anche aperto e chiuso 41 issue loro.
| Milestone | Finite | Previsto (inizio → obiettivo) |
|---|---|---|
| M0 Foundations | 6 / 8 | nov. 2026 → dic. 2026 |
| M1 Walking skeleton | 11 / 11 | dic. 2026 → feb. 2027 |
| M2 LLM step | 12 / 13 | feb. 2027 → apr. 2027 |
| M3 Dogfood | 39 / 42 | apr. 2027 → ago. 2027 |
| M4 Marketplace | 9 / 9 | ago. 2027 → ott. 2027 |
| M5 Hard isolation | 7 / 7 | ott. 2027 → gen. 2028 |
| M6 Existing MCP services | 2 / 3 | gen. 2028 → feb. 2028 |
| M7 Mail, school, home | 10 / 10 | feb. 2028 → mar. 2028 |
| M8 Public v0.1 | 3 / 5 | mar. 2028 → apr. 2028 |
Tutto quello che è ancora aperto è nelle mani di un umano. La prima story è partita il 27 ottobre, e l’ultimo task degli agenti è stato unito l’11 novembre: 15 giorni di calendario, di cui gli agenti hanno effettivamente lavorato in 8. Il piano diceva 76 settimane. Anche il team di tre sviluppatori della stima avrebbe avuto bisogno di circa 18 settimane per le stesse 89 story (183 giorni-persona).
Tempo degli agenti: da un terzo a un sesto della stima#
Entrambi i progetti registrano la durata degli agenti negli Actuals. Ecco le story che hanno sia un tempo sia una stima:
| Story cronometrate | Tempo agente stimato | Tempo agente misurato | Rapporto | |
|---|---|---|---|---|
| Horae | 42 | 116 h | 39 h | ~3 volte meno |
| Angelia | 30 | 106 h | 18 h | ~6 volte meno |
Su Angelia, dove il modello è sulla card, lo schema è lo stesso a ogni livello: una story Opus ha richiesto in media 44 minuti contro 4,2 ore stimate, una story Sonnet 30 minuti contro 2,9 ore, e una story M 34 minuti contro 3,5 ore.
Horae ha una lacuna che ho creato io: quando sono passato a un ciclo più leggero per risparmiare token (sezione 8), gli Actuals hanno continuato a dire quale agente e quale modello avevano fatto il lavoro, ma hanno smesso di registrare il tempo. Quindi 88 story di Horae non hanno una durata misurata. Se copiate questo sistema, proteggete il tempo nel vostro template di Actuals; è la prima cosa che salta quando si ottimizza il costo.
Interventi umani e supervisione#
Nessun intervento umano, in tutti i 123 Actuals che lo registrano, sui due progetti. Il modello si aspettava che le story M fallissero il primo tentativo la maggior parte delle volte e ricadessero su di me. Non è successo: il revisore ha trovato i problemi e il correttore li ha corretti. Un primo tentativo fallito è diventato un’iterazione interna economica, non un salvataggio umano.
Per le 89 story di Horae finite, la stima prevedeva 684 ore della mia supervisione, soprattutto per rivedere diff. Non ho rivisto quasi nessun diff. In quei 15 giorni ho mandato una quarantina di messaggi alla sessione principale, quasi tutti di una riga (“continue”, “Start M2”, “review done, you can proceed”), ho risposto a sette note di design, ho accettato gli ADR e il formato delle skill, ho preso una manciata di decisioni (“Relax it (option 2)”, “Yes, container only”) e ho approvato nove PR di sicurezza. Non l’ho cronometrato, quindi non inventerò un numero, ma siamo lontanissimi dalle 684 ore. Il resto del mio tempo è andato a monte, nelle sessioni di pianificazione e nella validazione dei ticket, e a valle, nel deployment della sezione 10.
Perché il modello sbagliava#
Il modello non era fatto male. Era costruito su numeri del 2025, e metteva l’umano nel posto sbagliato.
- I dati sono invecchiati in fretta. L’aggiornamento di METR mette il tempo di raddoppio della lunghezza dei compiti che i modelli di frontiera sanno portare a termine a circa 89 giorni per i modelli dal 2024, e Anthropic parla di un raddoppio “circa ogni quattro mesi, contro i sette mesi di prima”. Una stima fatta a ottobre su studi di inizio 2025 è calibrata su modelli indietro di due o tre raddoppi.
- Presumeva che un umano rivedesse ogni tentativo. In questo workflow la review la fa un agente indipendente, e io rivedo le decisioni. È anche la direzione in cui vanno i grandi team: Anthropic scrive che “la code review umana è diventata un nuovo collo di bottiglia”, con oltre l'80% del suo codice unito ormai scritto da Claude. Anche il team .NET di Microsoft, dopo dieci mesi con il coding agent di Copilot, indica la review come collo di bottiglia.
- Il “successo al primo tentativo” era l’unità sbagliata. Misura se il primo diff è pronto per il merge. Con un revisore e un correttore nel ciclo, conta se il ciclo converge senza un umano. 123 su 123 l’hanno fatto.
Cosa dice ancora di giusto il modello#
Non voglio sostituire un numero sbagliato con un altro, quindi ecco i limiti onesti:
- Gran parte non è ancora provata sul campo. Il core di Horae e i plugin Obsidian, calendario e ntfy ora girano sul mio server (sezione 10). I plugin di posta, scuola, Home Assistant e Google non hanno mai toccato un account reale; il protocollo di ÉcoleDirecte è stato scritto a partire dalla documentazione della community.
- I difetti non spariscono. Gli studi trovano ancora più problemi nelle PR scritte dall’IA (1,7 volte più problemi gravi per CodeRabbit, il 44% dei compiti con una vulnerabilità a rischio per Veracode, più instabilità per DORA). Le mie centinaia di problemi trovati dicono la stessa cosa: la prima bozza è spesso sbagliata. È cambiato chi se ne accorge.
- Il tempo a monte e a valle è reale. Scrivere e validare i ticket mi ha richiesto più tempo di quanto ne abbiano impiegato gli agenti per consegnare intere milestone. Il deployment mi ha preso due serate. Il team .NET ha visto anche la parte a monte: il tasso di successo del loro agente è passato dal 38% al 69% dopo istruzioni migliori, e la loro conclusione è che “la preparazione conta più del modello”.
- Il modello non ha prezzato due nuovi limiti: la quota di utilizzo e il conto dei token. Prossima sezione.
Quindi la stima aveva ragione: il collo di bottiglia sono io. Sbagliava sul tipo di lavoro che avrei fatto. Mi contava come revisore di codice. Ho lavorato come product owner, come architetto che risponde a domande, come approvatore e, alla fine, come operatore.
8. Stop, quota e conto dei token#
Ecco una cosa che nessuna stima menziona: il lavoro si ferma. Non perché qualcosa si rompe, ma perché l’umano non c’è, o perché la quota di utilizzo finisce.
Horae ha chiuso story in 9 giorni tra il 27 ottobre e il 12 novembre. In mezzo: le notti, le mie giornate di lavoro, quattro stop per limite di utilizzo e due lunghe pause, il 30–31 ottobre e dal 2 al 7 novembre. La seconda era dovuta alla quota settimanale e all’altro progetto: dall'1 al 7 novembre facevo girare Angelia, poi di nuovo Horae dall'8 novembre. Due board condividono un umano e una quota.
Cosa ho imparato dagli stop:
- La board è il salvataggio. Quando tutto si ferma, non si perde niente: ogni card dice a che punto è, ogni PR contiene le sue domande, ogni story finita ha i suoi Actuals. Una settimana dopo, è bastato “Continue” per riprendere Horae.
- Chiedere una milestone alla volta è ciò che rende gli stop economici. Ogni stop è arrivato tra due blocchi di lavoro o dentro un blocco piccolo.
- Uno stop a metà di una story ha un costo. Quando arriva un limite di utilizzo, l’agente principale ferma di proposito i suoi agenti in esecuzione invece di bruciare l’ultimo margine disponibile, e annota a che punto era ciascuno (branch, percorso del worktree, cosa restava da fare). È quella nota che rende possibile ripartire.
- L’agente principale deve rileggere la board tra una story e l’altra. Una volta ho risposto a una nota di design e ho rimesso la card in Ready, e tre ore dopo l’agente principale la elencava ancora come “in attesa delle tue risposte”: lavorava sui propri appunti, non sulla board.
Il conto dei token#
L'8 novembre, dopo il terzo stop per limite di utilizzo, ho chiesto all’agente principale di analizzare dove andavano i token. La risposta era chiara:
- Tre agenti per story (costruire, review, correggere) rileggevano ciascuno gran parte degli stessi documenti e dello stesso codice: circa da 600.000 a 1 milione di token per story.
- Fino a 7 story in parallelo causavano conflitti di merge e tre collisioni sui numeri delle decisioni, ognuna con giri in più.
- Ogni problema minore riceveva una passata di correzione, e le piccole modifiche andavano agli agenti.
Il nuovo “ciclo leggero”:
- Un agente per story come default: implementa, rivede il proprio diff rispetto a una checklist, corregge, apre la PR e aspetta la CI. Sonnet come default, Opus per il lavoro di sicurezza o sui contratti del core.
- Un revisore indipendente solo per le story di sicurezza o sui contratti del core, limitato al diff, che segnala i problemi gravi e medi e li corregge lui stesso.
- I problemi minori diventano issue di follow-up.
- Al massimo due story in corso.
- Merge, rinumerazioni e piccole modifiche le fa l’agente principale.
Le tre story successive hanno usato circa 80.000, 108.000 e 220.000 token. Da tre a dieci volte meno, ed è il ciclo che ha finito da M3 a M7. Il lavoro di sicurezza ha mantenuto il suo revisore indipendente, ed è da lì che vengono i problemi seri della sezione 4. Il prezzo sono stati i dati sui tempi, come ho detto sopra.
9. Una seconda board: Angelia#
Il 30 ottobre ho chiesto a Claude di copiare quello che avevamo fatto su horae-dev e di costruire “a full board agent + human development oriented to work together”, in cui sono gli agenti a decidere quando serve un umano e il modello viene scelto in base alla complessità. In circa 45 minuti ha creato cinque repository e 129 issue sulla Angelia Roadmap.

È simile a Horae, ma non uguale:
| Horae | Angelia | |
|---|---|---|
| Repository | 15 | 5 |
| Issue all’inizio | 130 | 129 |
| Scelta del modello | la sceglie l’agente principale per ogni story | un campo Complexity determina un campo Model su ogni card: Low → Haiku, Medium → Sonnet, High e Very high → Opus; posso cambiarlo io |
| Quando chiedere a un umano | il campo Executor, più il giudizio dell’agente | trigger espliciti in AGENTS.md: un contratto pubblico, una scelta di sicurezza, una nuova dipendenza, una specifica ambigua, o lo stesso controllo della CI che fallisce tre volte |
| Escalation | niente di scritto | tre fallimenti della CI o il doppio del tempo stimato → un nuovo tentativo con il modello superiore → poi un umano |
| Livello di dettaglio delle specifiche | ogni story dettagliata fin dall’inizio | Fasi 0 e 1 dettagliate (agent-ready); le Fasi 2 e 3 sono 27 abbozzi (needs-spec), dettagliati poco prima che inizino |
| Prima fase | le fondamenta | uno spike con dei benchmark e un go/no-go umano |
| Dove girano gli agenti | una sessione locale di Claude Code | un thread coordinatore e agenti nel cloud; il mio Mac per le scritture sulla board e i benchmark |
| Viste | 6 | 8, con l’aggiunta di una board Human needed e di un Model planner |
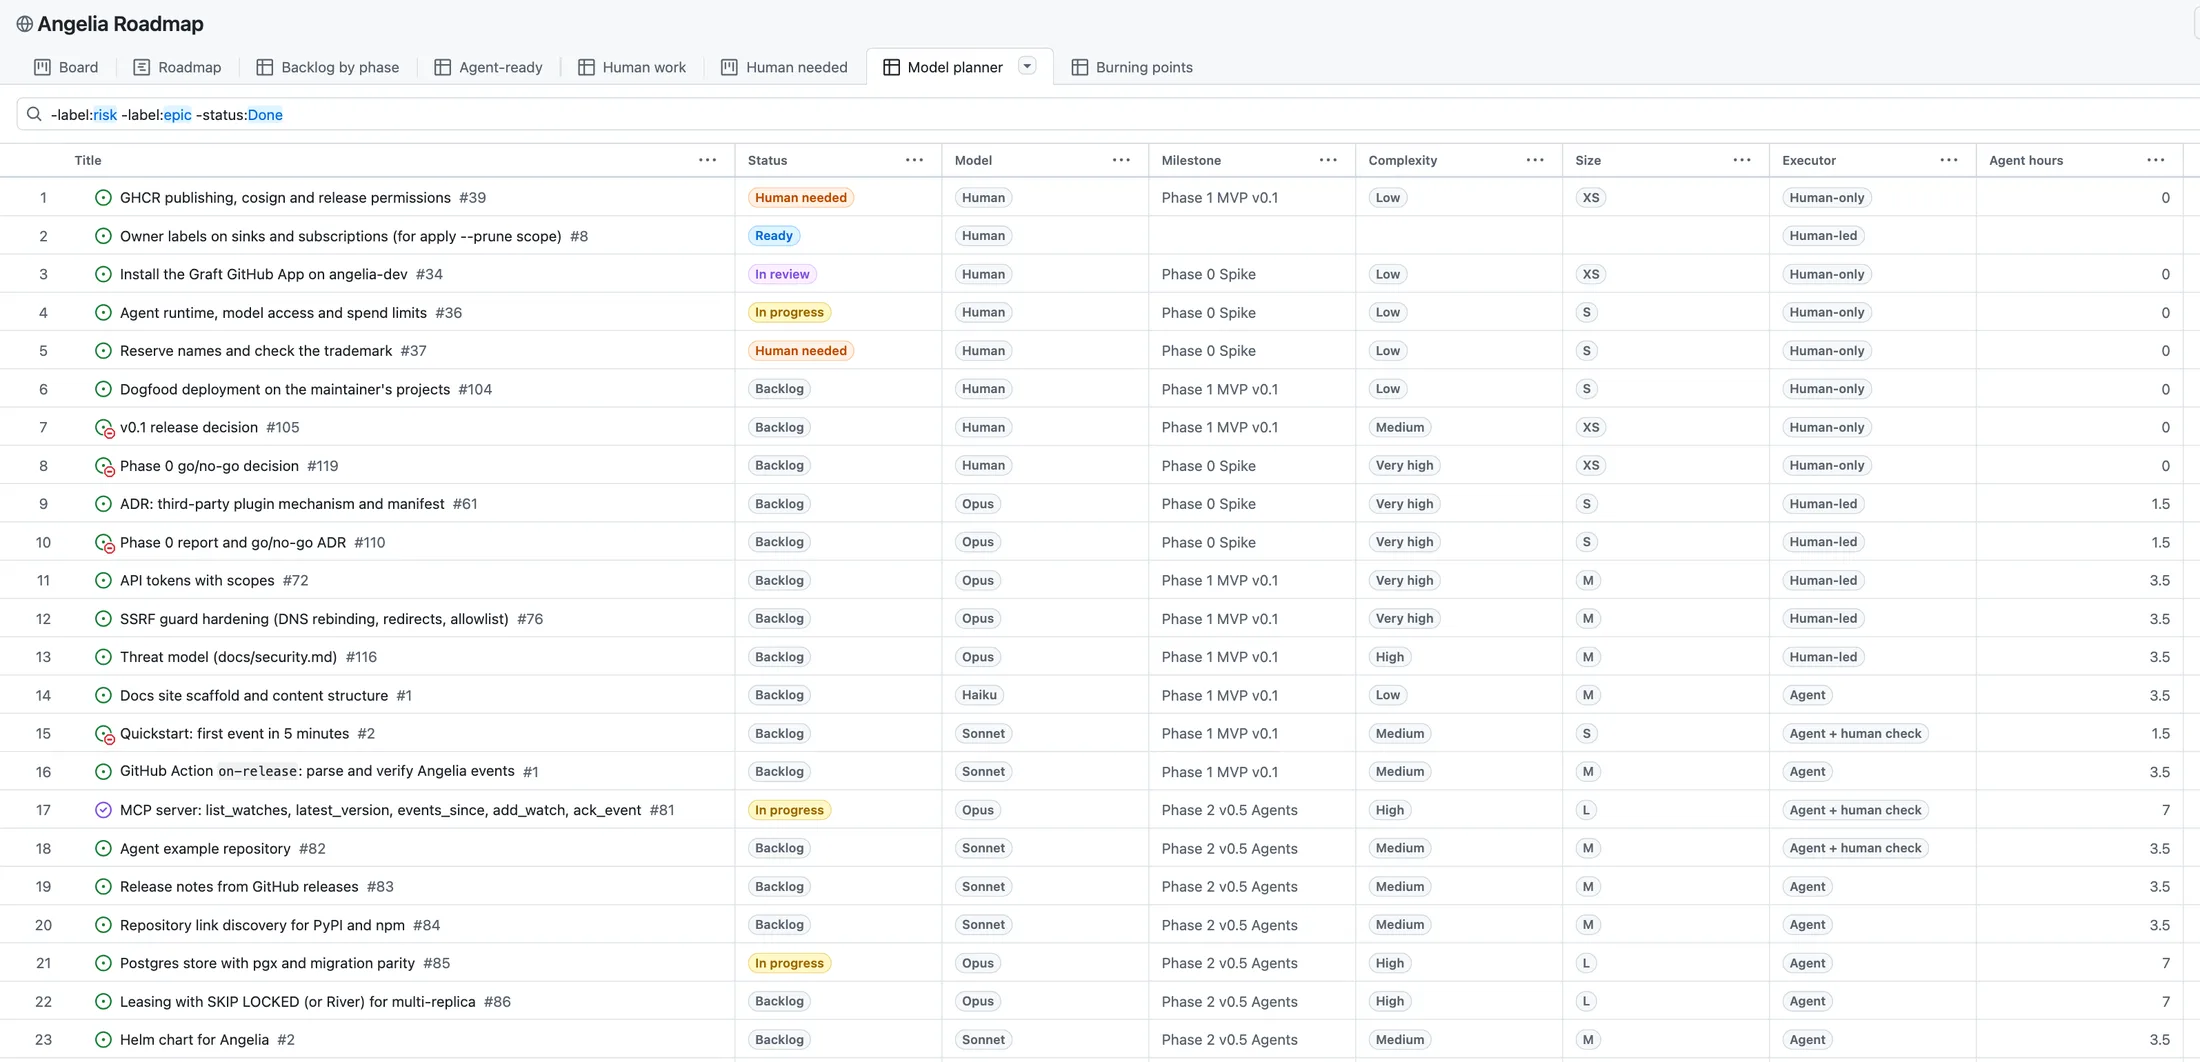
Cosa è successo#
Angelia è partito il 1° novembre con un solo messaggio: controlla la board, fai da coordinatore, costruisci ogni story in Ready con il modello indicato sulla sua card, fai la review con un altro agente, correggi, e fai il merge quando la CI è verde. 35 story chiuse il primo giorno. Al 13 novembre:
- 83 story finite: 55 delle 95 del backlog originale, più 28 aggiunte dagli agenti. La Fase 0 è a 32 su 38, la Fase 1 a 21 su 30, e la Fase 2 è iniziata.
- Release: v0.1.0 taggata il 10 novembre e v0.1.2 pubblicata il 12 novembre. La roadmap prevedeva l’MVP v0.1 per marzo 2027.
- Benchmark su hardware reale: i benchmark dello spike sono girati sul mio Mac, compreso uno che osserva 2.000 repository GitHub con un solo token. Un’esecuzione reale di 6,5 ore è stata interrotta da un riavvio di Claude Code e ha prodotto un report parziale.
E tre cose che non sono andate come previsto:
- La board si è disallineata. Il coordinatore non poteva scrivere direttamente sul progetto, quindi ha inoltrato 64 richieste di aggiornamento della board a una sessione di supporto sul mio Mac. Il 3 novembre ho scritto: “there is nothing on the board to approve. Where the PR/Issues concerned are?” La correzione è stata mettere ogni PR sulla board come card a sé, ed è per questo che la colonna Done conta issue e PR. L’agente che fa il lavoro deve poter aggiornare la board direttamente, altrimenti la board smette di essere la verità.
- La release è arrivata prima del go/no-go. La v0.1 è uscita, ma il report della Fase 0 e la decisione go/no-go (#110, #119) sono ancora in Backlog. Gli agenti sono andati più veloci delle mie scartoffie; la decisione formale deve recuperare.
- La stima non è stata ricalibrata. La griglia di Angelia dice ancora che una story M richiede 3,5 ore di agenti. In media ha richiesto 34 minuti. I dati di Horae c’erano; avrei dovuto usarli.
Le specifiche just-in-time hanno funzionato come speravo: gli abbozzi delle fasi successive vengono dettagliati solo adesso, dopo che lo spike ha risposto alle grandi domande. E il modello sulla card ha reso visibile il costo prima di ogni esecuzione: delle story cronometrate, 15 sono girate su Opus, 14 su Sonnet e 1 su Haiku.
10. L’ultimo miglio è umano#
Il 12 novembre ho chiesto all’agente principale di Horae: “What is the status of the horae-dev project? Are we able to finish and start to test?” Ha fatto girare Horae in locale su una copia pulita in pochi minuti. Poi gli ho chiesto di fare il deployment sul mio server di casa, dove giravano già Coolify, authentik, un tunnel Cloudflare, ntfy e Uptime Kuma.
Ci sono volute due serate, ed è lì che la CI verde ha incontrato la realtà:
- L’immagine del container su GHCR era privata, quindi il server non poteva scaricarla. GitHub non ha un’API per cambiarlo; ho dovuto cliccare io.
- Cloudflare bloccava l’health check dell’helper di LiveSync perché si identificava come
Python-urllib, e l’helper interpretava il 403 come credenziali sbagliate. - Coolify creava un file di configurazione montato vuoto e in sola lettura.
- Il database di LiveSync era bloccato sui miei due dispositivi, quindi il server veniva rifiutato come nuovo dispositivo.
- Ogni installazione di plugin falliva: i plugin prendevano l’SDK da un commit git, e l’installer di Horae giustamente rifiuta le sorgenti senza hash. La correzione è stata pubblicare l’SDK su PyPI, e per questo ho dovuto configurare io il trusted publisher.
- I pack non si potevano installare affatto: l’installer provava a costruire un ambiente Python per un plugin che contiene solo file. Era un vero bug, corretto nella #201.
- Il mio Obsidian desktop ha smesso di sincronizzare per un problema di DNS sul Mac.
Ciascuno di questi ha richiesto a un agente pochi minuti di diagnosi, una volta fatta la mia parte: accedere a Coolify e authentik nel pannello del browser, digitare i segreti, aggiungere l’hostname del tunnel, configurare PyPI, sbloccare cose in Obsidian, incollare comandi nel terminale del container, e guardare il mio telefono.
Alle 21:24 del 13 novembre ho scritto due parole nella sessione: “Phone rang.” Un task che avevo scritto in Obsidian sul desktop si era sincronizzato sul server, Horae l’aveva trovato e ntfy aveva mandato il promemoria al mio iPhone. Il prossimo è il brief del mattino, in attesa della #201.
Gli agenti hanno fatto settimane di lavoro in pochi giorni. Il primo vero deployment ha comunque richiesto un umano per ogni account, segreto, impostazione e dispositivo, e ha trovato bug che nessuna review e nessuna esecuzione della CI avevano visto.
11. Team da due pizze o team da un panino?#
La stima confrontava “un umano + agenti” con “tre sviluppatori”. Penso che il confronto più interessante riguardi la forma del team.
Il team da due pizze di Amazon (abbastanza piccolo da essere sfamato con due pizze, quindi da sei a dieci persone) è stato pensato per limitare la coordinazione. Anche così, otto persone hanno 28 canali di comunicazione tra loro (n(n−1)/2). Matt Ström-Awn scrive che l’idea si è trasformata in “team da due panini”, “lo stesso principio, ma con un team di due persone”. A luglio Business Insider ha raccolto lo stesso segnale da diversi leader del settore: il field CTO di Cursor dice che “due pizze sono troppa pizza”, il CEO di Coinbase parla di “team di una persona”.
Una board come questa è un hub, non una rete. Un umano parla con un agente principale, l’agente principale parla con gli agenti operativi, e questi non parlano mai tra loro. Con quattro agenti sono quattro canali, non 28. Non è un dettaglio: la ricerca sulla cooperazione tra agenti trova che agenti che si coordinano tra loro fanno nettamente peggio di un agente da solo, quindi l’hub è la forma giusta anche per gli agenti. L’analisi dei token di Horae dice la stessa cosa dal lato dei costi: più agenti in parallelo hanno significato più conflitti, non più velocità.
Cosa ne ricavo:
- L’unità di throughput ora sono le decisioni al giorno, non le righe di codice al giorno. La capacità decisionale di una persona è il tetto, e ora c’è un secondo tetto: la quota di utilizzo.
- Un team da due pizze diventa più team da un panino, ognuno responsabile di un prodotto con la propria board. È letteralmente quello che ho fatto con Horae e Angelia: due board, un umano, ognuna con i propri agenti. Ma non girano in parallelo come farebbero due team: condividono la mia attenzione e la mia quota, quindi in pratica ho alternato.
- Un team da un panino, due persone, è probabilmente il punto di equilibrio. Due persone raddoppiano la capacità decisionale con un solo canale in più, la board continua a muoversi quando una delle due è occupata, e una seconda persona rende le approvazioni di sicurezza della sezione 5 molto meno una formalità.
- I team da due pizze vincono ancora dove il lavoro è irriducibilmente umano e parallelo: review di sicurezza, reperibilità, conoscenza del dominio, il rapporto con gli utenti, i deployment su infrastruttura reale, e il bus factor. Un team da un panino con agenti ha un bus factor di uno o due.
Lo studio sul campo di Microsoft su Claude Code e Copilot CLI ha misurato circa il 24% di PR unite in più tra chi li ha adottati, in un’organizzazione che ha mantenuto la forma dei propri team. È un guadagno reale, ma niente a che vedere con quello che si vede quando il processo viene ricostruito intorno agli agenti. Sospetto che gran parte della differenza stia nella forma del team e nel processo, non nel modello.
12. Come provarlo a casa tua#
Se vuoi provarci sul tuo progetto, questo è il minimo che l’ha fatto funzionare, con quello che hanno aggiunto Angelia e il conto dei token:
- Scrivi il backlog con l’agente, validalo tu. Criteri di accettazione su ogni story. Dettaglia solo la fase successiva, o le due successive; lascia il resto come abbozzo.
- Aggiungi un campo Executor (Agent, Agent + human check, Human-led, Human-only) e una vista Agent-ready. Gli agenti devono sapere cosa saltare.
- Metti il modello sulla card: un campo Complexity e un Model suggerito che puoi cambiare.
- Descrivi le colonne. “Ready = specifica completa”, “Human needed = bloccata sul maintainer”. Le descrizioni sono il protocollo.
- Scrivi quando un agente deve fermarsi e chiedere: contratti pubblici, scelte di sicurezza, nuove dipendenze, specifiche ambigue, fallimenti ripetuti della CI.
- Metti una stima e una sezione Actuals in ogni story, e rendi il tempo una riga obbligatoria. Ricalibra dopo 15 story, e porta la calibrazione nel tuo progetto successivo.
- Parti con un agente per story e un’autoreview su checklist; aggiungi un revisore indipendente per la sicurezza e i contratti pubblici. Su quelli, chi scrive non approva mai.
- Fai della CI il cancello, e tieni al massimo due story in corso.
- Concorda il protocollo Human needed: domande numerate nella PR, risposte sulla PR, card di nuovo in Ready. Fai in modo che l’agente principale rilegga la board tra una story e l’altra, e lascia che aggiorni la board da solo.
- Chiedi una milestone alla volta, e aspettati degli stop.
- Fai presto il deployment. Un’istanza reale su un’infrastruttura reale trova quello che review e CI non trovano, e ha bisogno di te.
13. Per chiudere#
La stima diceva che sarei stato io il collo di bottiglia, e lo sono. Ma le ore che ci passo non sono nei diff. Sono nei ticket, prima che il codice esista, nelle domande a cui gli agenti non possono, e non devono, rispondere, nel decidere quando premere “continue”, e negli account, nei segreti e nei dispositivi del primo vero deployment. Tutto quello che succede tra questi momenti ora richiede minuti, o qualche giorno per un intero progetto.
Scrivete bene i ticket. Lasciate guidare la board. Tenete umane le decisioni.
Link#
- 🗂️ Horae Roadmap: la board pubblica, con tutte le sue viste
- 📦 horae-dev/horae: il codice,
docs/ESTIMATION.mdedocs/ROADMAP.md - 🗂️ Angelia Roadmap e angelia-dev/angelia: la seconda board, con
docs/ESTIMATION.md,AGENTS.mde la release v0.1.2 - 🎬 Il video a pagina intera, fatto con canvas-video-skill
- 📖 Sei settimane in una notte: l’esperimento precedente, con Graft
Fonti: METR, Time Horizon 1.1 (gen. 2026) · METR, uplift update (feb. 2026) · Anthropic, When AI builds itself (aggiornato a set. 2026) · Murphy-Hill, Butler e Savelieva, gli agenti di coding da riga di comando in Microsoft (lug. 2026) · Team .NET, dieci mesi con il coding agent di Copilot (mar. 2026) · CodeRabbit, codice IA contro codice umano (dic. 2025) · Report GenAI 2026 di Veracode · Matt Ström-Awn, High-agency strategy · Business Insider, i giorni delle due pizze sono finiti (lug. 2026) · Risultati di CooperBench