Ho chiesto a un agente di bloccarmi due ore di concentrazione nel calendario di domani. Ha funzionato. Ci sono voluti 4 turni, 114.000 token, 14 secondi e 0,19 $. Poi l’ho chiesto di nuovo, con esattamente le stesse parole e lo stesso calendario, e ha prenotato un altro slot. Tre esecuzioni, tre risposte: 13:00, 14:00, 13:00.
Lo script che lo stesso agente ha scritto per lo stesso lavoro prenota le 12:30. Ogni volta. Gratis.
Questo articolo parla di quella differenza. Non di “l’IA è il male” (la uso tutti i giorni e quasi tutti i miei progetti recenti li ho scritti con Claude Code), ma di un’abitudine che vedo crescere intorno a me, e in me: stiamo sostituendo un’automazione economica, deterministica e scritta una volta con conversazioni costose, non deterministiche e pagate ogni volta. La mossa migliore è usare l’IA per costruire l’automazione, e poi toglierla dal giro.
1. Da “fallo” a “chiedi a un agente di farlo”#
Per molto tempo il lavoro ripetitivo è passato da tre fasi. Prima clicchi. Poi, quando hai cliccato abbastanza volte sulla stessa cosa, scrivi uno script, una dashboard, un cron, una piccola applicazione. Lo script è noioso, fa una cosa sola e non costa nulla eseguirlo.
Adesso c’è una terza opzione, ed è molto allettante: chiedi. “Trova uno slot per tutti e sei la settimana prossima.” “Com’è andata ieri?” “Bloccami due ore domani.” L’agente legge i calendari, interroga il database, fa i conti e ti scrive un bel paragrafo.
È lì che il settore sta spingendo. In un sondaggio IEEE pubblicato a novembre 2025, il 52% dei responsabili tecnologici si aspettava che l’IA agentica raggiungesse un’adozione di massa, o quasi, tra i consumatori nel 2026 come “assistente personale, pianificatore o gestore del calendario di famiglia”, al primo posto della lista. È una previsione, non un uso misurato, ma dice dove stanno andando i soldi. Google ha aggiunto a Calendar i suggerimenti di orario delle riunioni con Gemini, anche se la semplice griglia “Trova un orario” faceva già quasi tutto il lavoro.
Niente di male in tutto questo per una domanda occasionale. Il problema comincia quando la stessa domanda torna ogni mattina.
2. Il conto: token più economici, fatture più grandi#
Il prezzo dei token scende ogni anno. Le fatture no. Un lavoro agentico richiede molte chiamate al modello dove una chat ne richiede una, e ogni turno rimanda un contesto che cresce. Alcuni fornitori stimano da 10 a 30 chiamate per lavoro, che cicli e nuovi tentativi moltiplicano ancora (stime di fornitori, ma le mie misure più sotto arrivano nello stesso punto).
Alcune aziende l’hanno scoperto a proprie spese nel 2026:
- Uber. Ad aprile, The Information ha riportato che il CTO, Praveen Neppalli Naga, aveva detto che il budget IA dell’intero anno era finito pochi mesi dopo l’inizio: “the budget I thought I would need is blown away already”. La cifra non è mai stata resa nota. A giugno, Bloomberg ha riportato, con la conferma di un portavoce, un tetto di 1.500 $ al mese di token per ogni strumento di coding agentico, per dipendente, con la possibilità di chiederne di più.
- Tokenmaxxing. Meta aveva una classifica interna del consumo di token (“Claudeonomics”), con oltre 85.000 dipendenti e circa 60.000 miliardi di token in 30 giorni. Qualcuno lasciava girare gli agenti per ore per scalarla. È stata chiusa nel giro di pochi giorni (Meta ha citato fughe di dati verso l’esterno, non i trucchi). In Amazon una classifica non ufficiale è stata messa offline e l’azienda ha detto che il numero di token non conterà nelle valutazioni. Salesforce non aveva una classifica, ma ha fissato obiettivi minimi di spesa settimanale su Claude Code e Cursor, prima di criticare pubblicamente il tokenmaxxing.
- Il problema della misura. Nel LeadDev AI Impact Report 2026, il 58% dei rispondenti dice che la propria organizzazione misura l’impatto dell’IA in base al consumo di token, e il 57% dice che questa misura non funziona. Solo il 19% pensa che il tokenmaxxing sia efficace.
Quando la metrica è “token spesi”, fare la stessa domanda ogni giorno sembra produttività.
3. L’altro conto: noi#
C’è un secondo costo, più difficile da misurare, e voglio essere prudente perché è facile esagerarlo.
Uno studio di Microsoft Research e Carnegie Mellon (CHI 2025, 319 knowledge worker, 936 esempi reali) ha trovato che, nella maggior parte degli esempi, le persone avevano la sensazione che l’IA generativa riducesse lo sforzo di pensiero critico, e che una maggiore fiducia nell’IA fosse associata a meno pensiero critico. È tutto auto-dichiarato. (In giro vedrete citato un “62%”. Nell’articolo non c’è.) Lo studio del MIT Media Lab “Your Brain on ChatGPT” parla di “debito cognitivo” a partire da EEG su 54 partecipanti, ma è un preprint e solo 18 persone hanno fatto l’ultima sessione.
Quindi non costruisco l’argomento su questo. Ma riconosco la sensazione: quando la risposta è a un prompt di distanza, smetto di sapere come viene calcolato il numero. Uno script che hai scritto (o rivisto) è una definizione che capisci. Un paragrafo che cambia ogni mattina, no.
4. L’ho misurato#
Non ho trovato nessuno che avesse messo un numero su “fare la stessa domanda ogni giorno”. Ci sono buoni articoli d’opinione: TechTarget sul perché una dashboard che leggi in 30 secondi batte una chat, incident.io su un LLM che “tira a indovinare” la definizione delle tue metriche e dà un numero diverso in giorni diversi. Ma nessuna misura. Così le ho fatte io.
Il setup#
Tre lavori quotidiani, con dati di test generati (nessun calendario vero, nessun dato aziendale):
- Blocca-concentrazione. “Bloccami 2 ore di concentrazione domani.” Un calendario, orari di lavoro, riunioni esistenti.
- Domanda KPI. “Com’è andata ieri?” Un database SQLite con 90 giorni di ordini, iscrizioni e incidenti, dove ieri è stata una brutta giornata, apposta.
- Cerca-slot. Sei persone in quattro fusi orari, due settimane di riunioni, e il cambio dell’ora del 25 ottobre nel mezzo.
Ogni lavoro è passato da claude -p --output-format json (Claude Code 2.1.284, Claude Sonnet 5.5) in uno spazio di lavoro pulito e vuoto, con solo i dati di test, in tre modi:
- ask: l’agente fa il lavoro, come lo faresti ogni mattina;
- build: l’agente scrive uno script per il lavoro, una volta sola;
- residual: la piccola chiamata al modello che resta dopo lo script, se c’è. Per la dashboard KPI, un prompt di circa 100 token solo quando una metrica esce di 3σ. Per il cerca-slot, una chiamata per pesare le preferenze morbide (“Chen preferisce la mattina”).
14 esecuzioni in tutto, 1,52 $ a prezzo di listino.
I numeri#
| Lavoro | Chiederlo all’agente, per esecuzione (cache fredda) | Fargli scrivere lo script, una volta | Quello che resta per un modello dopo |
|---|---|---|---|
| Bloccare 2 ore di concentrazione | 0,185 $, 114k token, 4 turni, 14 s | circa 0,23 $ | niente |
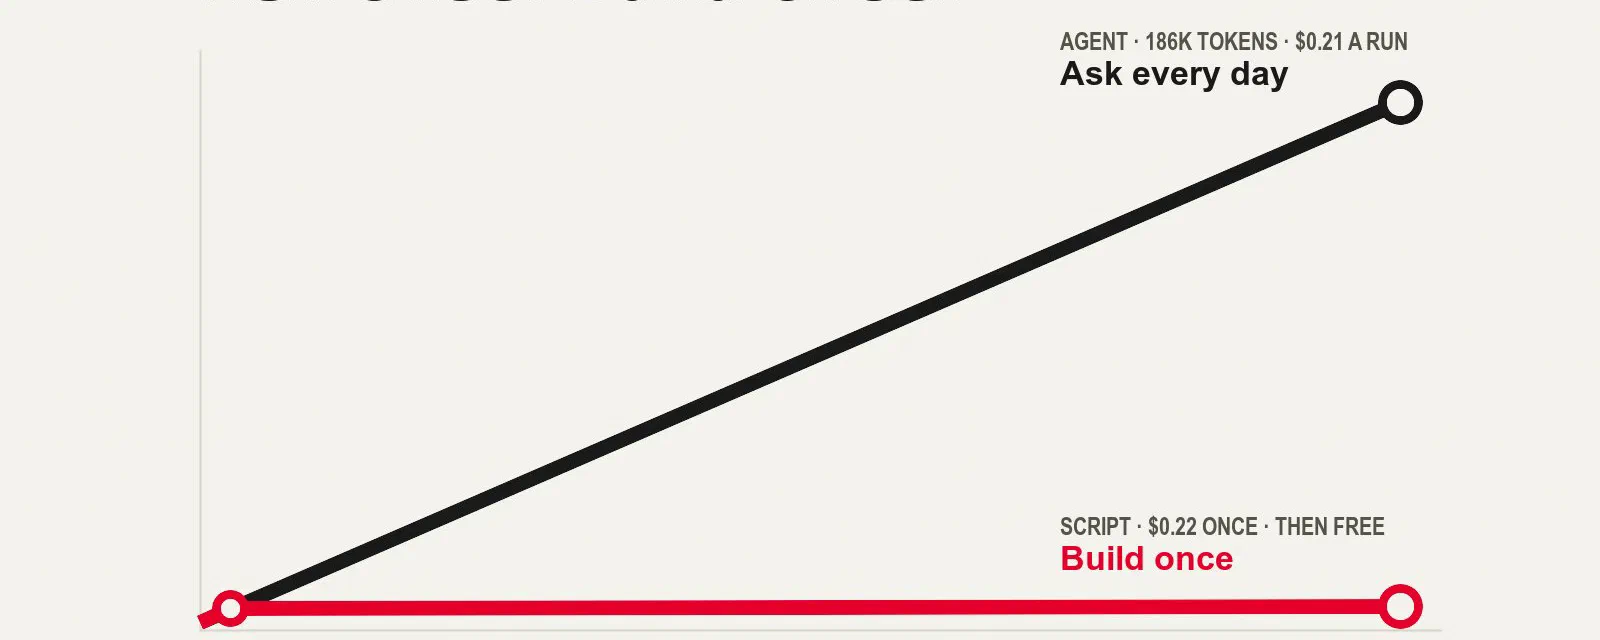
| “Com’è andata ieri?” | 0,208 $, 186k token, 5–6 turni, 24 s | circa 0,22 $ | 0,013 $ (3k token), solo nei giorni di anomalia |
| 6 persone, 4 fusi, trovare uno slot | 0,254 $, 266k token, 7–8 turni, 38 s | circa 0,22 $ | 0,022 $ (4k token) per riunione |
I “token di contesto” sono l’input più le letture dalla cache: quello che il modello elabora davvero. “Fredda” vuol dire la prima esecuzione dell’ora, che deve scrivere circa 32k token di contesto di Claude Code nella cache del prompt. Una domanda fatta una volta al giorno paga il prezzo a freddo ogni giorno. Ripetuta entro l’ora, la stessa domanda costa circa tre volte meno (da 0,06 a 0,12 $), ma non è così che funziona una domanda quotidiana.
Cosa mi porto via da questa tabella:
1. Costruire costa più o meno una domanda. Scrivere lo script è costato da 0,22 a 0,23 $, quanto chiedere una volta. Dal secondo giorno lo script è in vantaggio. Per un lavoro quotidiano non esiste il “non vale la pena automatizzarlo”.
2. Le risposte cambiano. Questa è stata la sorpresa. Le tre esecuzioni identiche del blocca-concentrazione hanno prenotato 13:00, 14:00 e 13:00. Lo script prenota le 12:30 ogni volta. Le tre esecuzioni di “com’è andata ieri?” hanno scelto ciascuna il proprio titolo: “gli ordini pagati sono calati di circa la metà”, “ordini in calo di circa il 37%”, “circa il 40% sotto la norma”. Tutte e tre difendibili. Nessuna uguale. E tutte e tre hanno riportato un fatturato che include gli ordini falliti (2.879 €), mentre la dashboard riporta il fatturato pagato (2.159 €). È il “numero diverso in giorni diversi” di incident.io, misurato.
3. Sul lavoro difficile l’agente aveva ragione. Voglio essere corretto. Tutte e tre le esecuzioni del cerca-slot hanno trovato gli stessi sei slot validi dello script, attraverso il cambio dell’ora. L’agente non sbaglia. È solo 12 volte più caro dello script più una piccola chiamata, e paga quel prezzo ogni volta.
4. Gran parte del conto è l’imbracatura. Mandare “rispondi ok” a Claude Code con gli strumenti attivi costa 34.499 token di contesto (0,138 $ su Sonnet). È il prompt di sistema, le definizioni degli strumenti, l’ambiente. Le mie chiamate residue, con gli strumenti disattivati (--tools ""), costano da 3.000 a 4.000 token. Quando “chiedi e basta” a un agente, la maggior parte di quello che paghi non è la tua domanda. (Ho già scritto di questo costo fisso, per i server MCP e per MCP contro una CLI, in inglese: una CLI che il modello conosce già costa 0 token di schema, un server MCP nativo circa 3.000 per prompt.)
5. Rivedi quello che costruisce. Lo script cerca-slot scritto dall’agente ha trovato sette slot, non sei: avanza a passi di 15 minuti invece di 30. Non è un bug, è una scelta diversa. Ma è esattamente il motivo per cui lo script lo leggi una volta. Lo rivedi una volta, invece di fidarti di un paragrafo nuovo ogni mattina.
Su un anno#
Prendiamo la domanda KPI, fatta da un team di 20 persone ogni giorno lavorativo. Sono 4.400 esecuzioni all’anno. Solo in token, su Sonnet, chiedere costa circa 850 $. La dashboard più le chiamate sulle anomalie costano circa 0,36 $.
Ma i token non sono il costo vero, quindi contiamo le persone a 60 $ l’ora (stima mia, cambiatela). La dashboard richiede circa un’ora di revisione e due ore di manutenzione all’anno: circa 180 $. Chiedere, una volta contati i 25 secondi che ognuno aspetta la risposta, sale a circa 2.700 $. Sono calcoli miei a partire dalle esecuzioni misurate, non misure su un team vero.
Ho fatto un piccolo calcolatore per metterci i vostri numeri: Ask once or build once? Il calcolatore (in inglese). I preset sono le esecuzioni misurate qui sopra. Cambiate la dimensione del team, il modello, la tariffa oraria, e spuntate “count waiting and review time” per vedere dove si incrociano le due curve.
5. Dove l’IA si guadagna i suoi token#
Niente di tutto questo vuol dire “smettete di chiedere”. Alcuni lavori meritano un agente ogni volta:
- Nuovi: non l’hai mai fatto e non lo rifarai. Leggere 40 contratti una volta per trovare la clausola insolita.
- Disordinati: gli input cambiano forma ogni volta. Una causa radice attraverso tre sistemi che non hai mai messo in relazione.
- Esplorativi: il primo sguardo a un dataset, prima di sapere qual è la domanda giusta.
- Giudizio in prosa: spiegare un’anomalia a una persona, pesare “Chen preferisce la mattina” contro “Dana è in ferie venerdì”.
Il cerca-slot è l’esempio onesto. L’agente ha fatto giusto, tutte e tre le volte. La domanda non è se ne è capace, ma se deve farlo ogni volta. Fusi orari, disponibilità e orari di lavoro sono aritmetica. Le preferenze morbide sono giudizio. Separale, e il modello riceve solo i 4.000 token che gli servono.
6. La mossa che manca: usare l’IA per togliere l’IA dal giro#
È l’abitudine che sto cercando di prendere: quando mi accorgo che sto facendo di nuovo la stessa domanda, chiedo all’agente un’ultima volta, ma lo script.
È anche quello che stanno scoprendo quelli che costruiscono questi strumenti:
- In “Code execution with MCP”, Anthropic mostra che lasciando all’agente scrivere codice che usa gli strumenti, invece di chiamarli uno per uno, un workflow è passato da 150.000 token a 2.000, un risparmio del 98,7%.
- Il “Code Mode” di Cloudflare espone tutta la sua API in due strumenti e circa 1.000 token, contro 1,17 milioni per un server MCP classico equivalente.
- Tomasz Tunguz scrive che il 65% dei nodi dei workflow del suo agente gira come codice senza IA, su 14 dei suoi workflow in produzione.
- Aleksei Spinov ha misurato uno scraping di 12 pagine a circa 0,165 $ con un ciclo di agente, e 0,014 $ con un crawler deterministico. Michael Tuszynski fa girare più di 30 job pianificati e solo tre usano un agente.
Il mio caso: ai-email-assistant#
Il progetto che ho pubblicato la settimana scorsa, ai-email-assistant, applica questa idea dall’inizio alla fine, quindi lo uso come esempio.
Costruito dall’IA. Tutti i 15 commit sono co-firmati da Claude Opus 5.5, scritti in una serata. Circa 2.000 righe di Python semplice, nessuna dipendenza a runtime, 125 test offline. Il codice l’ho rivisto; non l’ho scritto io.
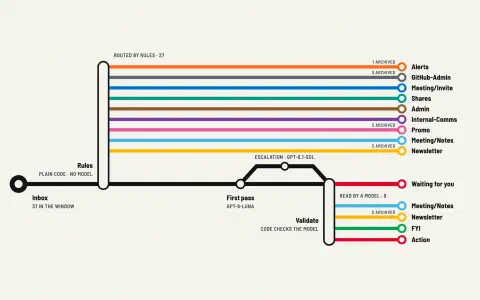
Eseguito dal codice. Ogni ora, nei giorni lavorativi, un job launchd applica le regole Gmail (vince la prima che corrisponde), le pulizie, una cache del giorno e la validazione di ogni risposta del modello. Le scadenze sono calcolate dal codice. Il registro per annullare è codice. Se regole e cache sistemano tutto, nessun modello viene chiamato.
Al modello restano gli avanzi. Solo la posta che nessuna regola sa collocare va a Claude Haiku 5.5, a lotti, con i metadati e un estratto di 240 caratteri. Solo quello su cui Haiku non è sicuro va a Sonnet. E anche le skill IA incluse nel progetto hanno un solo compito: proporre regole deterministiche. L’IA scrive le regole una volta, codice semplice le applica ogni ora.
Cosa cambia? Ecco la mia stima, costruita a partire dal costo fisso misurato del progetto (non da un mese di uso reale, che ancora non ho): una sessione di agente a ogni esecuzione con un modello di classe Sonnet pagherebbe almeno i ~17k token di contesto della CLI ogni ora, circa 11,60 $ al mese anche con la casella vuota. L’approccio ibrido costa tra 0 e circa 2,50 $ al mese. Gran parte del risparmio non viene da chiamate più economiche, ma dalle esecuzioni che non fanno nessuna chiamata.
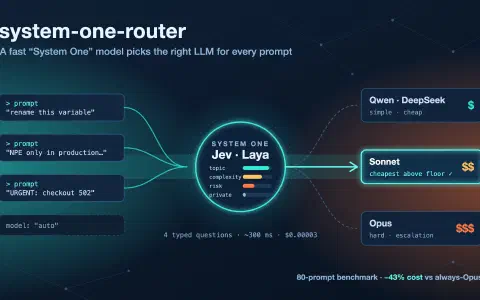
Lo stesso schema c’è negli altri miei progetti: system-one-router sceglie un modello con un modello decisionale tipizzato e un po’ di aritmetica invece di chiedere a un LLM di fare da router (il riferimento “LLM come router” costava circa 4,6 volte di più per decisione, con un’accuratezza simile), e leanproxy fa ricerca, proiezione e troncamento nel codice prima che qualcosa arrivi nel contesto. Ed è il tema intorno a cui giravano i miei articoli precedenti su un RAG locale per gli assistenti di programmazione e su un harness di strumenti per gli agenti (in inglese).
7. La regola: chiedi una volta, costruisci una volta, esegui per sempre#
Ecco la checklist che uso adesso. Trasforma un prompt in codice (uno script, una dashboard, una regola, un cron) quando almeno due di queste affermazioni sono vere:
- Ho fatto essenzialmente la stessa domanda 3 o più volte.
- Gli input vengono dalle stesse fonti ogni volta (stesso database, stessi calendari, stessa casella).
- La risposta giusta è definibile: una metrica, una regola, un formato, una soglia.
- Mi serve la stessa risposta ogni volta, per coerenza, confronto nel tempo o audit.
- Gira su una pianificazione o un evento, non per capriccio.
- Il risultato serve anche ad altre persone.
Tienilo come prompt quando il lavoro è nuovo, ambiguo, trasversale o davvero occasionale.
E quando lo costruisci, dai ogni parte del lavoro a chi deve farla:
| Parte del lavoro | Chi la fa |
|---|---|
| Recuperare, filtrare, unire, fare i conti, gestire i fusi orari | il codice |
| Soglie, pianificazioni, “è normale?” | il codice |
| Spiegare un’anomalia, pesare preferenze morbide, scrivere per una persona | un modello, con qualche centinaio di token di contesto preparati dal codice |
| Scrivere e aggiornare il codice stesso | un modello, una volta, poi lo rivedi tu |
Trova i tuoi prompt ripetuti#
Ho scritto un piccolo script che legge la tua cronologia locale di Claude Code e raggruppa i prompt che continui a fare, senza nessuna chiamata a un modello. Sulla mia ha trovato 253 prompt umani, di cui il 13% in gruppi ripetuti su due o più giorni. Il gruppo più grande, 28 volte, era un prompt standard del tipo “rivedi questa modifica cercando vulnerabilità” lanciato in automatico. Claude Code tiene solo le trascrizioni recenti, quindi sono poche settimane, non un anno. Ma mi è bastato per vedere quali avrebbero già dovuto essere script.
8. Limiti onesti#
- Tre lavori, dati sintetici, un solo modello. I dati di test sono inventati e generati. Calendari e database veri sono più disordinati, il che di solito rende l’agente più caro, non meno.
- Campioni piccoli. Tre esecuzioni per “ask”, una per “build”. Abbastanza per mostrare la variabilità, non abbastanza per fare statistica.
- Prezzi di listino del 15 ottobre 2026. Abbonamenti, sconti e prezzi batch cambiano i dollari, non i rapporti. Ricontrollateli prima di citarli.
- I numeri mensili di ai-email-assistant sono stime. Gli unici dati su una casella vera vengono da una sola prova a secco su una casella personale tranquilla. Una settimana di log d’uso reali su una casella piena darebbe un numero molto migliore.
- Il costo annuo del team dipende dalle mie ipotesi: 20 persone, 220 giorni lavorativi, 60 $ l’ora, 25 secondi di attesa. Il calcolatore vi permette di sostituirle tutte.
- Anche gli script hanno un costo. Si rompono quando un’API cambia, e qualcuno deve occuparsene. Ho contato due ore di manutenzione all’anno; da voi potrebbe essere diverso.
9. Per chiudere#
L’IA è un fantastico compilatore di intenzioni in strumenti. Dille cosa vuoi, rivedi quello che scrive, e ottieni uno script che risponde alla stessa domanda nello stesso modo, per sempre, gratis. È il miglior uso dei token che ho trovato quest’anno.
Quindi il mio consiglio: tratta un prompt ripetuto come un “code smell”. La terza volta che scrivi la stessa domanda, chiedi all’agente un’ultima volta, ma lo strumento. Poi prova il calcolatore con i tuoi numeri, e dimmi dove si incrociano le tue curve.